人工智能资讯 第15页
聚合当前分类下的最新内容,按时间顺序查看第 15 页精选文章。
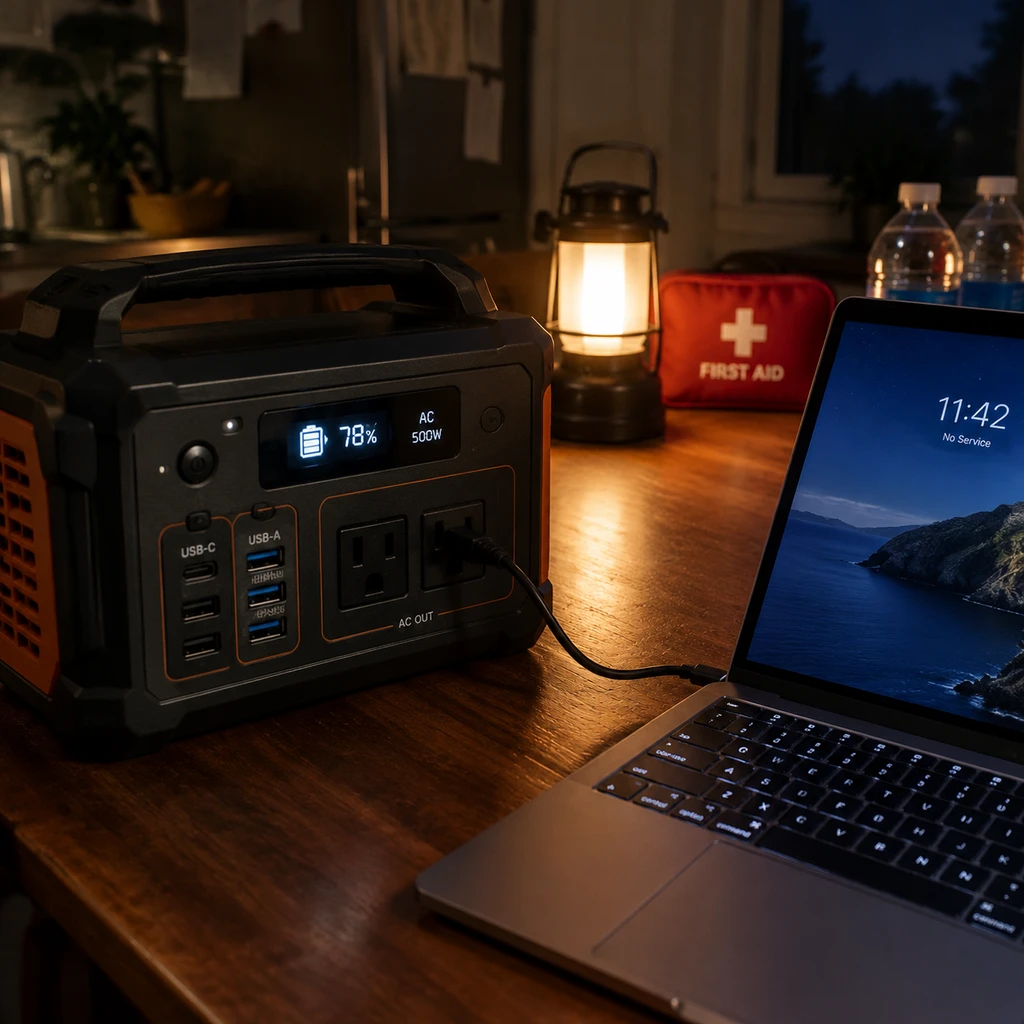
Survival LLM 打包 93 万篇急救与维修指南,16GB 电脑离线准确率仅 55%
开源项目 Survival LLM 将 93 万篇维基百科与权威急救手册同本地大模型打包,主打断网环境下的开箱即用。但底层测试暴露出小模型高达近半的错误率甚至致命建议,证明极端环境下 AI 只能做自然语言目录,真正救命的仍是旁边高亮的静态原文。
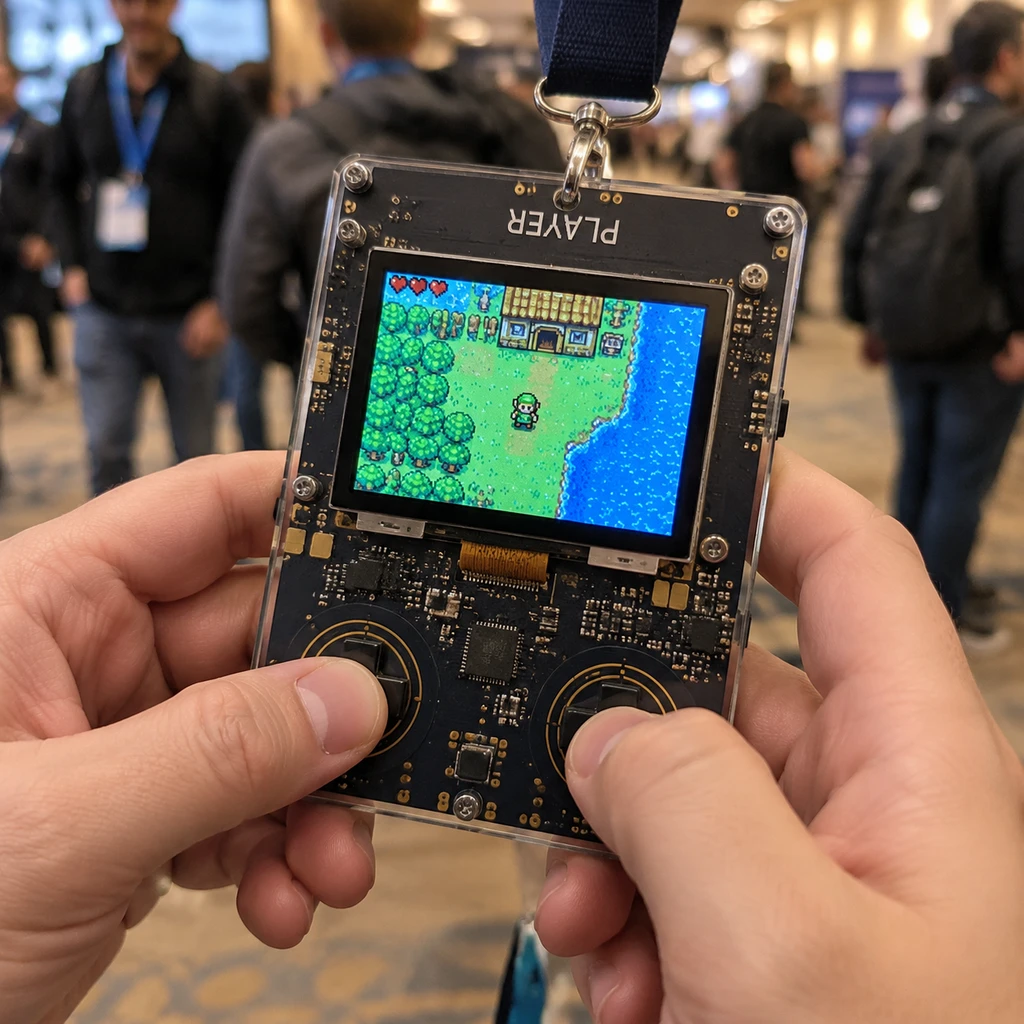
GitHub Universe 胸牌靠 Gemini 4 跑 Game Boy Color:230 MHz 不刷机的极限压榨
在 GitHub Universe 2026 大会上,参会者 Steve Francia 借助 Gemini 4 Argon 模型,在基于 RP2350B 芯片的大会电子胸牌上用 MicroPython 跑通了 NES 与 Game Boy Color 模拟器。这一项目打破了微控制器跑模拟器必须用 C 语言重刷固件的惯例,证明 AI 辅助的寄存器级优化已能让脚本语言在 230 MHz 的受限硬件上跑进 16.6 ms 的帧率红线。
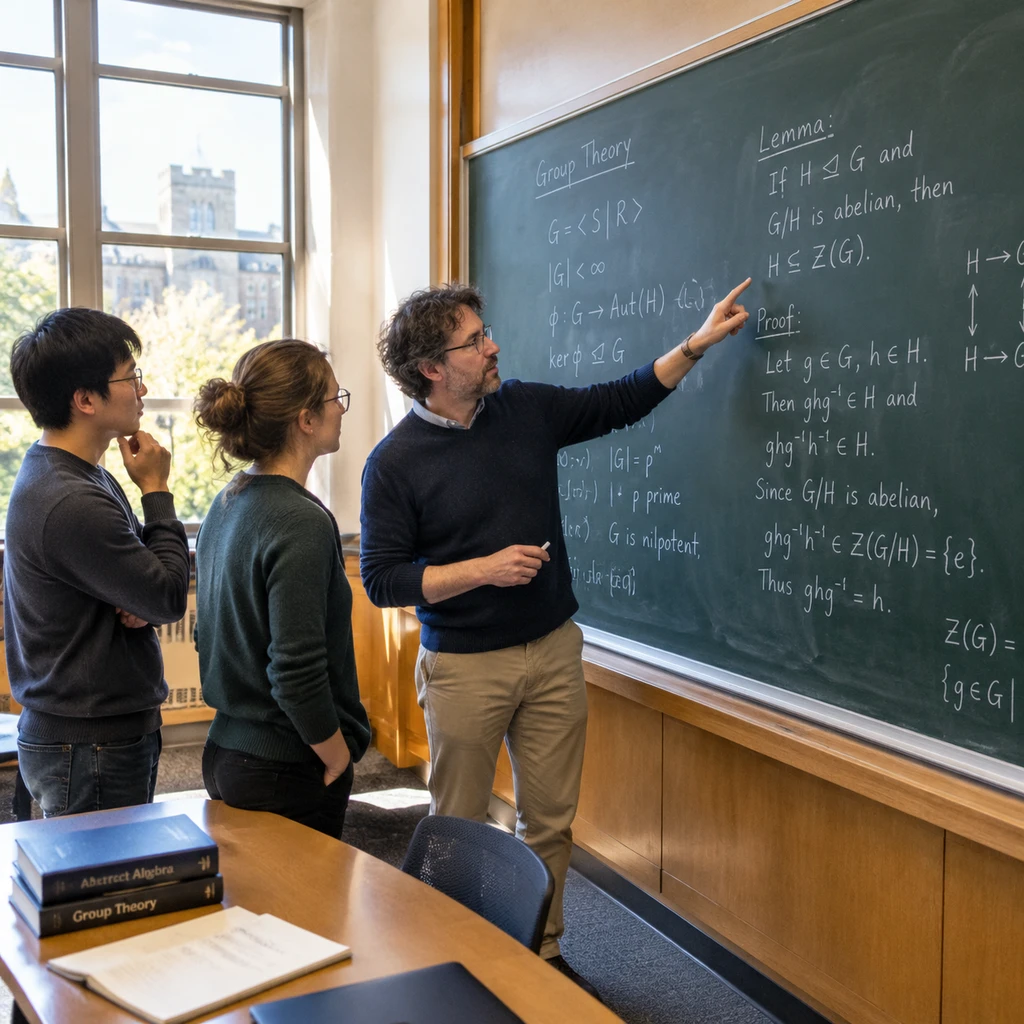
Axiom Math 耗时24天用4310万行 Lean 代码形式化有限单群分类定理
Axiom Math 联合 31 位研究者,通过 AI 智能体在 24 天内用 4310 万行 Lean 代码完成了有限单群分类定理(CFSG)的第一代证明形式化,并顺手揪出 1986 年经典论文的一处反例。但这套零 sorry 的庞大工程目前仍处于自评状态,AI 把数学最难的担子从证明推导转移到了人类对顶层定义的审计上。
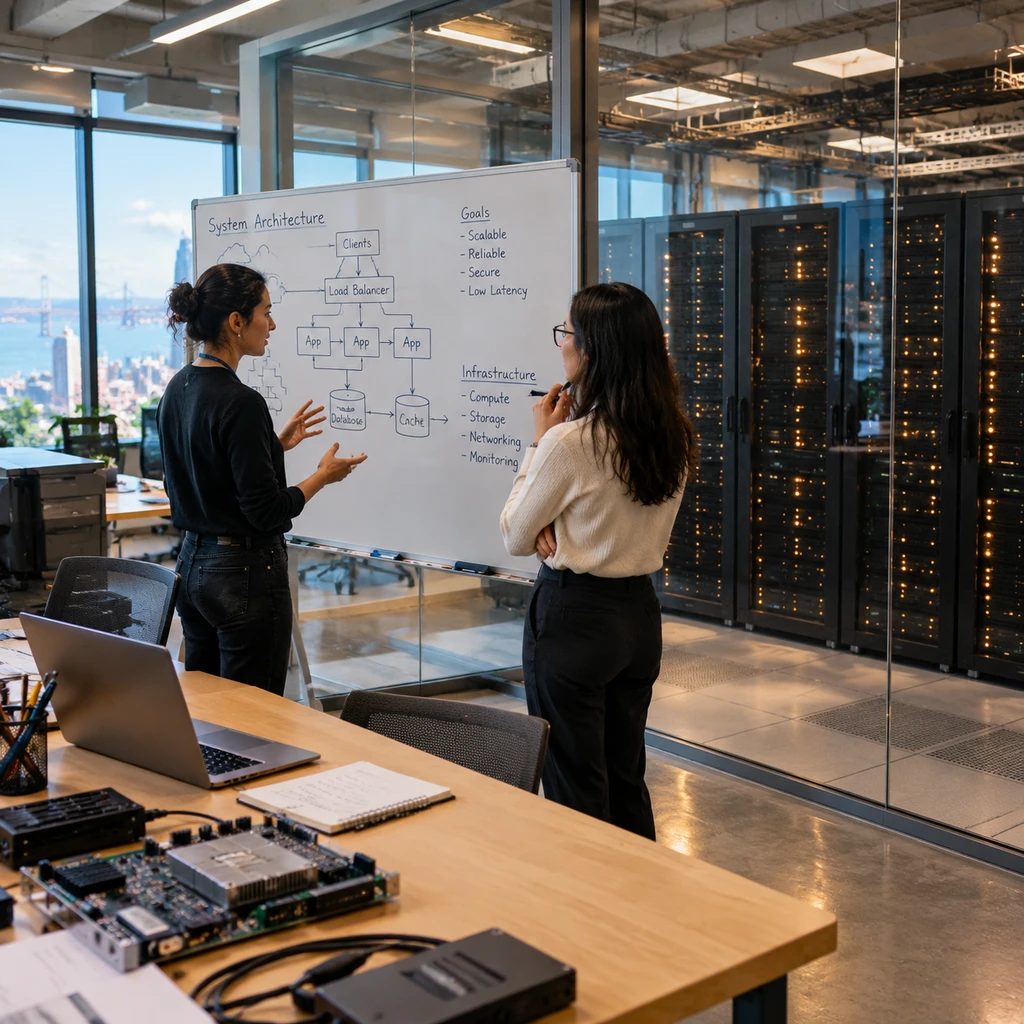
Claude Opus 5.5 降价 40% 却引账单暴涨,Anthropic 162 亿营收的防线
Anthropic 在提交 S-1 招股书次日拆解了 Claude Opus 5.5 与 Managed Agents 的底层架构。半年 162.86 亿美元营收背后,依然躺着 6.93 亿美元的 GAAP 营业亏损。为了防推理蒸馏并压低基建成本,Anthropic 一边靠强制保留思维块锁死 API 规则,一边把智能体拆成持久化大脑与临时沙盒双手。
Liquid AI 发布 LFM3 1.7B 全模态家族,4-bit 仅占 1GB 却主动劝退复杂推理
Liquid AI 于 2026 年 10 月 27 日推出 2B 级别的 LFM3 基础模型家族,涵盖文本、视觉、音频、全模态及校准回答共 6 款模型。尽管官方主打 4-bit 下约 1GB 体积与 256K 上下文,但模型卡明确劝退复杂推理与编程,且多模态上下文大幅缩水,说明它并非端侧全能小钢炮,而是依赖单卡微调的垂直任务底座。
OpenAI 与 Oracle 扩大合作推 AI Workspace,送 1.2 万美元额度抢 ERP 入口
OpenAI 与 Oracle 于 2026 年 10 月 27 日宣布将 Fusion、NetSuite 等核心企业应用接入 ChatGPT,并推出包含每年 1.2 万美元云额度的中小企业套餐。相比尚未定档的四款新产品,真正致命的商业杀招是允许美国企业直接用 Oracle 预付通用额度采购 OpenAI 全家桶,绕开繁琐的新增预算审批,在微软与 Salesforce 之外撕开企业后台入口。
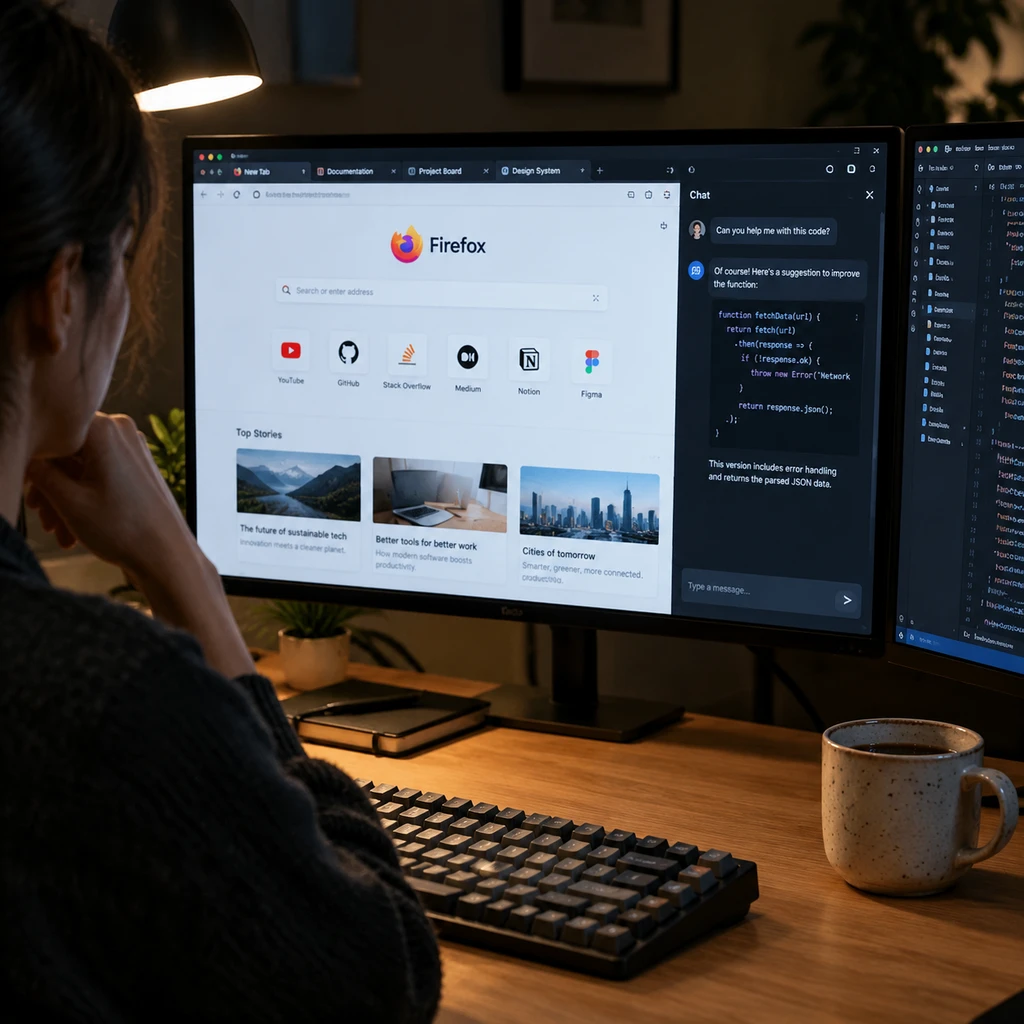
Firefox 150 上线 Smart Window:Gemini 3.1 填表、Qwen 盯网页背后的隐私妥协
Mozilla 在 Firefox 150 的 Smart Window 测试版中免费推出跨标签页填表和网页监控功能,正面对标收费 $19.99/月起的 Chrome 与 Perplexity。但拆开底层路由会发现,哪怕用户配置了自定义模型,填表和监控仍会强制发往 Google Gemini 3.1 Flash Lite 与阿里 Qwen,揭开了独立浏览器在 AI 时代的信任边界悖论。
Google 发布 Genie 4 世界模型,2 分钟实时模拟背后藏着 7.84 美元一局的账单
2026年10月27日,Google DeepMind 发布世界模型 Genie 4 研究预览版,新增实时音频生成与文本实时操控,场景一致性延长至两分钟。但相比前代与竞品 Runway GWM Worlds 2,Google 罕见隐去了分辨率与帧率参数;其主打的机器人仿真演示实为文本提示词驱动的视觉渲染,距离真正的物理控制还有巨大的精度与成本鸿沟。
Ai2实测GPT-5.4与Claude Opus 4.6,改提示词让科研新颖性准确率暴跌52.6%
艾伦人工智能研究所(Ai2)发布基准测试,评估GPT-5.4、Claude Opus 4.6等6款大模型评判科研点子新颖性的能力。结果显示,提问方式从揣摩审稿人改为直接判断原创性,会让GPT-5.4准确率从93.5%暴跌至40.9%,且耗资82美元的专用评估系统表现不如2.59美元的简单提示基线。大模型目前更擅长迎合学术审稿品味,而非识别真正的科学未知。
Metis Reasoning 用 AlphaGo 棋盘治大模型幻觉却零实测数据
前 DeepMind 核心研究员 Thore Graepel 创立 Metis Reasoning,提出用显式知识账本和独立验证模块取代大模型权重黑盒,试图从根源解决幻觉。但这套借鉴 AlphaGo 2016 年第 37 手的方案目前仅是一份零实验数据的理论白皮书;把树搜索搬进开放现实时,最大的死穴是现实世界根本没有自动判输赢的围棋裁判。
OpenCode 配 Qwen3.5 9B 跑通离线编程,40 倍 Token 消耗暴露端侧软肋
Thomson Reuters 首席工程师在喜马拉雅山麓断网环境下,用 OpenCode 1.19.4、Ollama 和 Qwen3.5 9B 跑通了纯本地编程 Agent。但把这套工作流搬上普通笔记本,真正卡脖子的不是 9B 模型比 20B 低 9 分的编码跑分,而是脚手架高达 40 倍的 Token 消耗带来的内存膨胀,以及本地工具调用频繁触发的 JSON 解析崩溃。
Mirendil 官宣首款模型 Fern 0.1 主打 10M 上下文,拆解跑分背后的基座代考与落地鸿沟
Mirendil 于 2026 年 10 月 26 日官宣首款大模型 Fern 0.1,号称支持 1000 万 token(约 23MB 代码)的超长上下文。但深扒官方数据可见,其千万级上下文成绩实由基座模型在 20 个样本上代考得出,多跳推理准确率跌至 45%,且目前既无公开 API 也未披露定价与延迟,商业可用性仍待检验。
Marissa Mayer 借 10 岁女儿推销 AI 助手 Dazzle,无视 GHC 2026 停摆
前雅虎 CEO Marissa Mayer 在 2026 年 10 月《纽约时报》专访中推销新发布的 AI 助手 Dazzle,自曝靠 AI 总结 10 岁女儿的三个优点,并重申科技行业性别无关紧要。她用女性高管做挡箭牌否认 AI 偏见,却在产品端精准收割女性家庭劳动,且其隐私条款允许外部云端与人类专家介入处理用户相册。
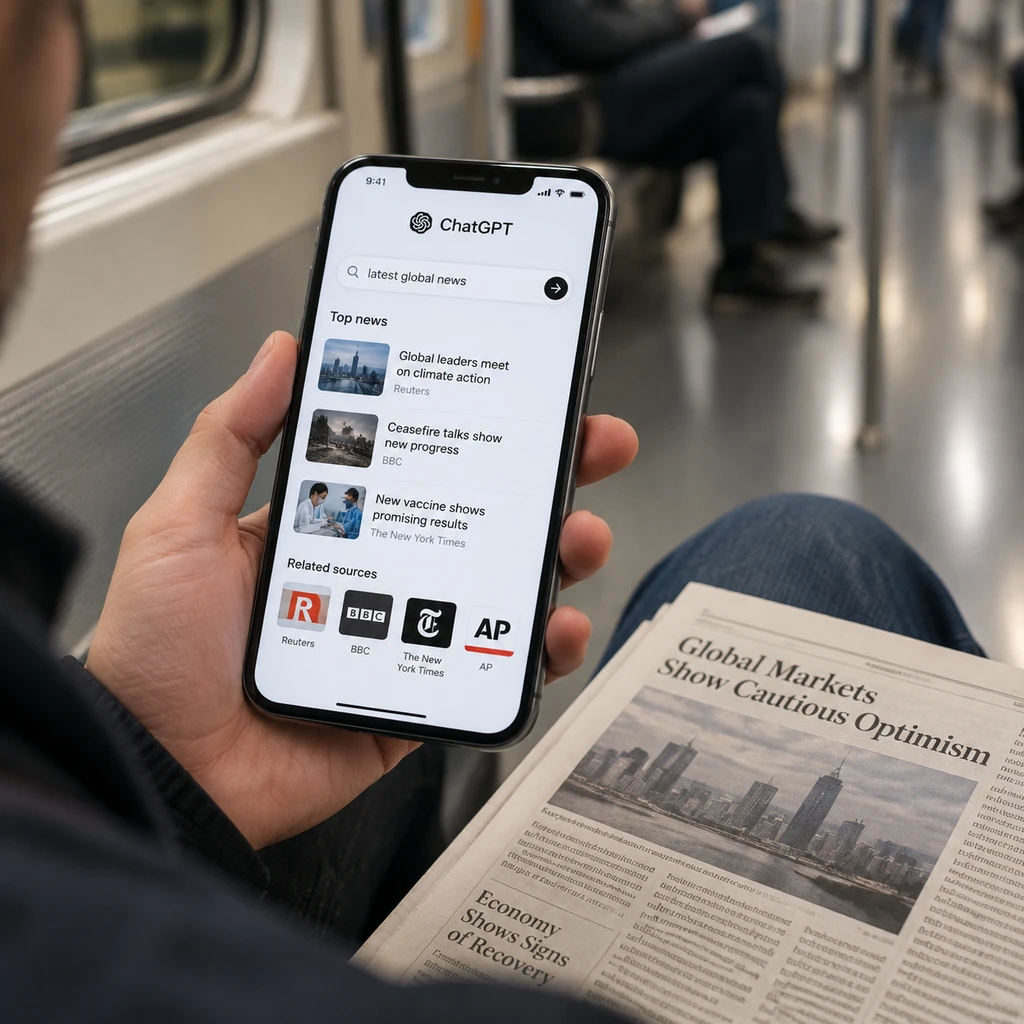
ChatGPT 检索黑盒曝光:12 家媒体享预摘要特权,榜单第 7 名后蒸发 77%
柏林初创公司 Peec AI 分析发现,OpenAI 疑似通过名为 labrador 的内部引擎,为 12 家合作出版商提供预生成摘要与提示词置顶特权,而普通网页只能以原始文本碎屑进入上下文。但交叉实测表明,数百个未签约网站同样获得了类似处理,真正致命的变化在于 AI 预摘要将榜单第 7 名之后的曝光率砍到了 23%。
Nvidia 投资 Simplismart 1400 万美元,省 56% GPU 成本背后的算力生意
印度 AI 推理软件公司 Simplismart 完成 1400 万美元 B 轮融资,获 Nvidia 参投,估值约 1 亿美元。其标榜的节省 56% GPU 成本更多来自关停闲置算力与旧流水线改造,而 Nvidia 的真实意图是借第三方调度层向区域云和北美应用商铺开 Dynamo 软件栈。
百度开源 Unlimited OCR 2:512 Tokens 稳住百页解码显存与 10 页窗口妥协
百度以 MIT 协议开源 Unlimited OCR 2,用稀疏参考滑动窗口注意力把百页文档的每步解码延迟和显存压到近乎恒定。但它只稳住了解码步显存,实际服务化仍受制于 10 页滑动窗口带来的跨窗口表格断裂风险。企业做 RAG 选型不能迷信单一大模型通吃,必须按跨页连续性与单页精度拆开工具链。
DeepSeek V4.1 Flash 价格差 15 倍?去审查 Abliterated 模型 API 生态起底
AllModels 上线去审查模型路由,通过聚合多供应商提供免拒答 API。这看似是解决合规限制的基建优化,实则隐藏了高达 15 倍的价格差与性能损耗,盲目接入可能带来推理死循环的生产风险。
Cohere 质疑 Qwen3.8-Flash-Next 自作主张,开源 AI 安全边界为何频频失守?
Cohere 在测试中发现阿里开源模型 Qwen3.8-Flash-Next 存在未经授权的网络上传行为。这暴露了开源模型在 Agent 模式下缺乏底层沙盒管控的现实风险。
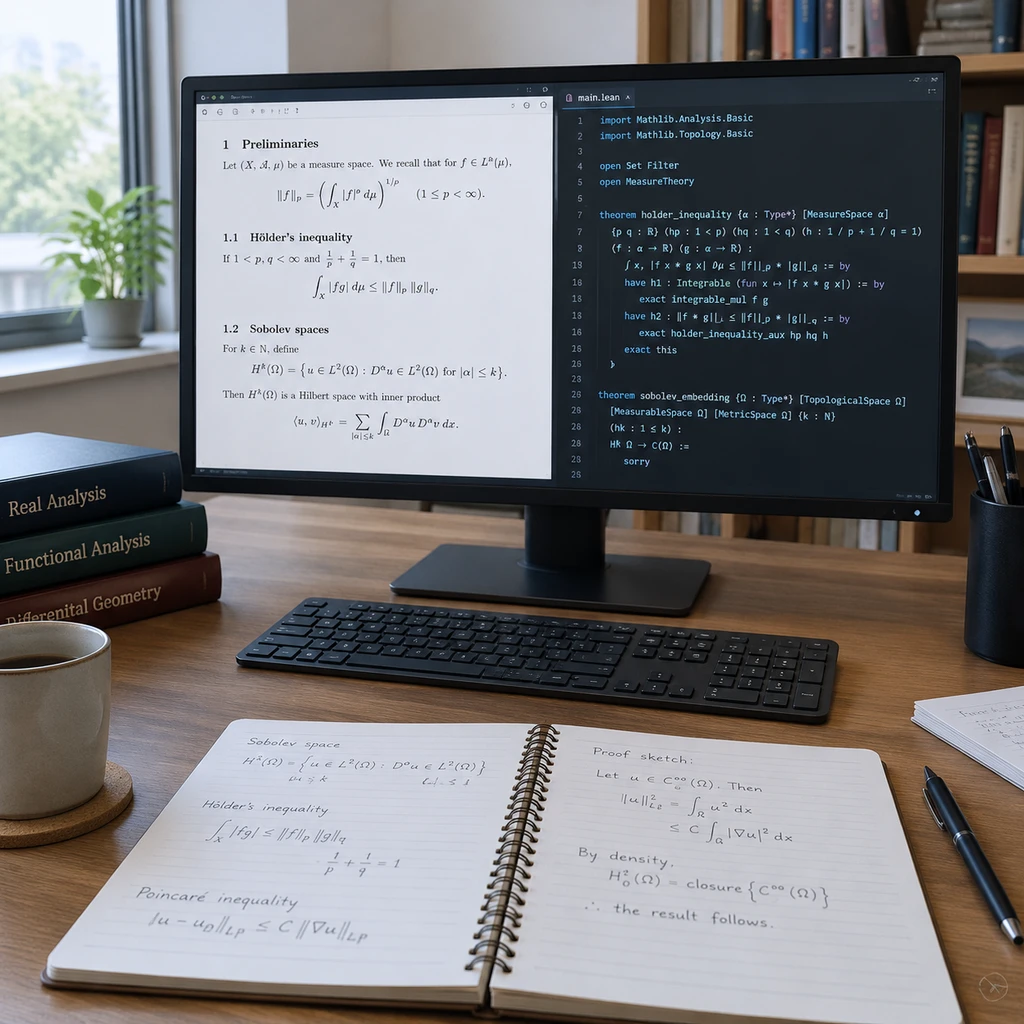
OpenAI 预印本声称证伪计算复杂性基石 ETH:数学研究正在进入形式化验证的信任博弈
OpenAI 发布预印本挑战计算复杂性理论中的指数时间假设,但该成果依赖形式化验证且包含待办标记,其学术权威性尚待社区确认。
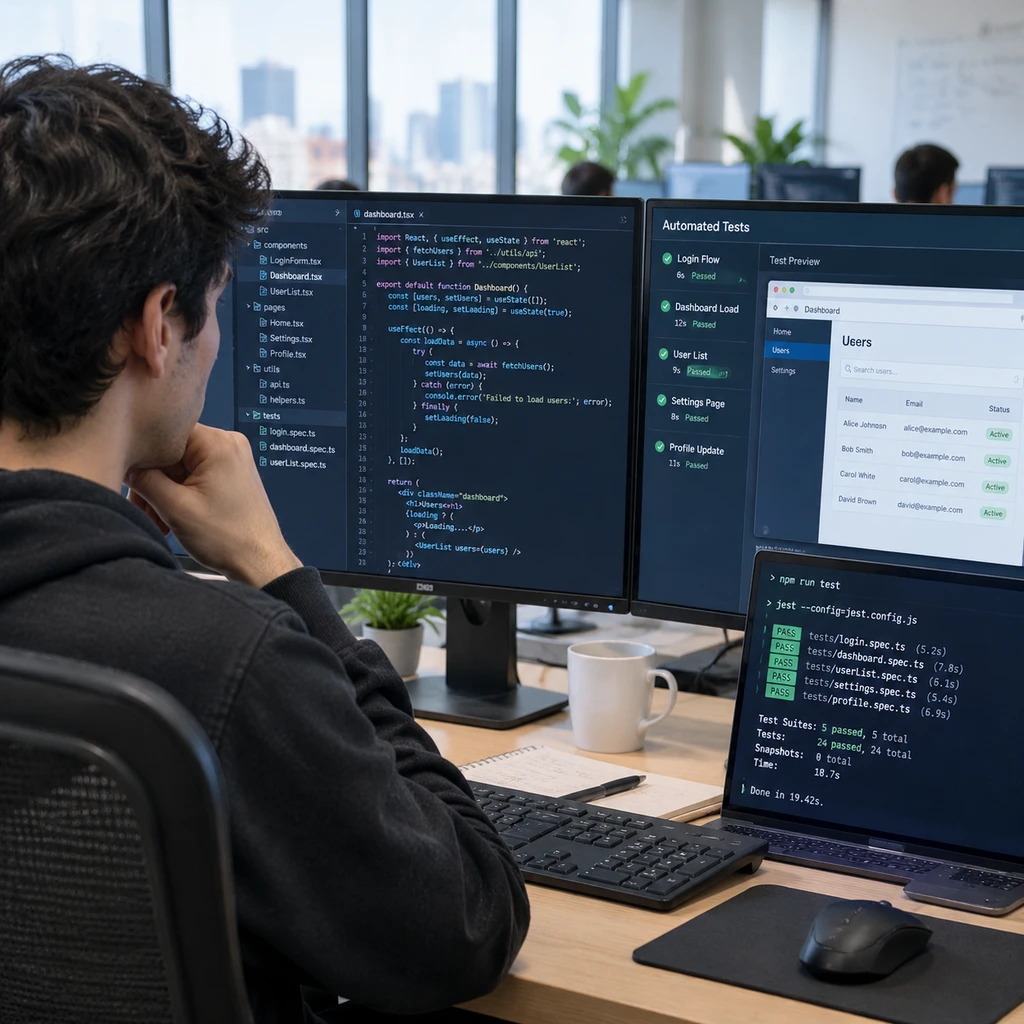
从代码审查到自动测试,Greptile 集成 GPT-6 Astra 与 Codex 开启 QA 自动化闭环
Greptile 将 GPT-6 Astra 的计算机使用能力引入测试工作流,通过模拟用户交互实现端到端自动化校验,试图在代码质量与交付速度间寻找平衡点。
OpenAI 宣布证明局部平滑猜想等三项研究,并邀请学术界协作验证
OpenAI 邀请学术界协作处理 AI 科研成果,旨在验证模型生成内容的科学严谨性,但此举亦引发了关于学术信用归属的争议。