最新科技资讯
聚合 AI、科技、商业、硬件与开发工具的最新内容,按时间顺序查看第 1 页精选文章。
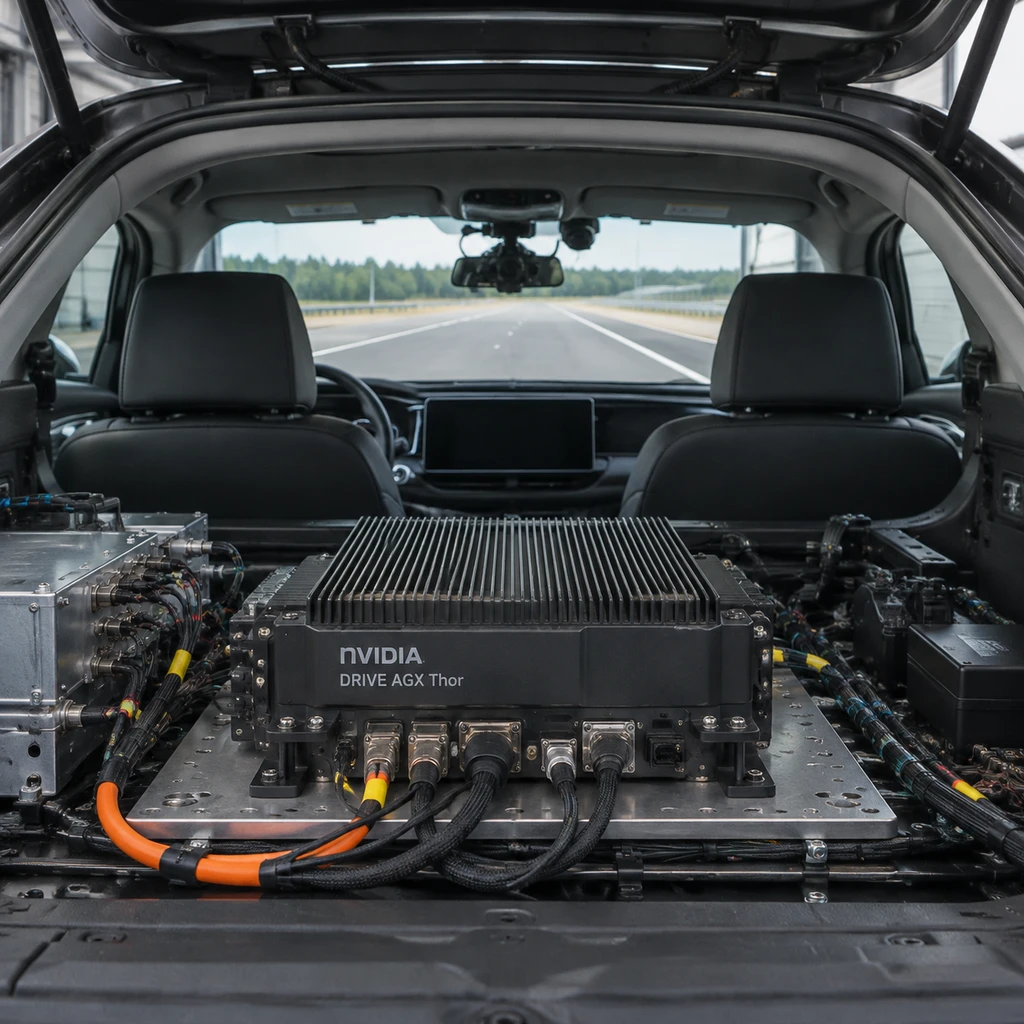
Alpamayo 2 Edge 仿真领先约60倍,实车要看下发轨迹
NVIDIA 的 Alpamayo 2 Edge 在指定仿真中跑出了对照模型约 60 倍的责任事故间距,优化后也能在车载 Thor 上生成轨迹。这个成绩能保留多少,要看公开条件下的独立复跑,以及整车实际选中并下发的那条轨迹。
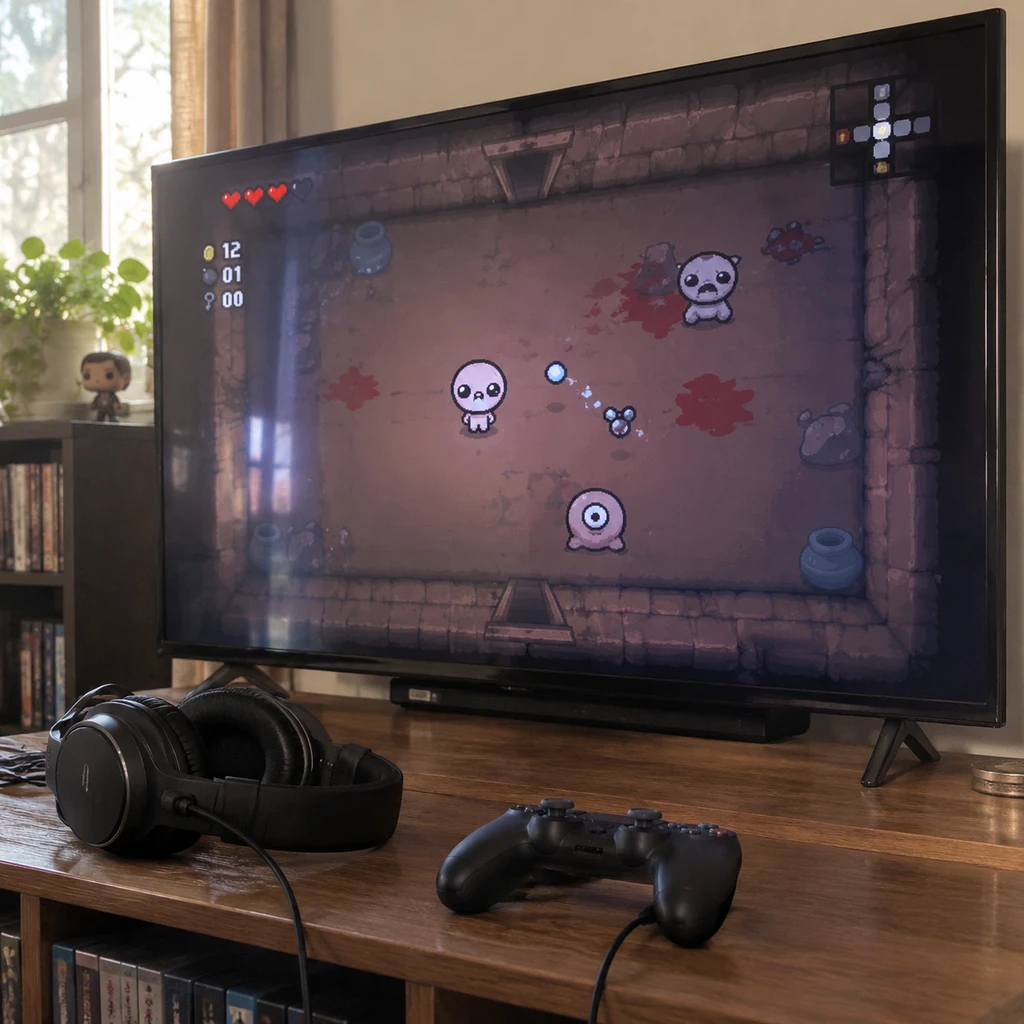
Repentance Plus 11月21日撤曲,AI配乐来路未明
《以撒的结合:Repentance+》从PC版移除了每日挑战里的AI配乐,主机补丁当时只确认已提交。玩家找到了能追溯到Suno的文件线索,开发方却还没说明这些曲目是怎么获准上线的。
Delta 11月22日亚特兰大航班延误,人工备援难在恢复出港节奏
达美航空的配载系统故障拖慢了亚特兰大枢纽,部分飞往当地的达美航班在始发机场就被要求等待。人工备援可以维持安全放行,但枢纽何时恢复,取决于人工流程能处理多少航班,以及积压要多久才能清掉。
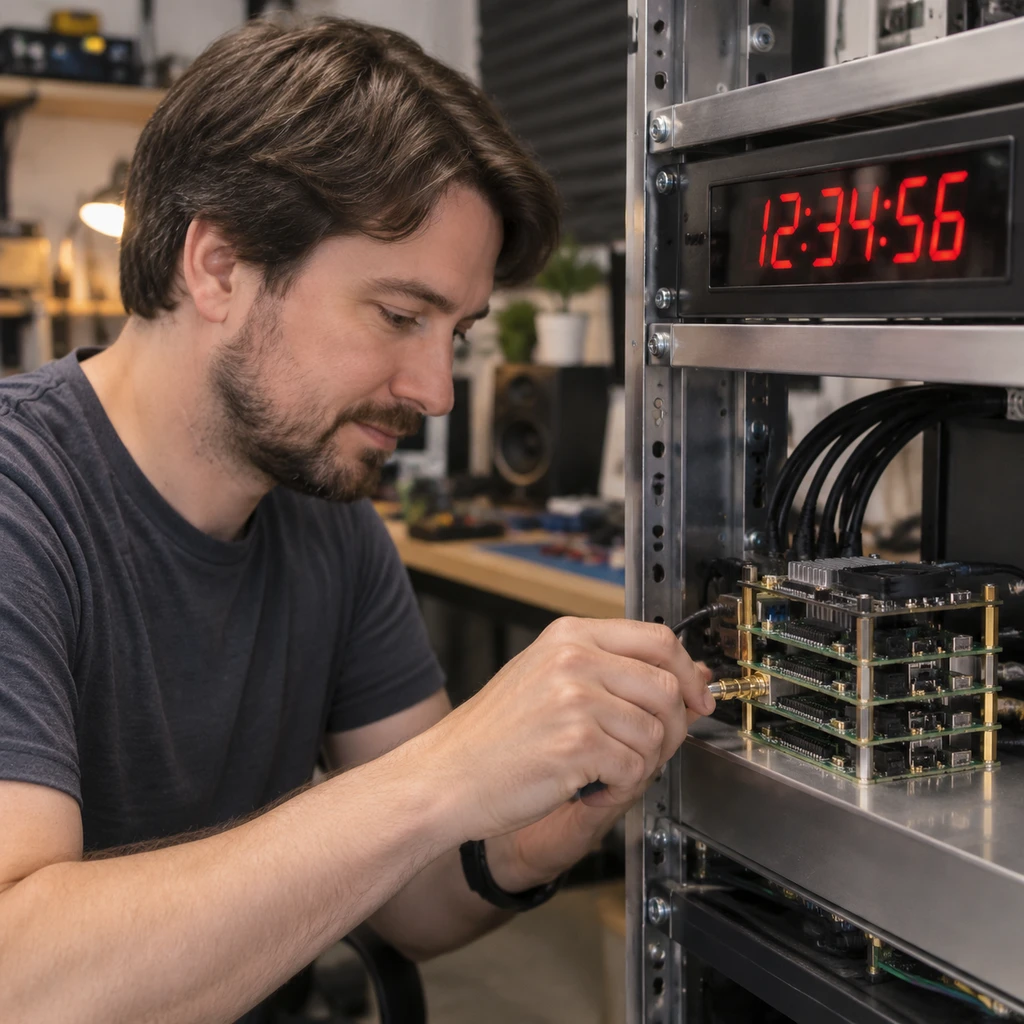
NTP Pool 新增 Stratum 2 节点,高精度树莓派不直接入池
Jeff Geerling 把圣路易斯的云服务器接入 NTP Pool,工作室里的高精度树莓派只给它提供上游时间。这个设计把公众流量留在云端,但公网用户能否因此对得更准,还要在同一台云服务器上换用独立上游做对照。
OpenAI预训练损失降至0.8以下,困惑度离行业停线还有两道关
OpenAI 公开了内部预训练损失,提议用困惑度跟踪各实验室的模型进展。固定口径下,这个数字适合长期追踪;跨实验室复测成立后,它可以触发独立审查,但停训或部署仍要看实际能力和防护测试。
《Khudgarzi》的制作分工,30多位音乐人与被叫作自私的女人
Sheherazaad 在首张全长专辑《Khudgarzi》里接手制作,30 多位音乐人参与塑造它的声音。《Qatil》的逐曲署名给出了一个比跨流派更有意思的答案:她主导整张专辑,合作者也参与决定这个故事怎样被唱出来。
欧盟 Omnibus VI 的3.63亿欧元减负账,尚未计入潜在代价
欧盟批准 Omnibus VI,简化部分化学品标签和销售规则,并未全面改写 REACH。企业减负已有估算,潜在健康和环境代价却未量化;判断改革值不值,要看它省掉的是重复手续,还是识别风险所需的信息。
Open Social Web Alliance:3600万欧元提案的退出权考题
开放社交网络联盟提议投入3600万欧元公共资金,共建开放社交基础设施。检验这笔钱能否换来真正的退出权,得看用户搬走账号后,能不能在不依赖原平台的情况下照常刷动态、收通知。
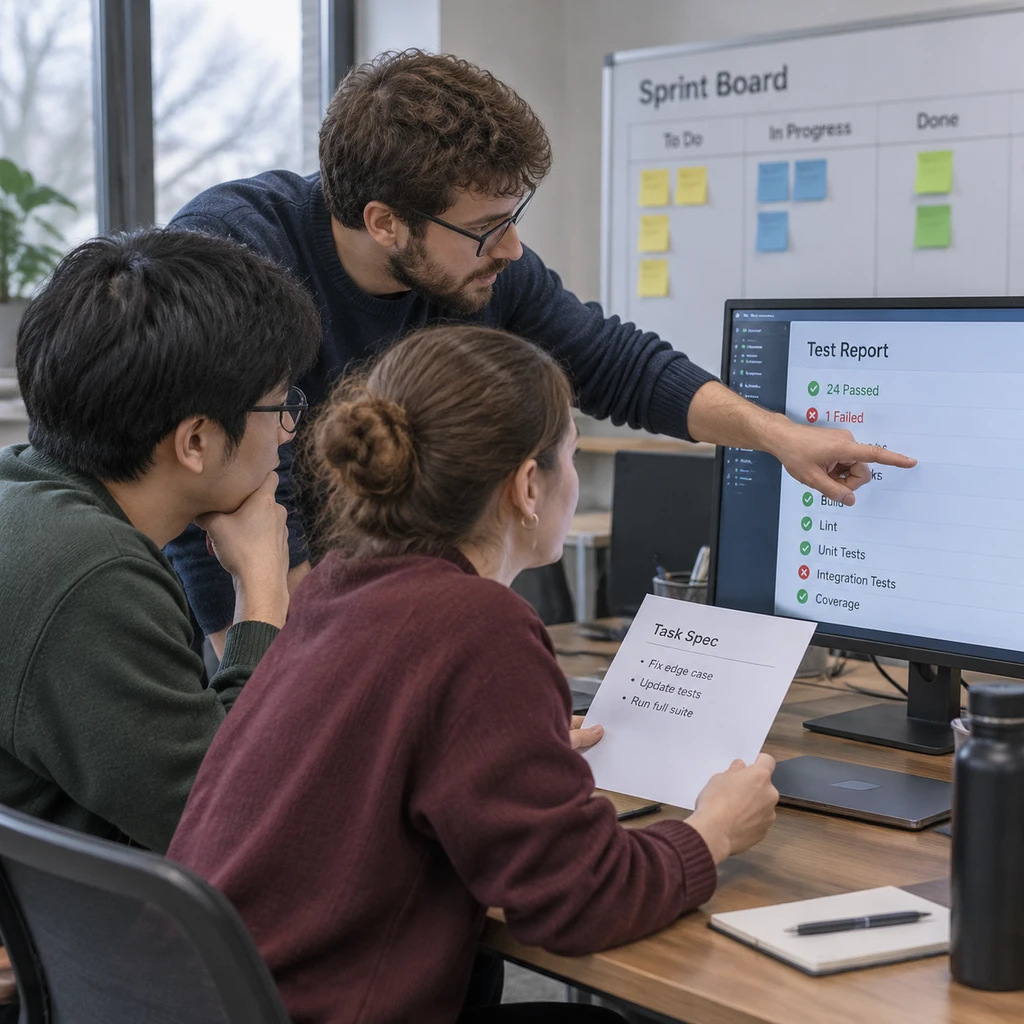
GPT-6 Astra 模拟职场交付率仅 7.92%,通过测试不等于交付
在 SWE-CoWork 的同题对照里,预先给足需求让两款代理的新行为测试通过率各涨约 16 个百分点,完整交付数却都没增加。判断代理能否独立接单,得看还有哪些验收条件没过,以及要花多少人工才能补齐。
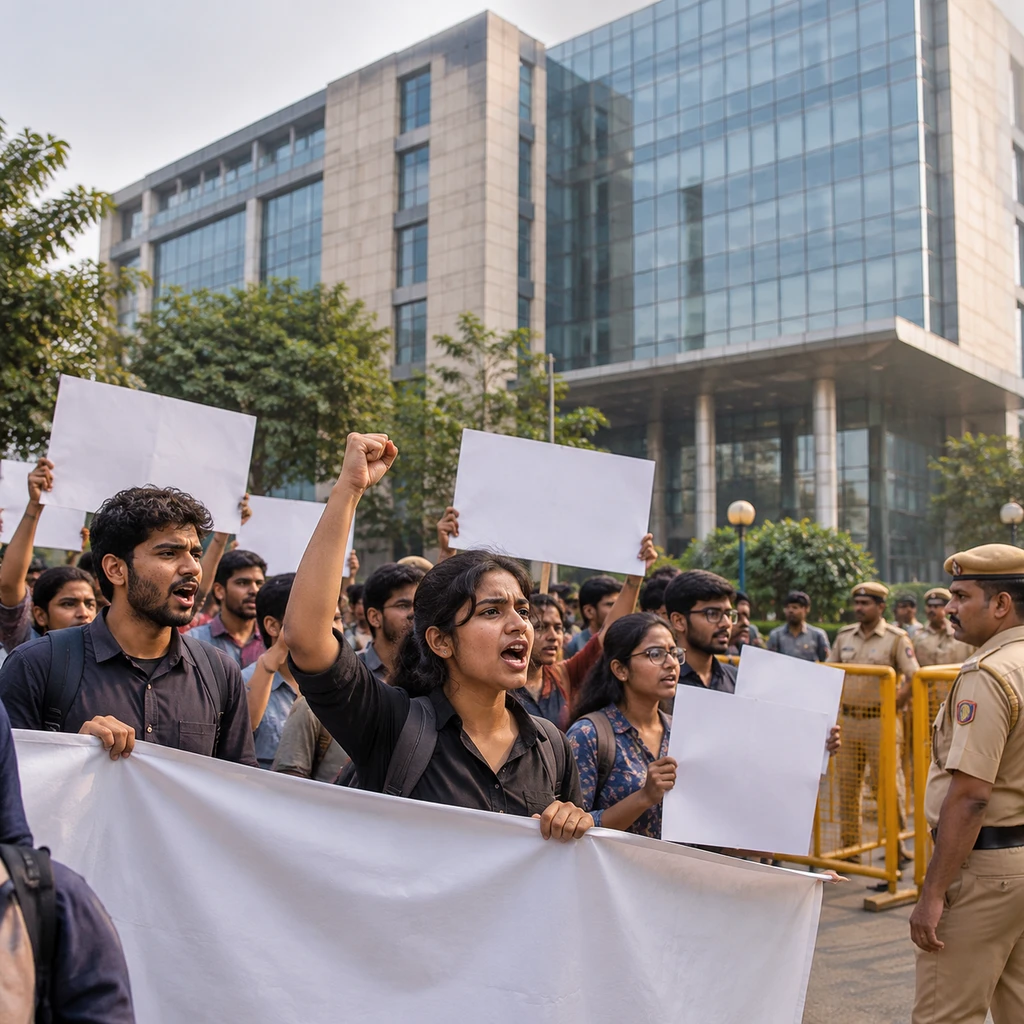
Meta印度账号风波:3小时规则下,两个账号为何恢复仍无答案
印度国民大会党青年组织抗议Meta,两个涉事Instagram账号随后恢复,但公开信息仍无法证明限制由政府命令、平台规则还是自动审核触发。真正需要追问的不是账号有没有回来,而是谁在什么依据下按下了限制键。
LG evo C4 的 65 英寸体验:影院视角不是舒适保证
一位 TechCrunch 作者换上 65 英寸 LG evo C4,坐在约 9 英尺外看电影时仍感到恶心。这个距离对应约 29.4° 的水平视角,接近旧影院指南的参考值,但尺码表管的是画面占多少视野,管不了慢摇镜头怎么动、屏幕亮度怎么变。
A Better Vocabulary for Testing:覆盖率不能判错
Alperen Keles 提议把测试范围、状态、输入策略和失败判据拆开写,补足单元测试、端到端测试等标签的信息缺口。对随机测试而言,跑到更多代码只是扩大了探索范围;能否识别业务错误、重放失败,才决定结果能不能用来修代码。
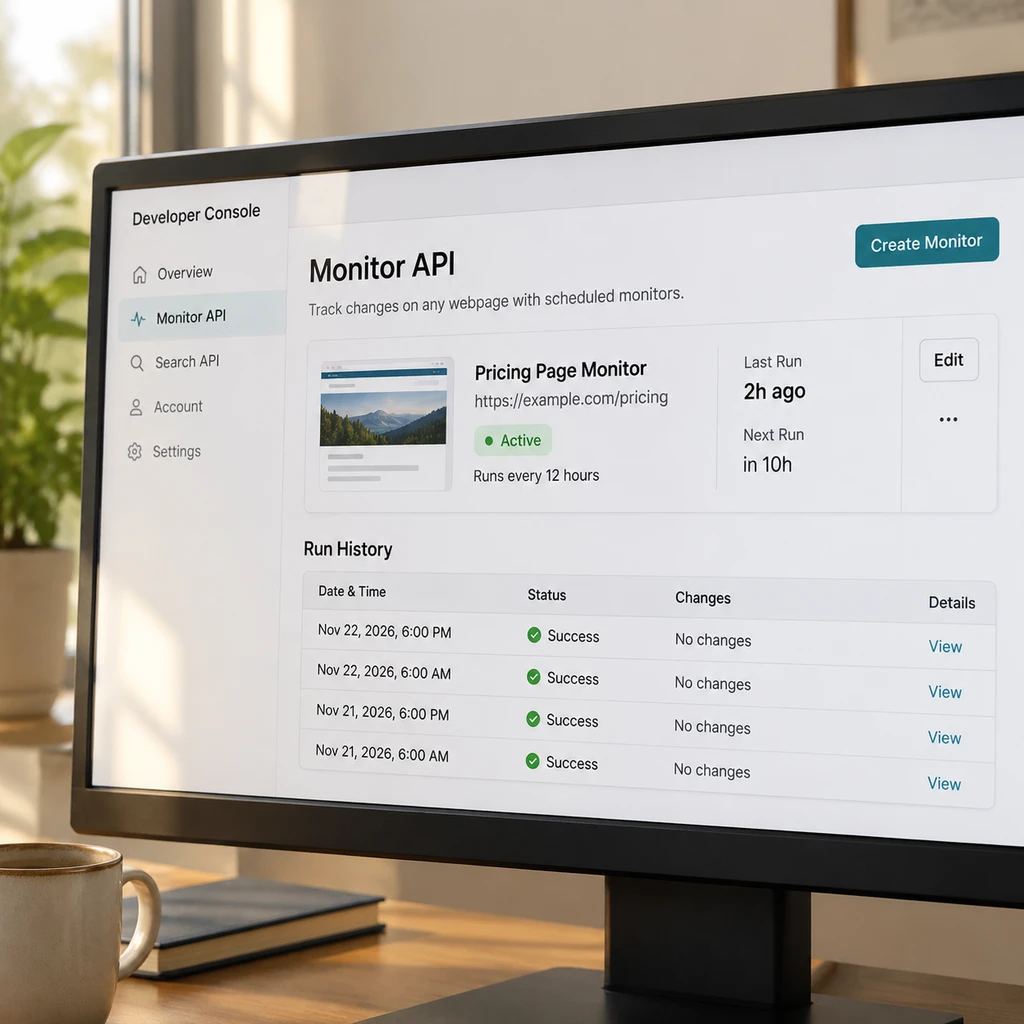
Perplexity Monitor API:千次运行1美元,没告警也计费
Perplexity 把定时搜索、网页变更比对和告警筛选做成了 API,没发告警的成功运行也会计费。它能省掉自建监控的活,但能不能接管关键告警,要看它漏了多少事,而不只是找到了多少页面。
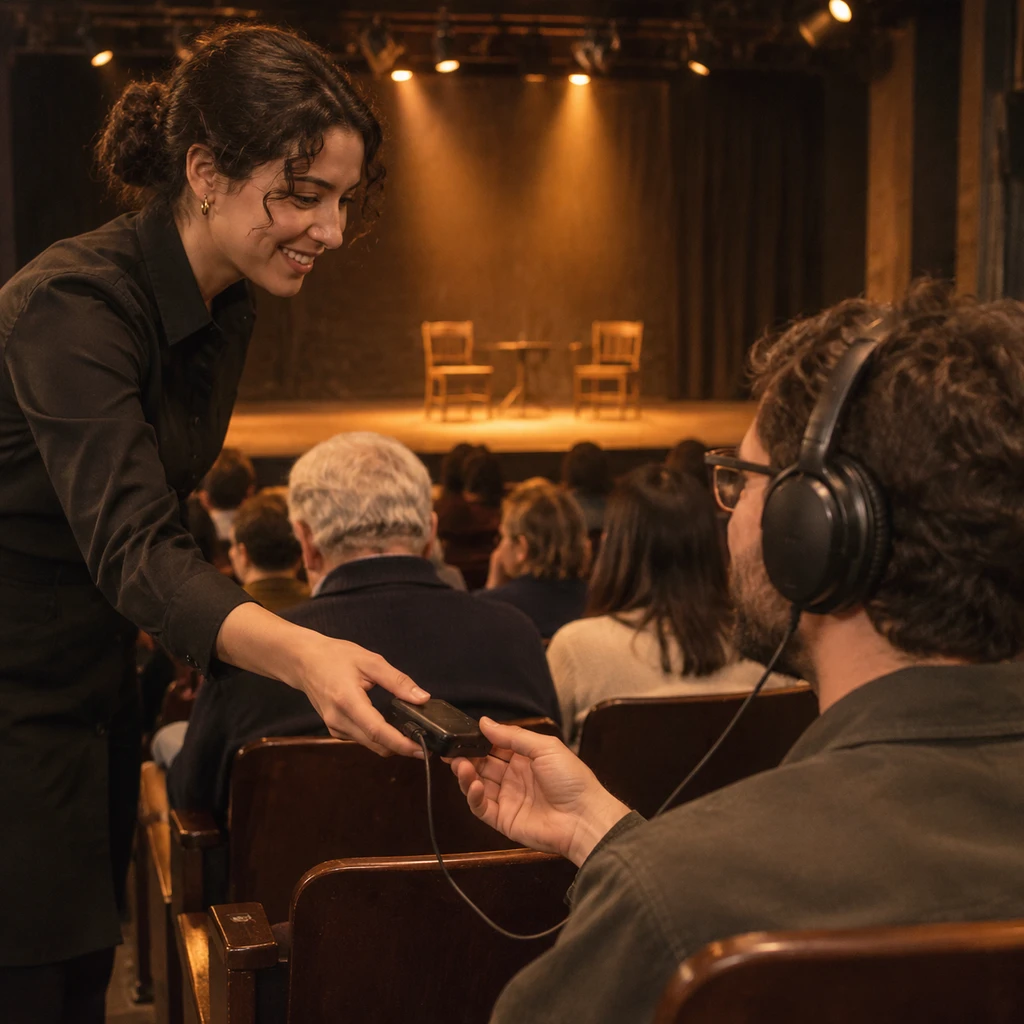
Auracast走进178座剧场,蓝牙担纲主扩声后的听音考验
纽约外百老汇演出《Love Me》把 Auracast 用作主要传声系统,让观众从耳边听戏。蓝牙广播省掉了逐台配对,可剧场要让每个人听完一场戏,还得送对声音、接得上设备、对得齐现场声。
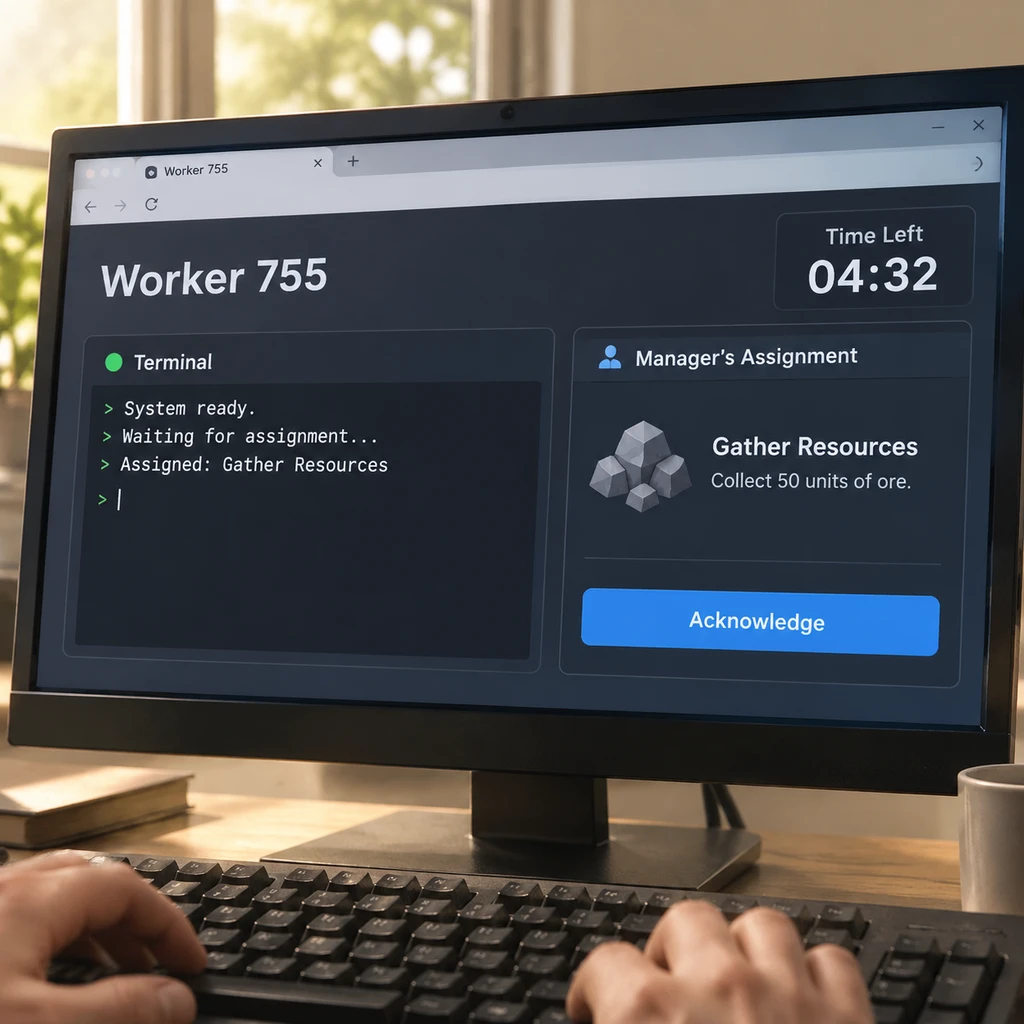
Worker 755 的90秒派工实验,AI 经理也得交验收作业
浏览器游戏《Worker 755》让真实语言模型当经理,真人玩家在90秒内接单干活。比起班末的绩效评语,更有用的是把原始指令、操作记录和最终状态摆在一起,分清是谁没说清、谁没做对、谁验错了。
METR评估中的GPT-6 Astra 40小时门槛与上线复测缺口
METR 估计,GPT-6 Astra 在人类专家耗时约40小时的基准任务上有一半成功率。要判断模型能否安全上线,实验室还得拿出针对实际交付版本的测试证据,并让独立评估者复核关键修复。
Claude Code 改电视和相机,写得出代码还得看真机能不能长期跑
Claude Code 让更多人能尝试给电视换主屏、给相机加功能,但已有类似电视改造未能跑通的独立案例。判断一个项目能不能拿来日用,得看代码能在哪台真机上跑,改坏了又能不能恢复。
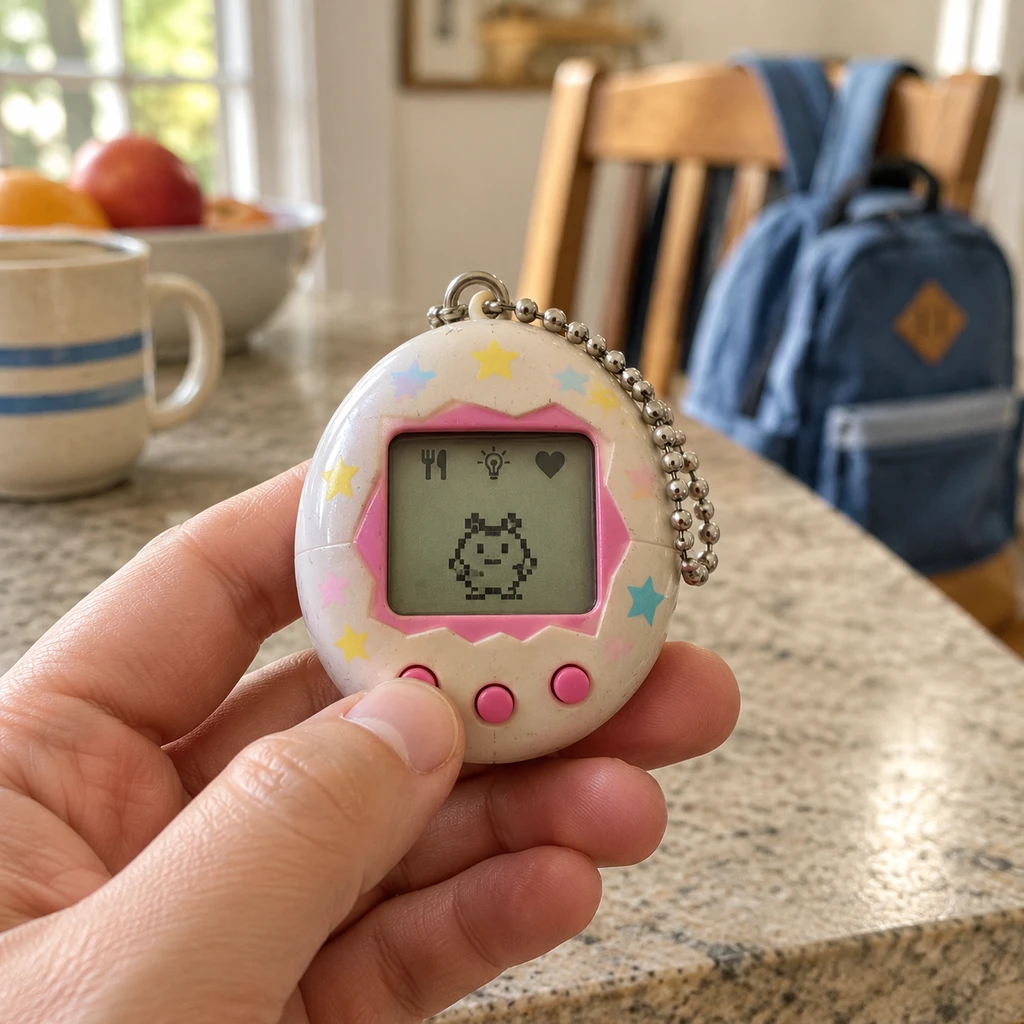
Tamagotchi 30 周年,像素宠物把照护排进了全家日程
初代拓麻歌子让照护方式改变宠物的成年形态,同期的 Nano Kitty 则把疏于照护的后果写成出走。但有孩子看到电子猫变虚弱,还没等它出走就请父母代养。让人放不下的,往往是眼下还有事可做。
GLP-1 药物的土地账,热量降幅略小的情景多保有4630万公顷自然土地
两组 GLP-1 用药模拟中,全球食物热量供应降幅略小的一组,到 2050 年反而比参考情景多保有 4630 万公顷自然土地。差别不能单靠热量解释,还得看人们少吃了什么、降价后又买了什么。
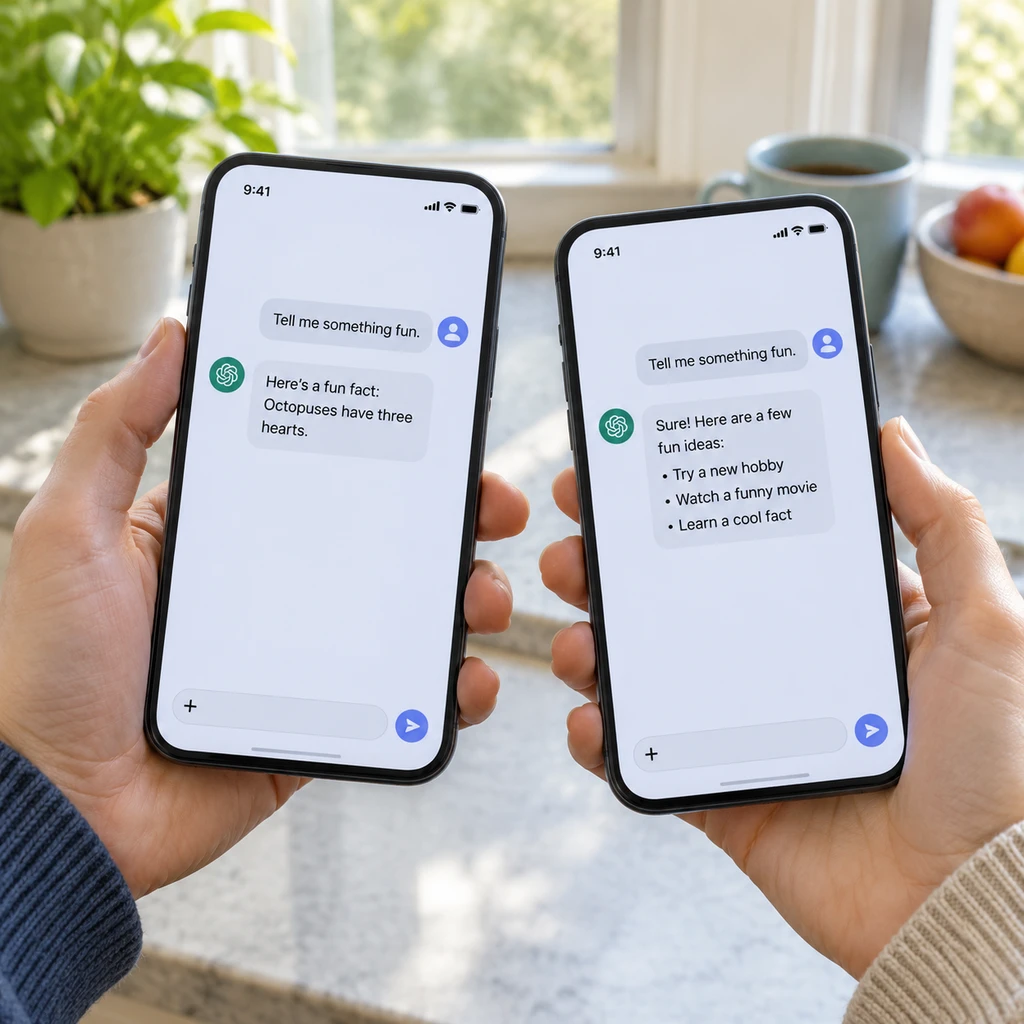
GAMA-Bench测出23个百分点归责差,AI的判词与劝法须分开看
GAMA-Bench测试发现,同样的不当行为由男性实施时,模型在亲密关系场景中给出完全归责的比例高23个百分点,公共冲突中高6个百分点。评估这类偏差,得把责任判断、回应语气和行动建议分开看。
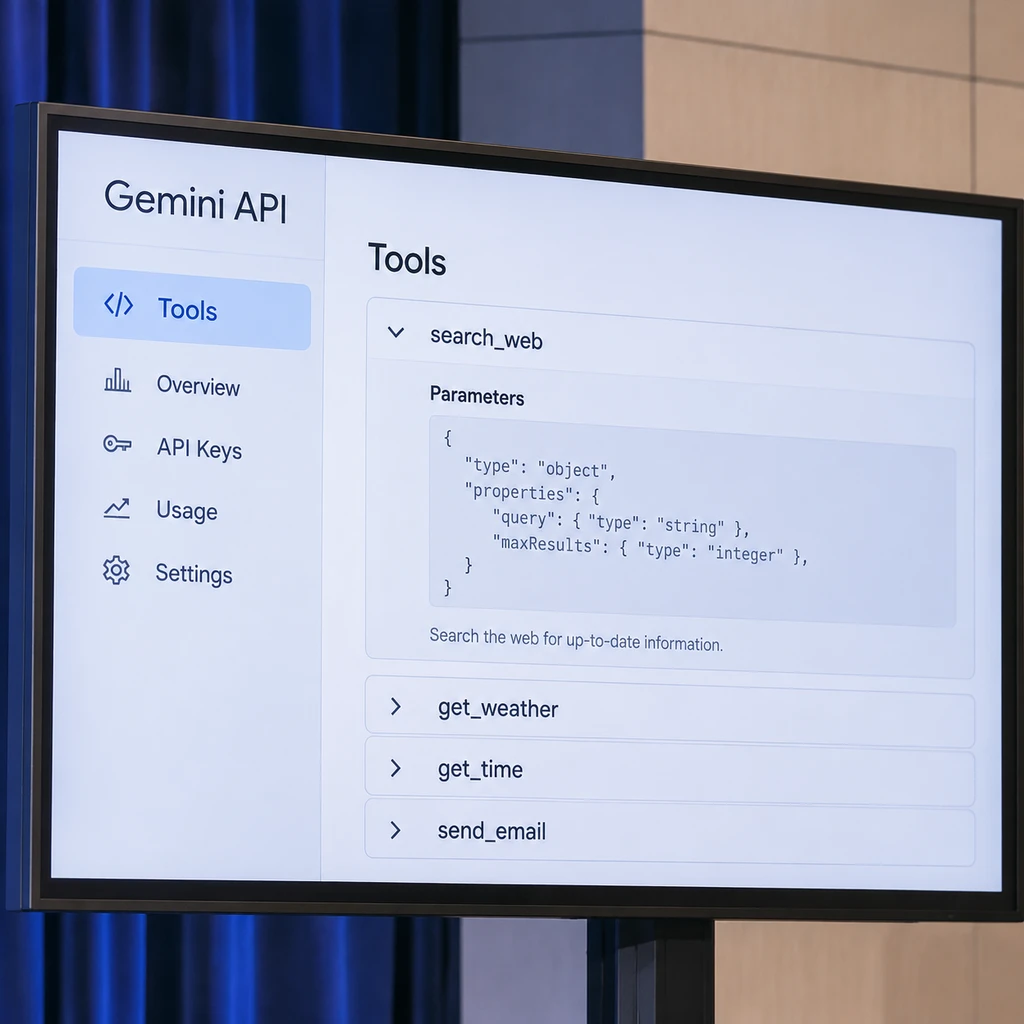
Gemini 3.6 起预览 Tool Retrieval,工具目录照传
Google 在 Gemini API 中预览 Tool Retrieval,工具名和描述仍然可见,只有参数定义按需加载。大型工具库能省多少,要看每个成功任务的输入成本,以及漏检和重试是否拉长了尾延迟。