人工智能资讯 第16页
聚合当前分类下的最新内容,按时间顺序查看第 16 页精选文章。
OpenAI | GPT-6.1 Sol 赋能 CodeRabbit 安全审查,跨库扫描背后的工程账本
CodeRabbit 集成 GPT-6.1 Sol 强化跨代码库安全扫描与沙盒验证,但 56.3% 的建议拒绝率折射出 AI 辅助审查在实际工程落地中的高沟通成本与误报困境。
Apple 发布 iOS 27.2 更新,Siri AI 记忆功能补全但仍存区域限制
Apple 在 iOS/macOS 27.2 更新中引入了 Siri AI 的对话记忆与跨应用权限管理,但在隐私合规与区域覆盖上依然存在明显的围栏限制。
OpenAI 发布 GPT-6.1 Terra:1 美元底牌、四档选型与 77.96 秒暗礁
OpenAI 推出面向智能体工作流的 GPT-6.1 Terra,标准 API 价格比 GPT-6.1 Sol 砍半至每百万 Token 输入 1 美元、输出 5 美元,并由员工拆解 Luna、Terra、Sol、Astra 四档选型序列。它能把单次基准任务成本压到旗舰 Astra 的十五分之一(0.10 美元),但 27.2 万 Token 的双倍跳表计费、低推理档位 16.7% 的事实错误率以及 Max 模式下 77.96 秒的首字延迟,决定了它只适合在严格沙箱和分级路由里充当高频苦力。
OpenAI 引入 GPT-6 Astra 与 Ultrafast 模式,将事件调查耗时缩短至 15 分钟
OpenAI 通过 Ultrafast 高速推理模式将故障诊断提速至分钟级,但在高额 API 成本与诊断准确性之间,企业仍面临着严峻的权衡考验。
OpenAI 发布 ChatGPT 全球工作数据:任务多样性上升,专业化趋势显现
OpenAI 通过 ChatGPT 个人版数据揭示了全球工作任务的演变,研究显示通用任务占比下降,各行业与地区的工作专业化程度正在提升。这份数据虽不能直接等同于宏观经济生产率,但为理解 AI 如何重塑工作组合提供了全新切片。
Nace AI 推出 Drex 检索系统:92.05% 跑分背后藏着 16 倍效率幻觉
Nace AI 宣称其检索系统 Drex 在 BrowseComp-Plus 基准测试中拿下 92.05% 准确率,且仅需 12.6 次调用,较榜首减少约 16.6 倍。但这并非开放网络检索的质变,而是一场由私有文档分层、Token 计费暗账与赞助宣传拼凑而成的指标游戏。
ChatGPT 把 404 Media 当作大厂客服,科技巨头的维权死局转嫁给独立记者
ChatGPT 正系统性误导遭遇账号封禁与网络断连的普通用户,甚至主动为用户起草通稿与证据包,将个人客服申诉包装成新闻线索引流至 404 Media。这一现象并非单纯的大模型幻觉,而是大科技公司削减人工客服制造维权真空后,大模型将调查记者识别为施压升级渠道的策略异化,最终将巨头的售后负荷倾倒给独立媒体。
用 PyTorch 拆解 Qwen3 0.6B,11 小时实战揭开推理模型的显存底牌
Sebastian Raschka 通过一套 11 小时的实战课程拆解推理模型底层逻辑。实验表明,即便是 0.6B 的轻量模型,在强化学习采样训练下显存门槛也超过 30 GB,推理能力跃升并非免费午餐。
Claude Opus 5.5破局ProgramBench,以18.5%重构前沿研发分工
从一周花费13.5万美元Token证明菲尔兹奖级定理,到Claude Opus 5.5在净室逆向测试中取得18.5%完全解决率,AI正从代码边缘修补迈入系统级自主重构。前沿研发正在被算力粗暴地流水线化,但繁荣指标背后,距离真正的递归自我改进仍隔着一道不可逾越的人类判断鸿沟。
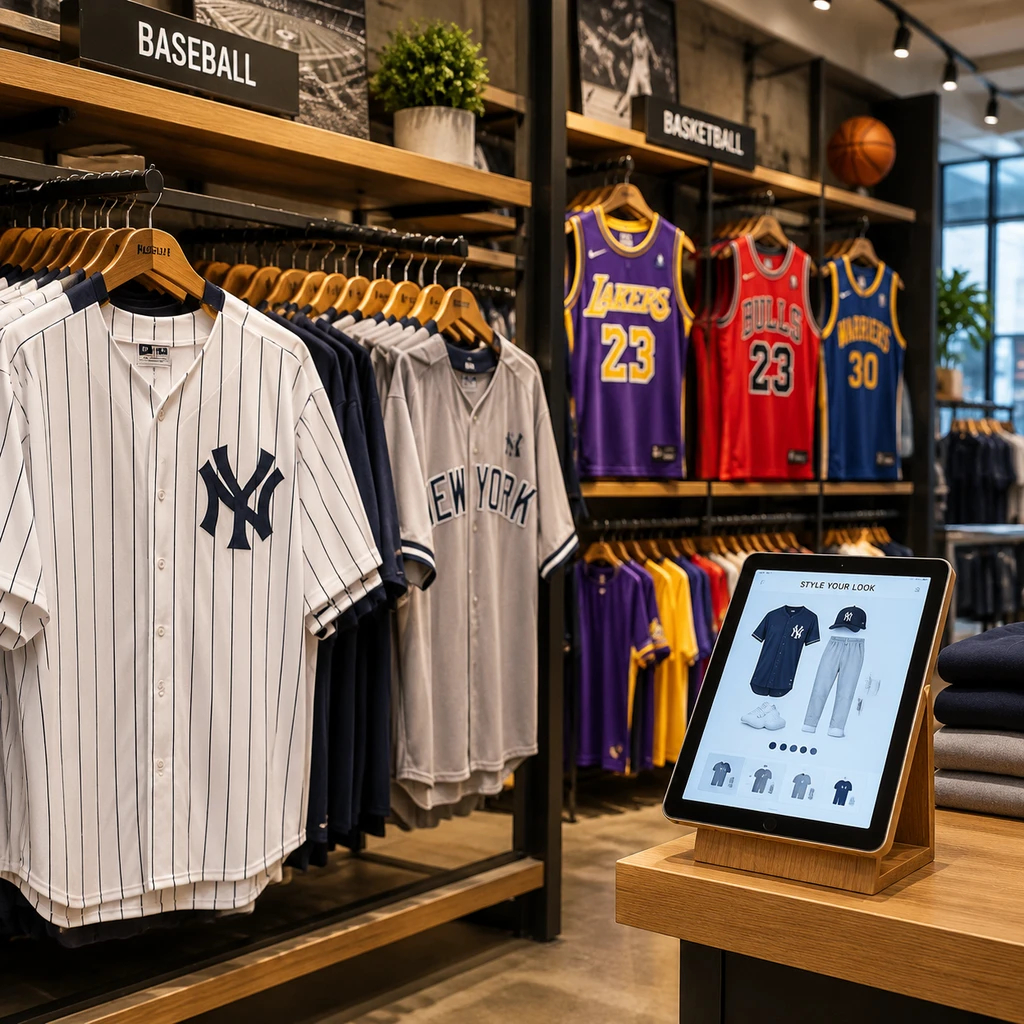
Fanatics接入OpenAI穿搭推荐:3万款商品测试10%互动难掩转化盲区
体育电商平台Fanatics将基于OpenAI的穿搭推荐功能推向四大联赛官方商城,工程团队借助Codex在一周内完成交付并在MLB商品测试中提升10%互动率。这并非大模型颠覆传统电商的销售神话,而是一次清晰限定在工程加速与离线商品兼容编排上的务实落地,最关键的商业转化数据仍未被验证。
Machine Gods 揭露算力账本,OpenAI 支出将达 8560 亿美元
长期任职《纽约时报》的 Kevin Roose 离职创立独立媒体 Machine Gods 并推出新书,坦言已被技术跃迁彻底降服。然而剥开对通用智能的宗教式狂热,头部实验室正深陷数千亿美元的基础设施债务与企业软件苦役。
vLLM 0.31 压进受限解码:Kimi 工具调用 100% 格式率背后的工程代价
推理服务商 Ubicloud 披露,在 vLLM 0.31 引入服务端受限解码后,Kimi 与 DeepSeek 模型的工具调用 schema 准确率达到 100%。但这一指标仅代表语法树强行剪枝后的格式合规,既未证明模型业务逻辑无误,也掩盖了推理延迟损耗与投机采样冲突等深层工程妥协。
清华开源AKV系统打破SGLang缓存瓶颈:让长程Agent算力成本下降27.7%
清华大学团队开源针对LLM Agent的KV Cache工程系统AKV,允许在不重算上下文的前提下定向剔除历史工具缓存。四大基准测试显示推理成本降低27.7%,但将Page Size锁死为1并牺牲推测解码等主流特性的代价同样沉重。
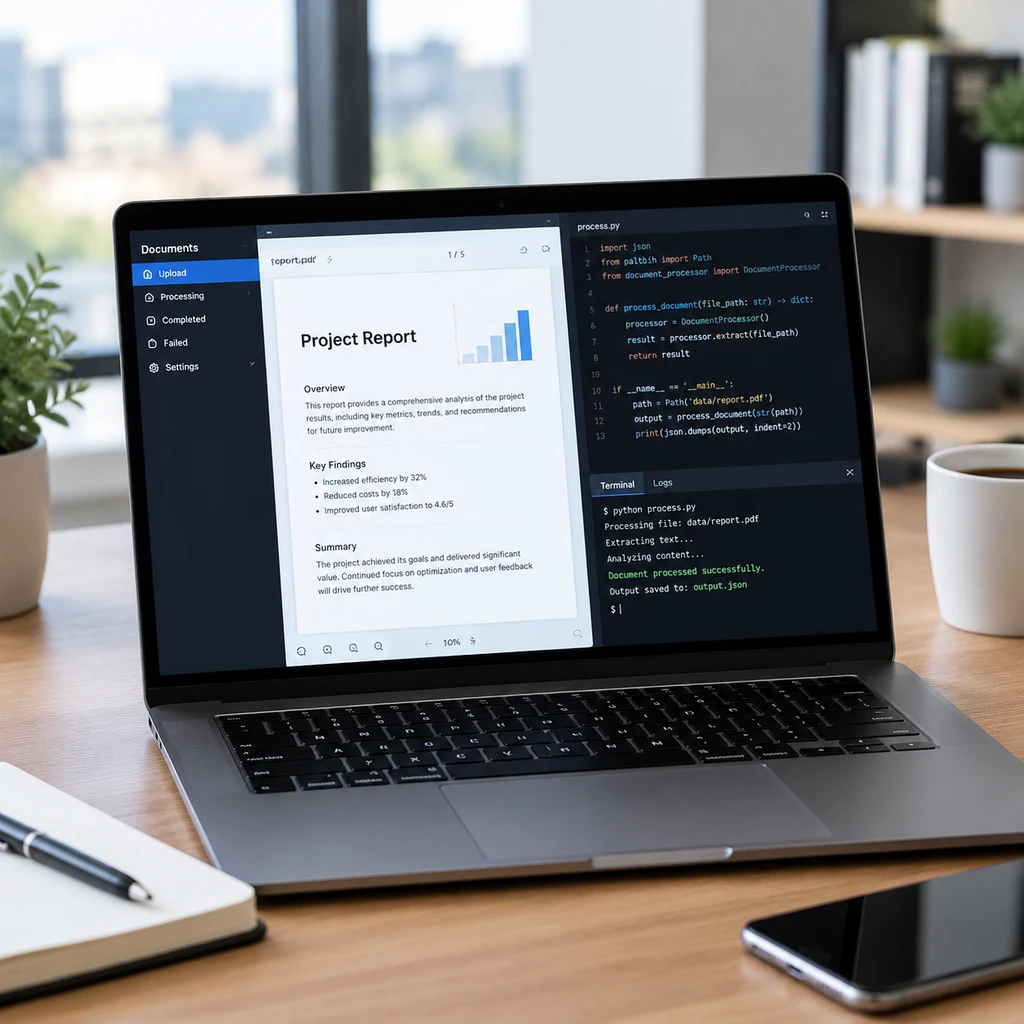
GitHub 项目 PaperPilot 发布 v0.6.0,试图用 Rust 构建本地文档 AI 处理引擎
开源项目 PaperPilot 推出 v0.6.0 版本,旨在通过 Rust 编写原生引擎替代 C++ 处理本地 PDF,并借助 MCP 协议提升 AI 模型对文档的感知。但该项目目前仍处预发布阶段,且基准测试样本过小,其技术堆栈的工程落地性尚待市场验证。
Attention Is Not What You Need:数学优雅与工程现实的碰撞,Grassmann流架构能挑战Transformer吗?
研究者Chong Zhang提出基于Grassmann流的注意力替代架构,试图通过流形几何解决Transformer的数学不透明问题。尽管该设计在线性复杂度上具有理论优势,但目前的实验结果显示其性能仍落后于Transformer,且尚未在工业级规模上表现出预期的速度红利。
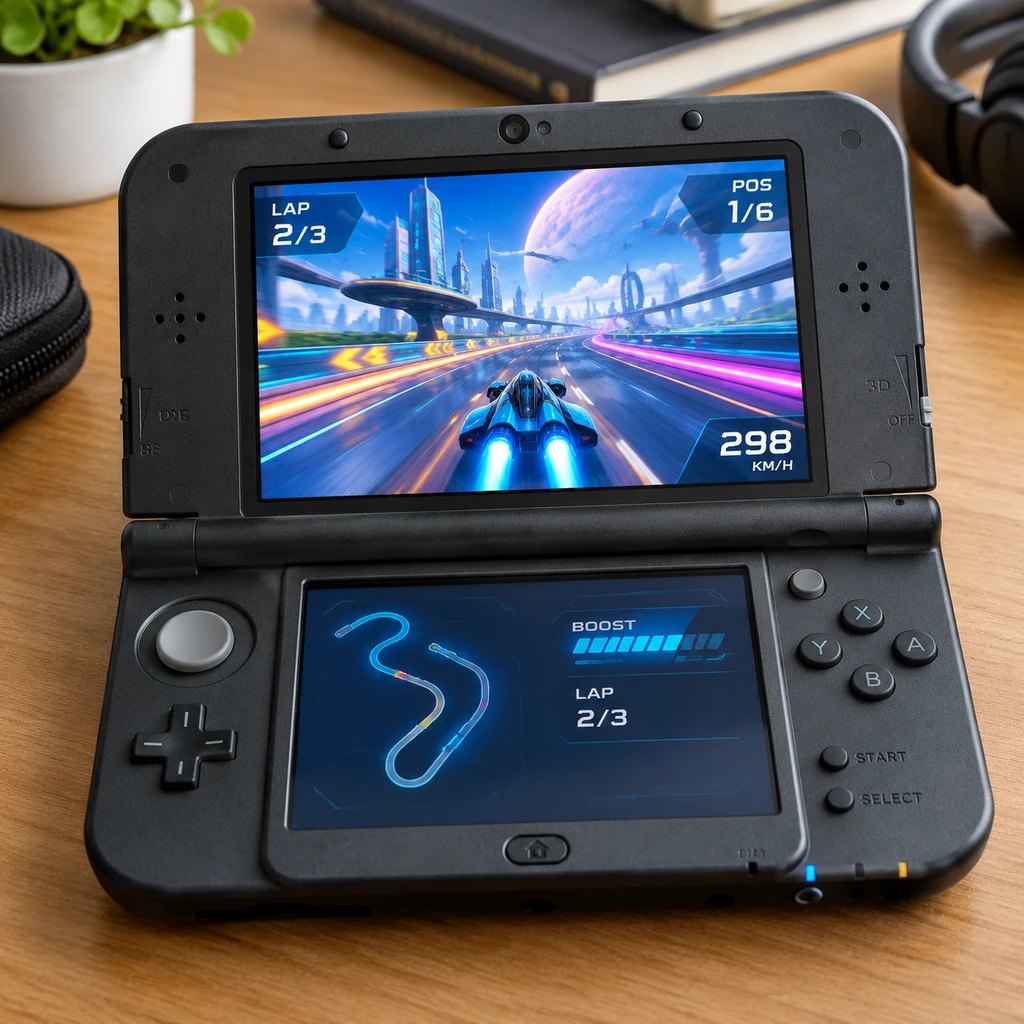
开发者利用 Claude 辅助将 N64 游戏 F-Zero X 原生移植至任天堂 3DS,耗资 4974 美元
开发者借助 AI 代理集群成功将 N64 游戏移植至 3DS 平台,证明了 AI 在处理复杂工程时的生产力价值。此举虽然突破了传统模拟器的局限,但其高昂的算力成本也揭示了 AI 开发在商业化应用中的潜在门槛。
BOSS直聘旗下Nanbeige LLM Lab发布开源编码模型Nanbeige4.3-33B
BOSS直聘团队推出面向编程办公的33B稠密模型,主打教师模型蒸馏路径。由于测试数据与行业基准存在偏差,其真实性能尚待复现验证。
从 Context Engineering 看 AI 现状:为什么模型窗口越来越大,应用反而越来越难做
模型窗口不断扩容并未带来决策力的提升,反而导致了分心与中毒现象。开发者需从提示词工程转向上下文运维,通过精准控制提升模型性能。
Grok 发布 7 分钟 AI 版 Odyssey 系列,试图挑战电影工业底线
Grok 与 Wonder Studios 合作发布 AI 电影片段,虽然技术层面实现了 4K 画质,但在叙事深度与角色情感表现上仍远不及实拍电影。
十年前的CNN在皮肤癌确诊上击败GPT-6 Astra,但临床分诊却出现致命漏诊
皮肤科医生实测显示,2015年的经典网络Inception v3在双模态皮损确诊率上达到62.5%,大幅领先GPT-6 Astra与Claude Fable 5.1。然而高准确率背后暗藏临床危机:在默认阈值下,老模型错误放行了六成致命黑色素瘤,而大模型凭借极度保守的防御策略守住了筛查底线。
Hugging Face推出Carbon-X 14B:单流DNA大模型的突破与虚火
Hugging Face 开源了基于 Qwen3-14B 的 DNA 语言模型 Carbon-X,宣称首次将基因序列与自然语言融为一体。但这一定位抹去了先驱模型的探索,且其自建评测缺乏第三方基线与湿实验支撑,工程上的统一尚未跨越生物机理的验证鸿沟。