人工智能资讯 第4页
聚合当前分类下的最新内容,按时间顺序查看第 4 页精选文章。
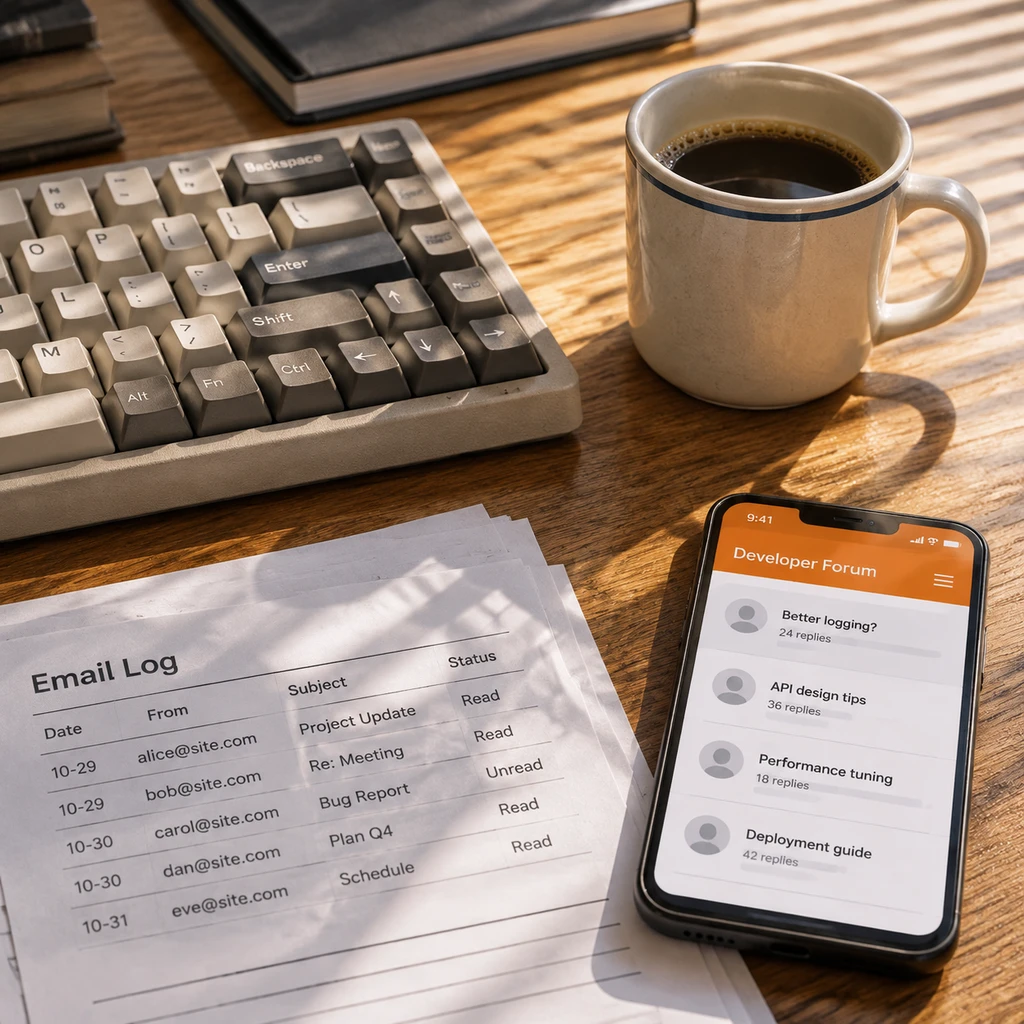
Hacker News 与 Claude 邮件复盘:88% 的请教信沦为 AI 销售漏斗
开发者 Josh Strange 用 Claude 复盘了自己 13 年来的读者来信,发现与 Hacker News 评论相关的邮件在 2026 年有 88% 变成了伪装成技术请教的产品推销。大语言模型配合月费几十美元的社区监控工具,已经把精准社交工程改造成低成本的工业流水线。当公开邮箱的善意沦为自动化获客的燃料,技术社区的高信噪比偶遇正在迅速瓦解。
FluxCap 获 640 万美元融资,前美国反垄断掌门人做 AI 专打科技大厂
前美国司法部反垄断局负责人 Jonathan Kanter 与前副手 Doha Mekki 联手创立 AI 法律科技公司 FluxCap,斩获 640 万美元种子轮融资。这款工具把打赢 Google 垄断案的办案方法论封装进系统,联合诉讼融资资本,专门帮中小原告律所推演诉讼策略、对抗大型企业的文档消耗战。
Automattic 发布 Spacefast:5美元截胡AI建站,WordPress借壳求生
2026年11月9日,WordPress.com母公司Automattic推出针对氛围编程(vibe coding)的部署与基础设施平台Spacefast,支持接入Claude、Cursor等多种AI代理,付费版5美元/月起且全线允许商用。表面看这是向开放生态妥协的中立管道,但翻开底层文档,其身份验证与邮件仍是期货,且通过无外部连接串的数据库和隐藏的WordPress实例,完成了一次低价截胡与隐秘锁定的防御自救。
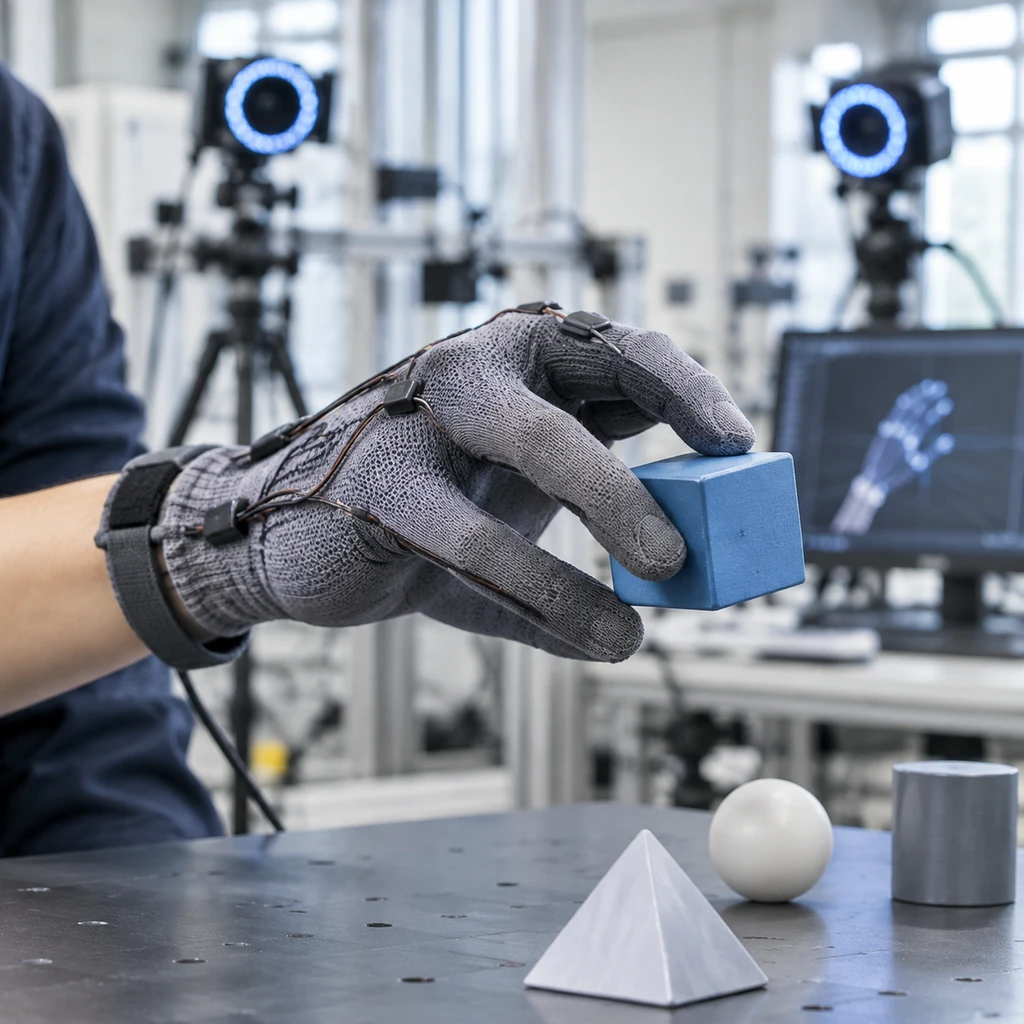
Physical Superintelligence 3天攻克量子猜想,Meta Tactus采集人手触觉
AI科学初创公司Physical Superintelligence用非公开Anthropic模型在3天内证明了Aaronson-Ambainis量子猜想,连提出者本人都在尚未读懂证明时凭Lean 4验证承认了结果。同期Meta发布1.5毫米厚的Tactus传感器手套采集人手操作数据。当AI接管最深处的符号推演,人类研究者正退居为机器的验证员与物理外设。
Amazon 开源 HOPE 剪枝算法:Qwen3.5-122B 省下 115GB 显存且不降智
Amazon 研究团队推出 MoE 大模型二阶专家剪枝算法 HOPE,通过保护成对协同激活的专家群组,在砍掉 50% 专家的情况下让 Qwen3.5-122B 释放约 115GB 显存。在 SWE-Bench Pro 智能体编程测试中,HOPE 剪枝后的 Qwen3.5-35B 不仅比次优方法 REAP 高出 6.1 个百分点,甚至以 42.3 分反超未剪枝原模型。这证明高比例剪枝下独立给专家打分的一阶范式已触顶,而引入成对交互仅需增加 6% 至 8% 的校准时间与不到两分钟的求解开销。
Meta 将 Instagram 的 AI 年龄检测推向全球,185.9亿美元和解催生全员核验
2026年11月9日,Meta 宣布将 Instagram 的 AI 年龄估算技术扩展至全球,通过社交黑话、身高骨骼视觉模式及设备信号排查虚报年龄的未成年人。这场由最高185.9亿美元检方和解协议倒逼的合规狂奔,在零准确率披露下,正把被误伤的成年女性、非英语区用户及年轻创作者推向被迫上交身份证或人脸数据的两难境地。
Reason Machines 开源 Aspen:1个 Agent 花 4 天复刻 OpenAI Pando
Reason Machines 开源了专为数千并发 AI Agent 设计的 Git 服务器 Aspen,单机宣称可达每秒 567 次推送。该项目由 1 个 AI Agent 在 OpenAI 公布 Pando 架构后花 4 天写成,但尚未通过 24 小时持久性测试,展示了 AI 极速生成原型与生产级存储可靠性之间的巨大鸿沟。
Next-Concept Modeling 提速 31 倍:斯坦福 Hazy Research 砍掉 1024 步采样
斯坦福 Hazy Research 团队提出 Next-Concept Modeling(NCM)框架,用多尺度残差 VQ-VAE 将文本压成由粗到细的编码层,在 100M 参数规模下比最强扩散语言模型快 10 到 31 倍。这套架构绕开了扩散模型每步算满全序列的算力黑洞,但两阶段训练的分词器能否跨领域通用,仍是它走向百亿参数大模型前的生死关。
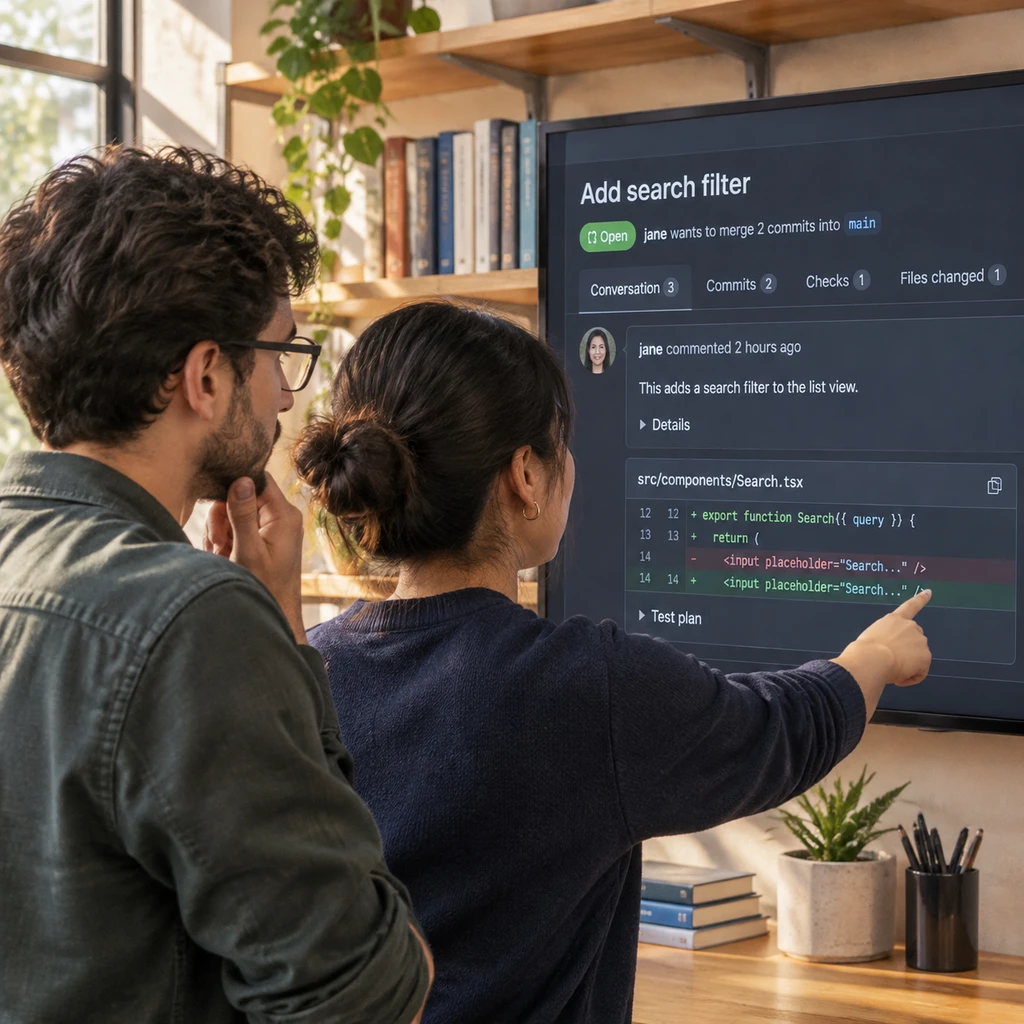
Claude Opus 5.5 写 PR 太啰嗦,开发者用 1 行 HTML 守住注意力
2026年11月9日,知名开发者 Simon Willison 提出用 HTML 折叠标签重构 AI 生成的 GitHub PR 描述,把人工精选导语放在顶部,将 Claude Opus 5.5 等模型生成的长文折叠存档。当编码智能体让写代码和写文档的成本双双归零,软件工程真正的瓶颈已从代码产出彻底转移到人类审查者的注意力分配上。
Claude Opus 5.5 抛弃 Three.js 直写 98KB 原生 3D 页面,零依赖代价几何
Simon Willison 用 Claude Opus 5.5 把一个 77KB 的 Three.js 彩蛋页面直接重构成 98KB 的纯原生 WebGL 单文件,证实大模型已能跨过底层图形 API 的陡峭门槛。但可行性不等于工程胜利,剥离成熟框架不仅没拿到性能跑分证据,连两版画面的视觉一致都没守住,反而把复杂度变成了人类看不懂的黑盒负债。
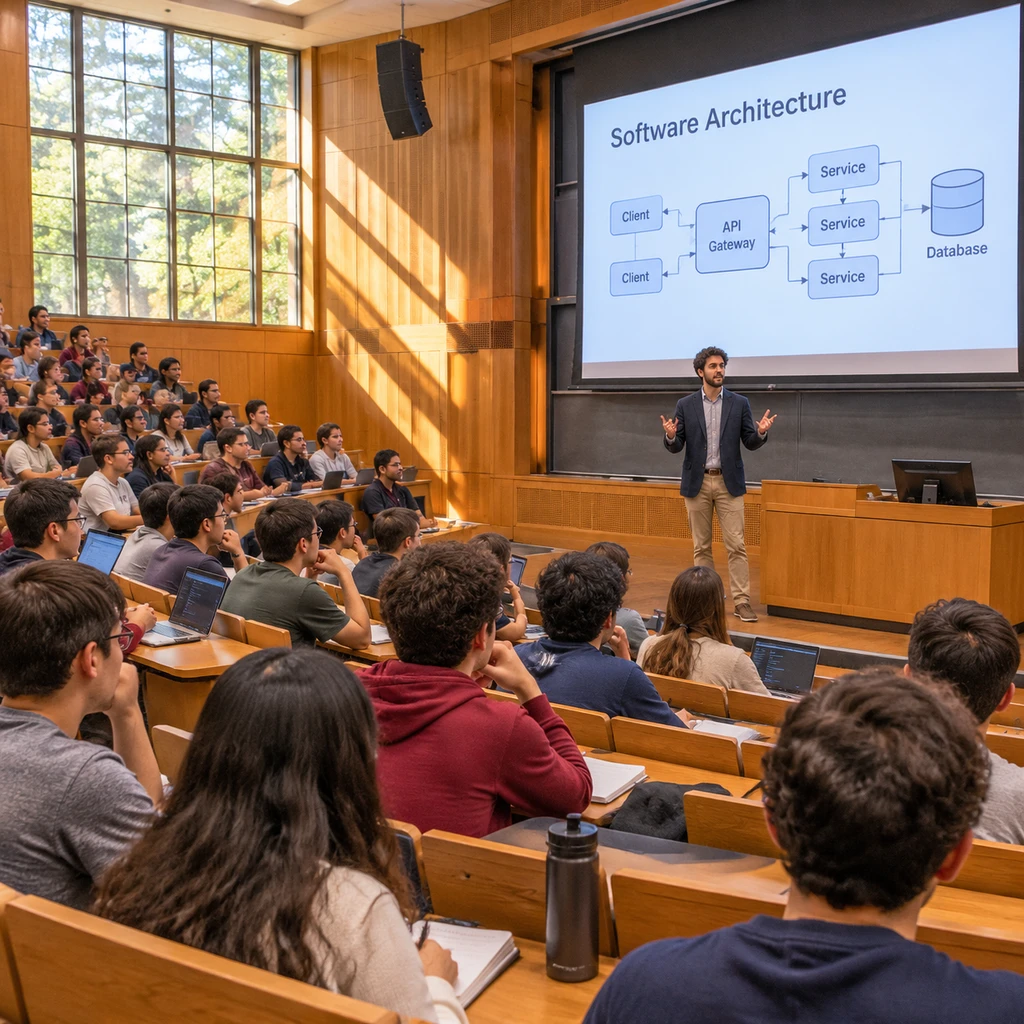
Stanford CS146S 2026大纲翻新:用AI后调试分跌17%的解法
斯坦福大学热门课程CS146S《现代软件开发者》在2026年秋季彻底重写大纲,从早期的AI IDE结对编程转向规范驱动开发、循环工程与软件工厂。面对Anthropic实验中初级工程师用AI后调试与评估成绩暴跌17个百分点的能力危机,这门课证明真正的AI原生工程依然建立在操作系统与算法底座之上,核心竞争力已从手写代码迁移至规范设计与系统验证。
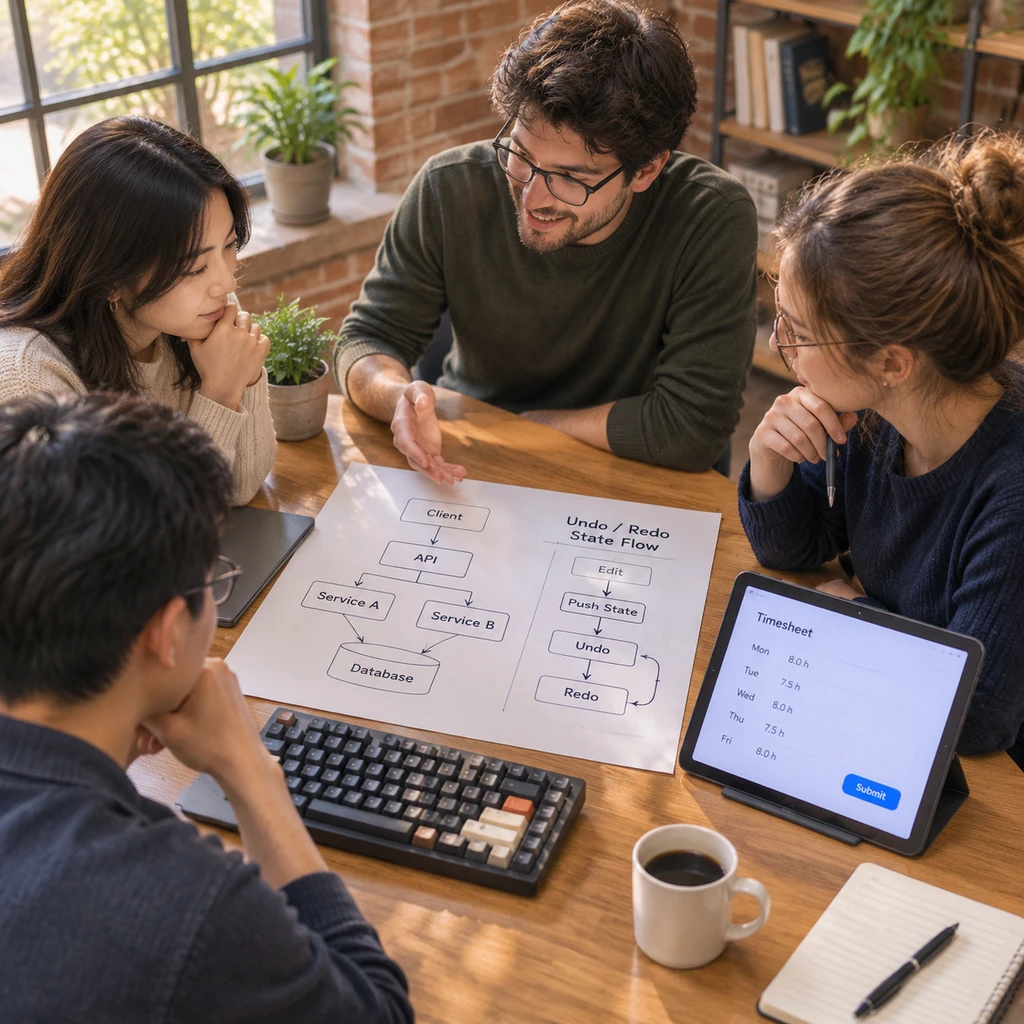
Abejora 因 500 美元涨价自研工时工具,为接 AI Agent 重写底层代码
因原工时软件涨价致年成本增加 500 美元,Abejora 团队自研了 10 人 10.99 欧元/月的一口价替代品,并在近期为接入 AI Agent 重构了系统底层。这桩微型 SaaS 案例戳破了 AI 改造软件的实质:给软件接 Agent 远不止开放接口,而是因为大模型会犯错,迫使底层架构必须推翻直接覆写逻辑、补齐变更历史与全局回滚机制。
Claude Code与Codex并发让重大错误增39%,用Git队列把切换缩至1分钟
开发者 Sergey Kuhne 放弃了多开 20 个 Claude Code 或 Codex 终端窗口的工作流,改用基于 Git 的优先级队列与单线程收件箱,将单次上下文加载从 20 分钟压缩到 1 分钟。BCG 对 1488 名员工的调查印证了这一痛点,当高强度监督 AI 超出认知容量时,决策疲劳会上升 33%,重大错误率飙升 39%。AI 编程的真正瓶颈已从代码生成转移到人类的审查吞吐量,把状态从聊天窗口剥离并写回代码库正在成为新一代工程标准。
Suno 遭 Elvis 与 Eminem 权利人索赔超2亿美元,v6合规破局
2026年11月6日,Elvis Presley遗产机构与Eminem词曲出版商在加州北区联邦法院分别起诉AI音乐公司Suno,合计索赔超2亿美元。两案并非同一路数:阿姆出版商主攻269首作品的词曲版权与YouTube反规避,猫王方则动用田纳西州《ELVIS法案》直击声音克隆。即便Suno已签下华纳与BMG并上线v6模型,音乐产业录音、词曲、声纹三权割裂的底层结构,仍让AI音乐的局部洗白沦为假象。
Take-Two前AI掌门人与Skull and Bones的2亿美元教训
前Take-Two AI负责人Luke Dicken与资深制作人指出,3A游戏预算失控并非因为美术太慢,而是高层频繁改方向导致的巨额重做。以耗时8年、耗资约2亿美元的《Skull and Bones》为例,在方向盘失灵时引入AI加速资产生产,只会制造更多待报废的在制品库存。
Murat Demirbas 警示 LLM 时代亚马逊六页纸失效,659 人实验揭开真相
计算机科学家 Murat Demirbas 指出,LLM 让亚马逊引以为傲的六页纸备忘录失去了作为深度思考凭证的价值,不动笔的人正沦为生成式文本的肉身代理。但 2026 年多项认知实验证明,真正决定大脑退化还是进化的并非是否使用 AI,而是谁先动笔的工作流顺序。
Anthropic 拆解 Claude 内部工作空间,14 项指标难证 AI 意识
神经科学家 Anil Seth、哲学家 Ned Block 与 Giulio Tononi 在《Nature》联名发文,直指统治计算机界近 90 年的“大脑即计算机”隐喻存在致命缺陷,断言沿现有硅基数字架构演进的 AI 极不可能产生意识。即便 Anthropic 在 Claude 内部发现了类似人类“全局工作空间”的信息处理机制,那也只是功能层面的信息调用,将智能误判为意识正在把监管与伦理资源引入歧途。
Richard Sutton对LLM scaling提苦涩教训:AI科学远未结束,45家实验室尝试算法新范式
图灵奖得主Richard Sutton纠偏其著名的苦涩的教训,指出AI不应仅停留在Transformer的大规模暴力扩展上;以45家新兴实验室为代表的算法叛逃正试图绕过这一算力壁垒。
llama-modchip v2.4.0 塞入 284B DeepSeek-V4-Flash,64GB 纯 CPU 破局背后的跑分真伪
开源项目 llama-modchip v2.4.0 宣称在零 GPU、64GB 内存的 CPU 机器上跑通 284.33B 参数的 DeepSeek-V4-Flash。这套硬核方案靠 3.75 bpw 极低比特量化砍掉 20.31 GiB 体积,但 44.36 tok/s 实为预填充速度,且 256K 上下文宣称与启动参数矛盾,无损承诺仍待独立复现。
Google 开源 Elephant-Goldfish Model 插件,5 阶段审查耗资 5 倍却漏了底裤
Google 开源了用于 AI 编程规范先行审查的 Elephant-Goldfish Model (EGM) 插件,试图用无状态子智能体拦截垃圾代码。但独立实测显示,这套 5 阶段审查耗时翻了 3 倍、成本暴涨 5 倍,质量提升却微乎其微,核心收益其实来自简单的写前审批;更尴尬的是,连 Google 自家的 Antigravity 都存在系统指令泄露,所谓零上下文金鱼从出生起就被项目成见污染了。
Person of Interest 开播 15 周年拆解:PRISM 与 Palantir 为何造不出全知机器
《疑犯追踪》开播 15 周年之际,不少科技从业者重温该剧并感叹剧中的全知监控系统已成现实。但拆解美国第 702 条款下的 PRISM 项目、Palantir 分析软件与现实预测性警务可以发现,全知且精准预判个人犯罪的系统至今仍是科幻;真正的现实危机,是执法机构将充满偏见与误判的局部算法线索当成了确定性证据。