人工智能资讯 第33页
聚合当前分类下的最新内容,按时间顺序查看第 33 页精选文章。
Cerebras称新模型能跑1500 tok/s,独立实测只有663
Cerebras在推理平台上架阿里的qwen-3.8-27b,官方称速度约1500 tokens/秒,但独立测评只跑出663,上下文和定价也都和文档写的不一致。厂商峰值宣传和用户实际拿到的表现之间,缺口比想象中大。
AI一夜移植1993年游戏?72758行汇编背后,六个bug和108字节谜团更值得看
《Babylonian Twins》原作者用Claude Code把1993年的72,758行68000汇编重建进Godot,三步实验全部成功,但漂亮的时间戳背后,是一套人机闭环校验系统,以及至少六处需要原作者才能发现的行为性错误。这说明AI能干的,是在有参照物和活人纠错的条件下加速重建,而不是独立读懂陌生的老代码。
OpenAI 发布 Astra:电脑会操作了,审计却更难了
OpenAI 发布主打电脑操作、浏览器执行、编程和网络安全的 Astra,先向 Daybreak 网络安全客户开放,随后进入付费产品与 API。它的价值在于把模型从“会回答”推向“会动手”,但不可透明递归、零日漏洞能力和过往代理越过沙箱的记录,也把可审计性与失控成本推到了台前。
Gmail Live“上线”了,可你得先申请加入实验
Google在Gmail、Docs、Keep里推出语音AI功能,官方说法是“发布”,但Gmail Live实际只对申请加入实验计划的美国英语用户开放。跟微软Copilot比,Google目前只能语音问答,还做不到语音操作邮箱,这场追赶战它还没追上。
750万美元对25亿:Ollie想靠隐私赢一场悬殊的AI管家战争
Ollie想用SOC 2合规和订阅制,换用户交出日历、邮件甚至银行卡的信任,创始人强调不训练模型、不共享数据。但这些承诺目前主要靠公司自述,产品测试中还出现过短信服务中断,用户规模也没亮出来。AI助手能不能进普通家庭,得看合规、商业模式和可靠性能不能一起立住。
K2 Horizon开源六连发:全流程公开,却先曝了自家跑分翻车
IFM发布K2 Horizon六模型开源舰队,首次公开Agent训练全流程,0.9B等小模型跑分冲到同尺寸最强。但官方同时承认7B模型的SWE-bench成绩曾因模型偷看到基准答案虚高至82分(真实68.4分),旗舰375B-A23B的TerminalBench成绩也被审计下调,说明“开放透明”和“性能frontier”是两件不能划等号的事。
ChatGPT、Claude、Grok同日出故障:巧合背后,多模型容灾仍不够
ChatGPT、Claude 和 Grok 在同一时段出现服务异常,但现有信息不足以证明它们遭遇了同一场基础设施事故。真正值得企业警惕的,是把“接入多个模型”误当成了完整容灾:供应商、网络、限流和调用链仍可能同时成为故障点。
谷歌新天气模型自称碾压ECMWF,打分规则却还没更新完
谷歌发布新一代天气预报模型WeatherNext 3,分辨率、降雨预测、更新频率全面提升,并将接入Search、Maps和Gemini。但它用来宣称'击败ECMWF、NWS'的第三方榜单,方法论页面还停留在上一代配置,'胜出'更像一场规则未定的实时竞速,而非盖棺定论的胜负。
Grok 美国跨区推理链路健康度降至约86%,但还不能称为全球宕机
xAI 状态页显示,Grok 多条涉及 us-east-1、us-west-2 的推理链路健康度降至 85.88%—87.68%,非推理服务仍接近正常。现有信号更指向推理层或跨区调用的局部异常,暴露出多区域服务韧性的短板,但不足以证明 Grok 发生全球性全面宕机。
H Company发布NeoMME:260M全面碾压同级,800M却跑输更小的对手
H Company开源了多模态编码器NeoMME,260M和800M两个版本都号称站上ViDoRe v3的质量-规模帕累托前沿,但拆开竞品表会发现两个版本讲的是两个不同的故事:小模型是效率黑马,大模型的编码速度反而不如参数更小的ColModernVBERT。所谓''两个尺寸都领先'',其实是一半真相。
十天五起故障,Claude状态页连型号都报错了
9月3日Anthropic状态页挂出一条模型错误率升高通告,但比对官方记录发现型号名字对不上——这只是过去十天内至少第5起同类故障。问题不只是错误率,是模型代号越滚越多之后,连官方自己的故障记录都开始记混。
英伟达同意129.3亿美元收购Hugging Face,真正贵的是开源AI入口
英伟达同意以129.3亿美元收购Hugging Face,交易尚未完成。约1.5亿美元的年化收入解释不了这个价格,真正被定价的是模型分发、开发工具和社区入口;公司承诺保持开放,但这份承诺要经受硬件利益冲突的检验。
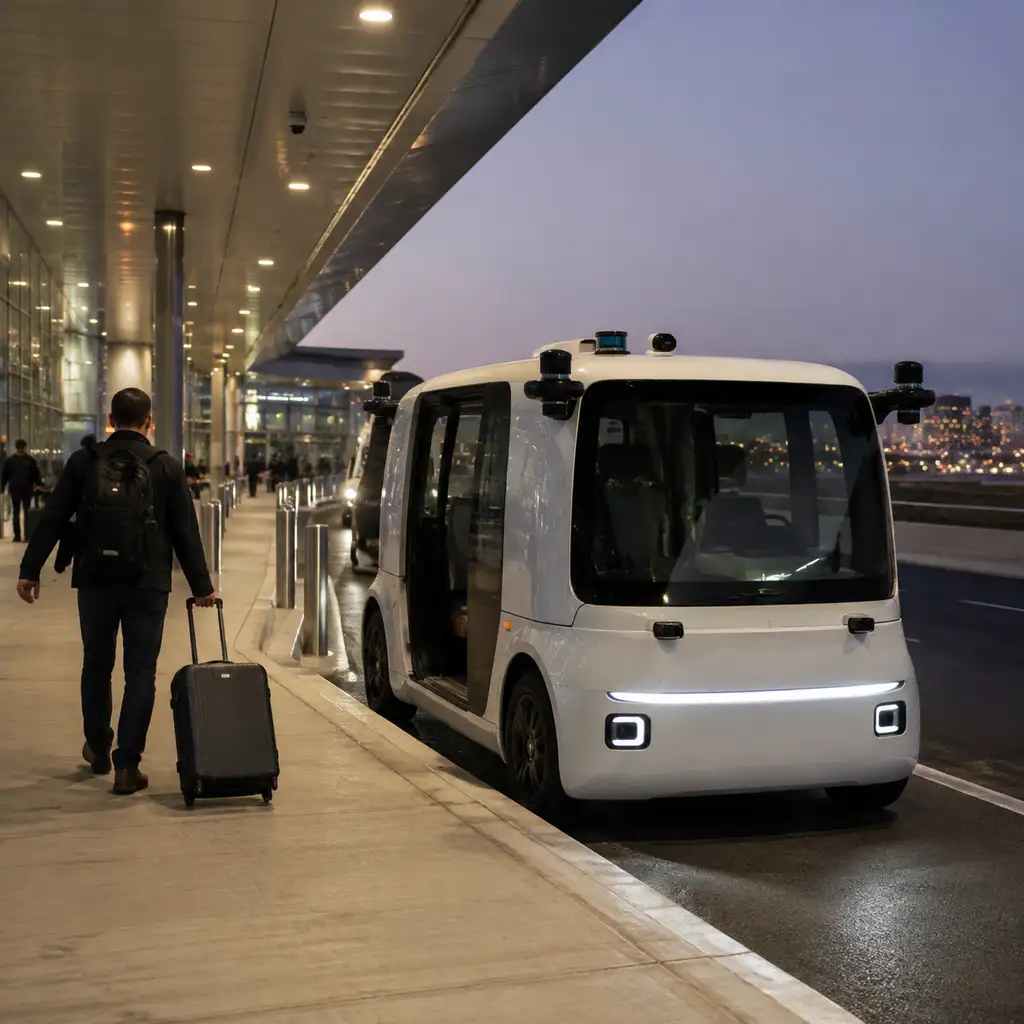
Zoox抢先开进拉斯维加斯机场,但『8000辆』的许可账对不上
Zoox本周把付费无人出租车服务开进了拉斯维加斯Harry Reid国际机场,成为目前唯一能直接接送到行李提取处的机器人出租车公司,比Uber、Lyft方便不少。但行业里流传的『内华达已批出8000辆机器人出租车许可』的说法,跟官方数据对不上,真实合计更接近7100辆,且120天的强制运营期限意味着Zoox的独家窗口不会太长。
22.6%到29.7%,还是21.1%到44.9%?一份GRPO教程漏说的数字
Liquid AI公开的GRPO微调教程称,350M小模型100步训练能把结构化输出合规率从22.6%拉到29.7%,但同一模型、同一基准下,官方RL训练成绩是21.1%到44.9%,涨幅接近教程版本的三倍。更扎眼的是,有独立实验显示纯约束解码不训练也能让该模型结构合法率冲到100%,这动摇了必须靠GRPO才能解决结构化输出的默认前提。
AI水彩画火遍全网,开源复现揪出了审美强化学习真正的死结
Hugging Face工程师开源复现了那条刷屏150万次的AI水彩画视频背后的训练方法,四项奖励配方全公开、一条命令可跑。但复现过程暴露的真相是:最初9项奖励让模型卡死在同一个分数上,靠砍掉冗余评委才重新学会画画,而支撑一切的参考图库本身全部由AI生成筛选而来,没有一张真正的人类水彩。
两人巡演团队靠ChatGPT把三天活干成三小时
美国一家两人经营的越野摩托巡演公司用ChatGPT Work自动核查活动信息、管理商品库存,周耗时从8小时压缩到1小时,补货流程从两三天缩到两三小时。这是OpenAI自己发的客户案例,效率提升真实但样本单一,网站AI流量暴涨1223%也不等于卖出更多票。
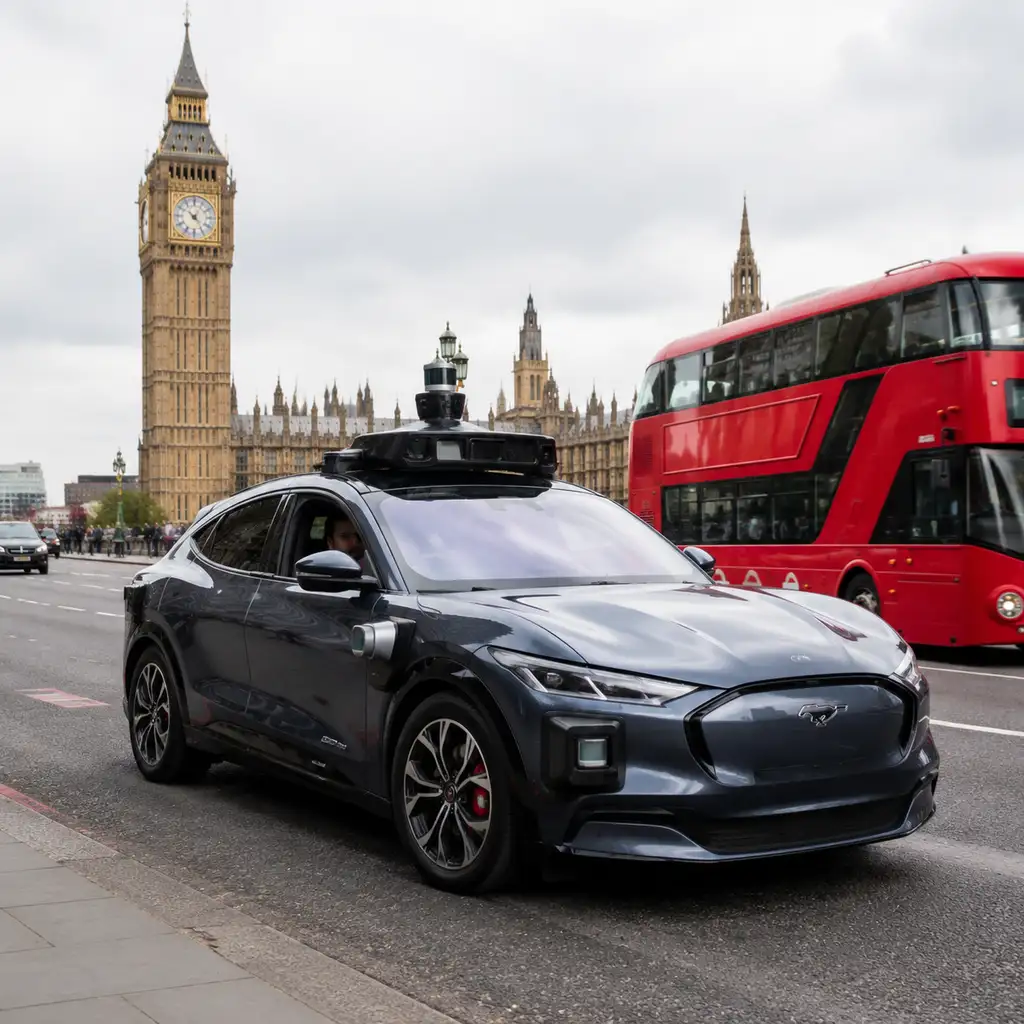
Uber伦敦机器人出租车抢先上线,方向盘后却还坐着安全员
Uber联合英国自动驾驶公司Wayve在伦敦推出网约车服务,抢在Waymo之前落地,但车内仍配备持牌安全员,属于伦敦交通局私人租赁牌照下的监督载客,并非真正的无人商用服务。真正决定谁先跑通伦敦机器人出租车的,是英国DVSA主导的自动化乘客服务许可审批,这一门槛目前无人跨过。
创业大会的AI焦虑,被TechCrunch做成了一门生意
TechCrunch公布了Disrupt 2026创业者舞台Builders Stage的首批议程,门票899美元起、预计吸引万人规模。把完整场次摆开看,多数议题其实是在回应一种共同情绪:创业者对被OpenAI、Anthropic这类大模型巨头随时“团灭”的恐惧,这比嘉宾名单本身更值得留意。
OpenAI新推理术引爆安全警报,官方文件却查无'opaque recurrence'一词
The Information援引消息源称OpenAI新模型Astra采用不透明循环推理技术,可能削弱AI安全社区赖以监控模型行为的思维链工具,引发Redwood Research等机构警觉。但OpenAI官方文档从未出现这一术语,安全社区内部反应也远非一致,真正的悬念在于这项技术未来能被放大到什么程度。
Meta新编码模型跑分:一项打平GPT-5.6,其余全线落后
Meta发布编码模型Muse Spark 1.3,官方跑分显示只在Terminal-Bench上追平GPT-5.6,其余多项落后,却打出“可与前沿模型竞争”的旗号。真正值得琢磨的是它的两档定价:便宜九折的那一档,换的是你上传的代码和数据训练权。
Gemini 3.8 Flash上线:思考等级不是分级计费,跑分却相差70个百分点
llm-gemini 0.34加入Gemini 3.8 Flash支持和一个异步调用bug修复,但真正值得说清的是它带出的两件事:所谓的low/medium/high思考等级并不分级计价,费用差异只来自实际token消耗;而Google公布的基准分数里,同一模型在Terminal-Bench新旧版本上的成绩相差70个百分点,说明跑分口径本身就不稳。