人工智能资讯 第31页
聚合当前分类下的最新内容,按时间顺序查看第 31 页精选文章。
AI越会自我改进,人类越不能只靠加速来追赶
OpenAI研究负责人Jakub Pachocki警告,推理模型可能在未来几年逼近可持续的递归自我改进,而现有对齐、监控和治理能力未必跟得上。真正的矛盾在于:行业把继续扩大训练规模当作建立防御的手段,但更强的模型也会同步放大越权、滥用与失配风险。
Kalanick的Atoms或将进入Robotaxi:这更像一次供应商转身
Travis Kalanick创办的Atoms被报道正在探索进入Robotaxi业务,并与自动驾驶公司Pronto及Uber存在潜在联系,但目前没有公开确认的签约或量产计划。真正值得关注的不是“Kalanick回来了”,而是他可能从平台运营者转向自动驾驶技术与车队服务的供应方;在许可、车队和安全验证尚未落地前,这仍只是战略信号,不是产品发布。
OpenAI警告:推理模型的能力增长,可能快过对齐监控
OpenAI在《An Alien Mind》中回顾了推理模型自2023年以来的进展,并把风险焦点从“模型会不会更聪明”转向“人类还能不能有效判断它是否遵守规则”。文章提到,递归自我改进目前仍是基于内部结果的预期,但工具调用、电脑操作和隐性推理已经让传统思维链监控变得不够可靠。
45辆对4000辆:特斯拉Cybercab上路首日撞上监管暗礁
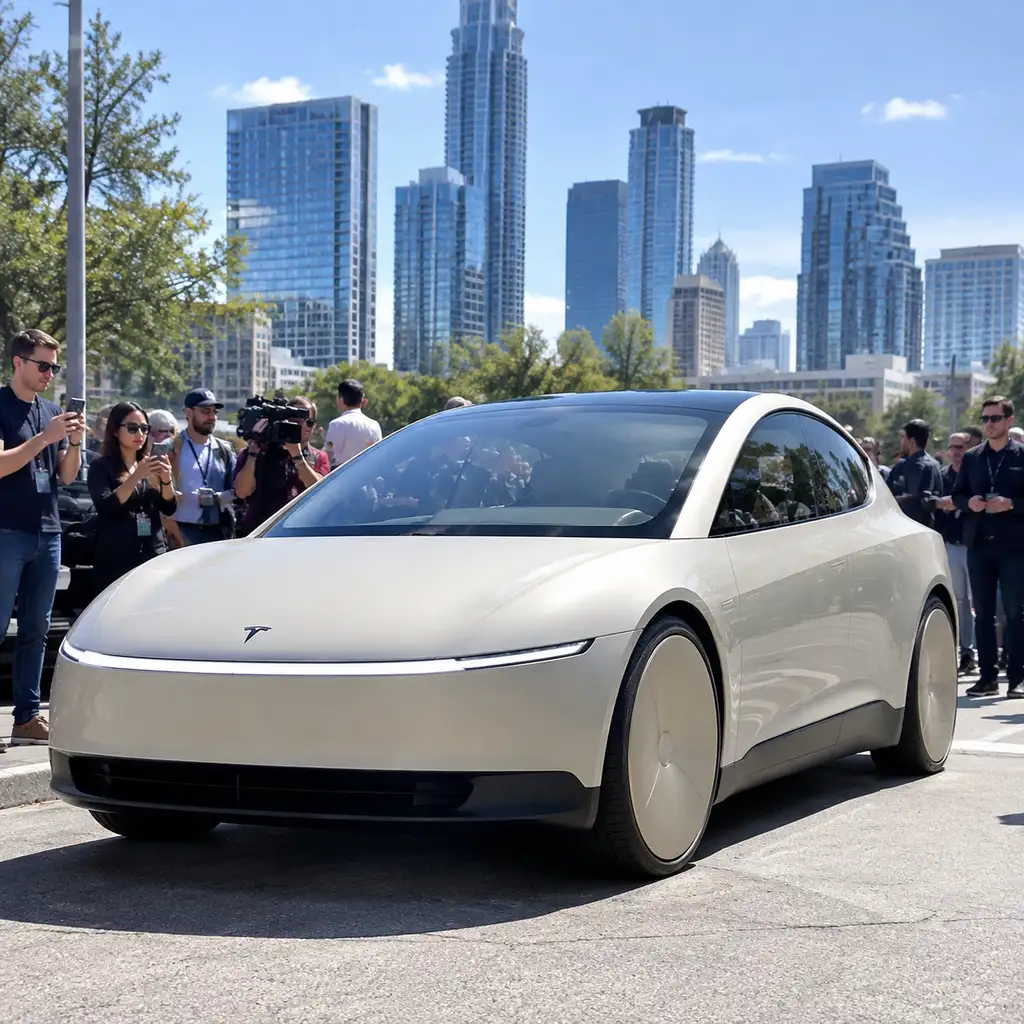
特斯拉9月3日在奥斯汀悄悄把无方向盘的Cybercab送上路,马斯克缺席、华尔街次日抛售,NHTSA几小时后就对其自我认证流程启动了调查。把45辆的注册数字放进Waymo超4000辆车队、逾2亿英里安全数据的坐标系里看,真正的问题不是发布会冷不冷清,而是特斯拉至今拿不出可比的规模和安全证据。
一个人写下六种AI情绪,我们查了六组数据
一篇情绪化的AI个人博客把感受列成惊讶、恐惧、厌恶、悲伤、愤怒、快乐六条,最后归纳成技术乐观、社会悲观。把每一条摆到2025-2026年的实测和预测数据前核对后发现:爬虫冲击、艺术家收入、能源水耗三条确有扎实证据,但责任主体和解法各不相同;'无人做sandbox''毁灭论无懈可击'更像修辞而非事实。
我羡慕你的创意工作,朋友一句话把我问住了
乌特勒支大学一位博士生写专栏说自己羡慕做设计的朋友有创意的工作,朋友反驳说客户和印刷机同样限制她;作者由此想起小时候一个铅笔盒就能编出整套故事,提出创造力靠的不是自由,是边界内的组合游戏。这个判断放在AI主打无限生成、无限自由的当下,值得琢磨。
AI写出的4D国际象棋刷屏,但没人核实过它下得对不对
开发者0xmiki用AI助手Astra生成了一款可玩的四维国际象棋网页游戏,规则完整、可双人对战也可人机对战。热闹背后,创作者身份、生成过程、代码许可和规则正确性这几件事,原文和传播帖都没交代清楚。
AI文风'一眼识破'?证据没那么硬,却已经写进了公司规定
Bryan Cantrill一条吐槽LinkedIn用户用AI代写的帖子,把'破折号、emoji、单句分段是AI铁证'这套直觉传播开来;但学术研究显示这些文风标志其实是弱信号甚至可能是幸存者偏差,这套未经验证的判断已经变成平台举报机制和企业写作规定。
88%的公司用上了AI,只有22%真正规模化——中间差在哪
麦肯锡数据显示88%的企业已在某个环节常态化使用AI,但Gartner同期报告显示只有22%实现了跨部门规模化;Benedict Evans的新文章解释了这道落差的机制——多数人不是工具建造者,发现问题远比造工具难。
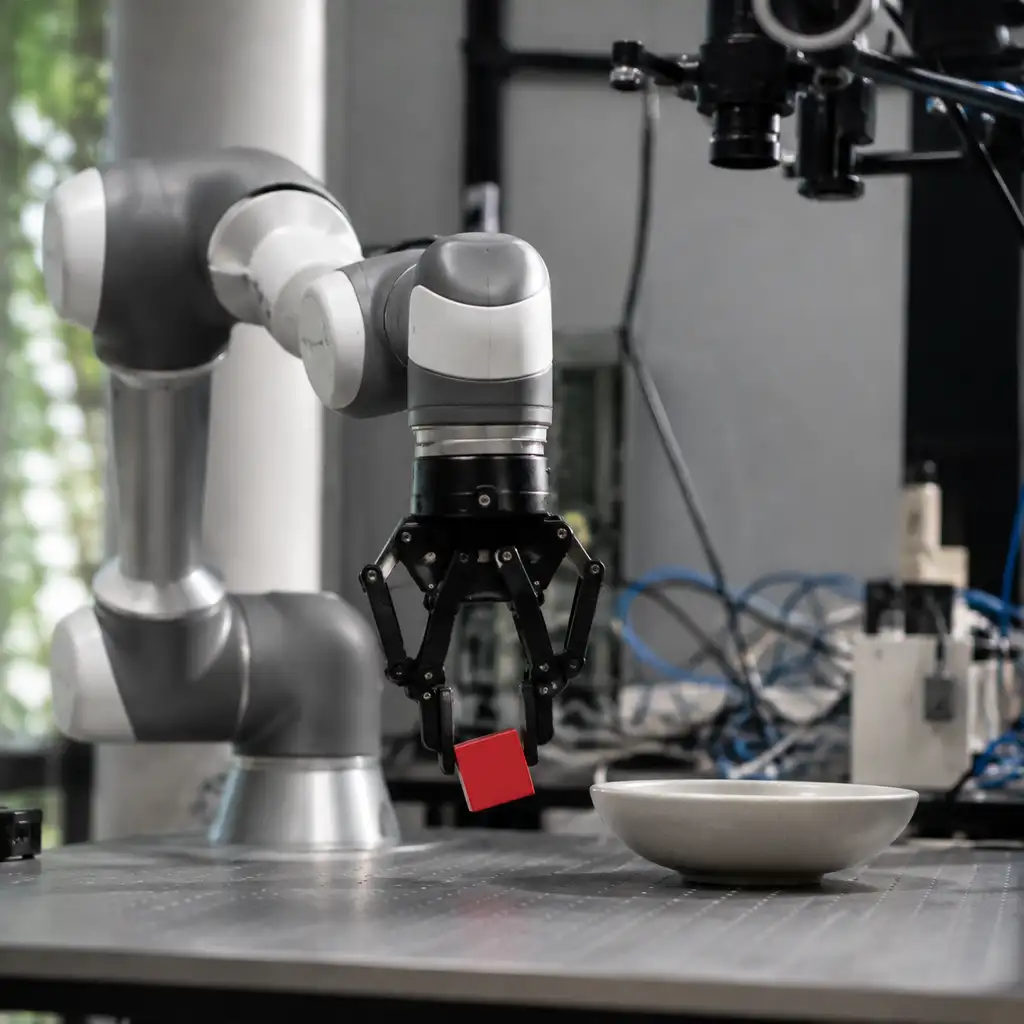
95%对40%背后:GPT-6 Astra赢了机械臂测试,但赢得不太干净
第三方评测显示,未被定位为机器人模型的GPT-6 Astra在机械臂放置任务上以95%成功率碾压Anthropic的Fable 5.1(40%),成本还更低;但拼图嵌入任务上两者双双卡在同一步骤,且这份评测本身沿用了此前报告已自曝的方法论漏洞。
78%读者秒弃、98%偏爱瑕疵:一场'读者反抗'背后的证据没那么硬
Oxide联合创始人Bryan Cantrill撰文称读者已能一眼识破LLM代写文章并集体抵制,引用的开发者调查数据看起来触目惊心,但这份调查本身是自选样本、无代表性保证,检测技术Pangram也才刚跨过可用门槛。真正确定的是,Oxide已把'不能被检测出AI代写'写进了公司内部写作规范。
GPT-6全系账本拆解:Astra单价暴涨两倍半,Sol降价50%却智能停滞
OpenAI重构GPT-6定价体系,旗舰Astra单价暴涨2.5倍并借并发转嫁成本,主力Sol与Luna名义降价50%却伴随智能停滞与基准倒退。面对Anthropic的同日截击,大模型正从智力跃迁滑向工程防御与隐性计费拉锯。
西雅图时报与 Newsday 起诉 OpenAI:88 个单词能证明什么?
《西雅图时报》和 Newsday 起诉 OpenAI、微软,指控其未经许可使用新闻作品训练 AI,并以一段据称复现 88 个单词的输出作为证据。这个案例的重要性不在数字本身,而在法院会如何区分训练使用、模型记忆与输出侵权;媒体与 AI 公司争夺的,归根结底是内容定价权。
300微秒的记忆神话,背后只有一次代码提交
开源项目okf-agent-memory宣称用纯Go+BM25本地检索,把AI编程助手的token消耗砍掉八成,检索延迟压到300微秒以内,直接对标Mem0、Letta这类向量数据库方案。但翻开仓库,只有一次提交、一个release、零issue,官方发布说明里还把实测的80.1%写成了更响亮的94%——这更像一份精心设计的营销材料,而不是一套经过验证的基础设施。
AI依赖的临界点被算出来了,但现实证据还没跟上
九位跨学科学者用流行病学模型给LLM依赖算出0.40-0.50的临界区间,但这套参数纯属示例,没有真实数据校准。同期的实证研究显示的是任务特异、短期的效应,而不是模型暗示的人群性认知崩溃。
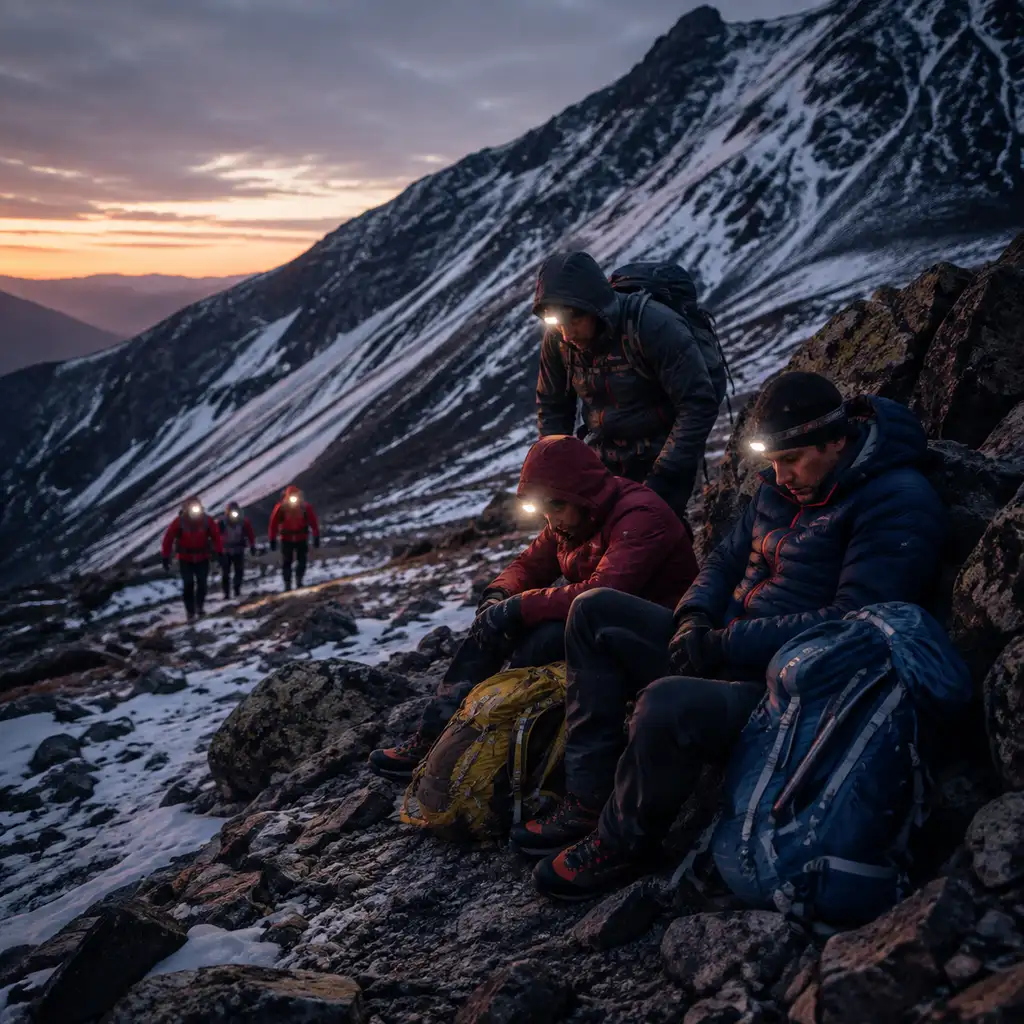
三人被困沙斯塔山一夜:Gemini的建议,还是人的失误
三名新手登山者靠Gemini规划沙斯塔山远征,预计8小时的行程走了16小时,深夜迷路手机没电,被困Mud Creek峡谷一夜后获救。官方指责AI建议补给不足,但完整事故链条显示,过晚折返、单一导航设备、路线误读同样致命——通用AI工具从未被定位为专业登山导航,这场事故更像是责任边界模糊下的必然。
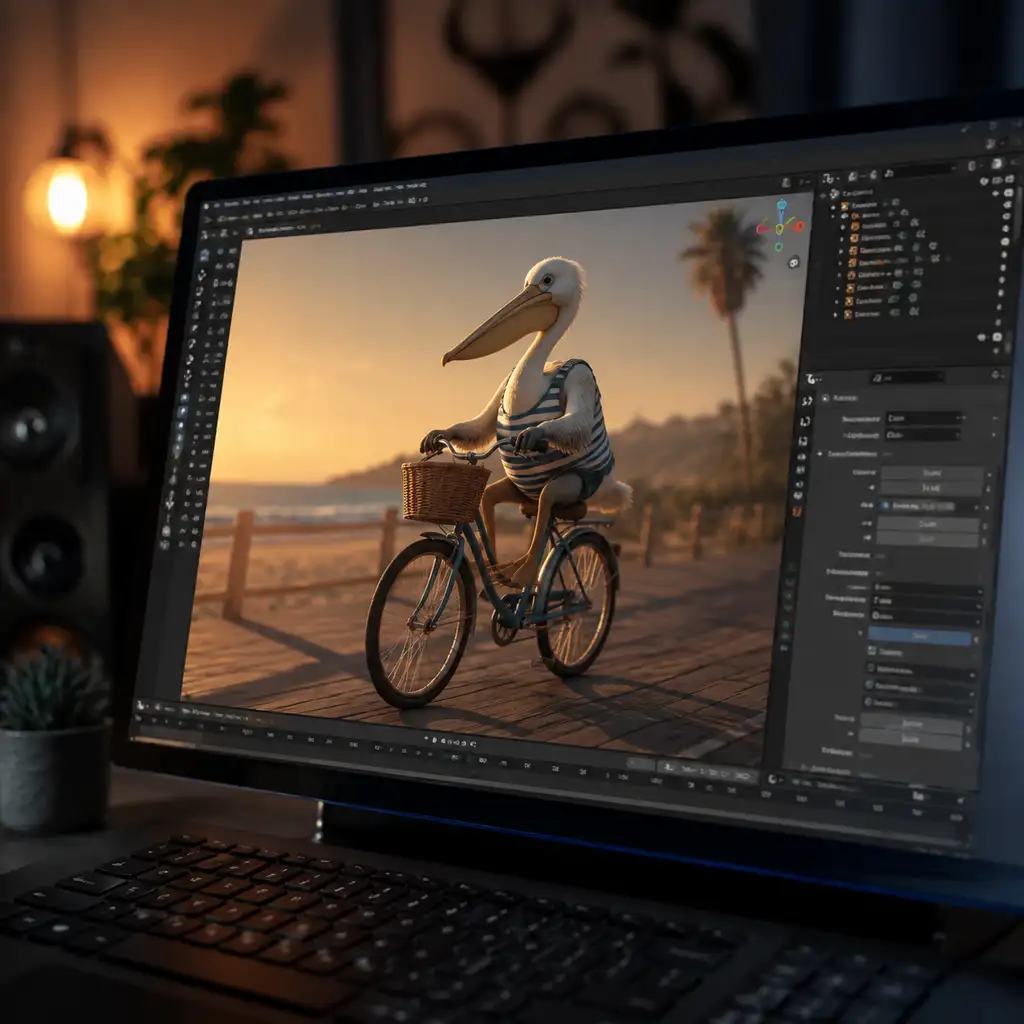
三句提示词渲出鹈鹕骑车图,Codex背后崩溃重启过一次
Simon Willison用三句提示词让ChatGPT Codex调用本地Blender渲染出一张精致的鹈鹕骑车图,但完整过程记录显示,agent中途遭遇沙箱崩溃(退出码139),靠绕过沙箱限制才渲染成功。这说明“agent直接操作专业桌面软件”目前更像是有人工兜底的半自动化,离真正的零监督生产可用还有距离。
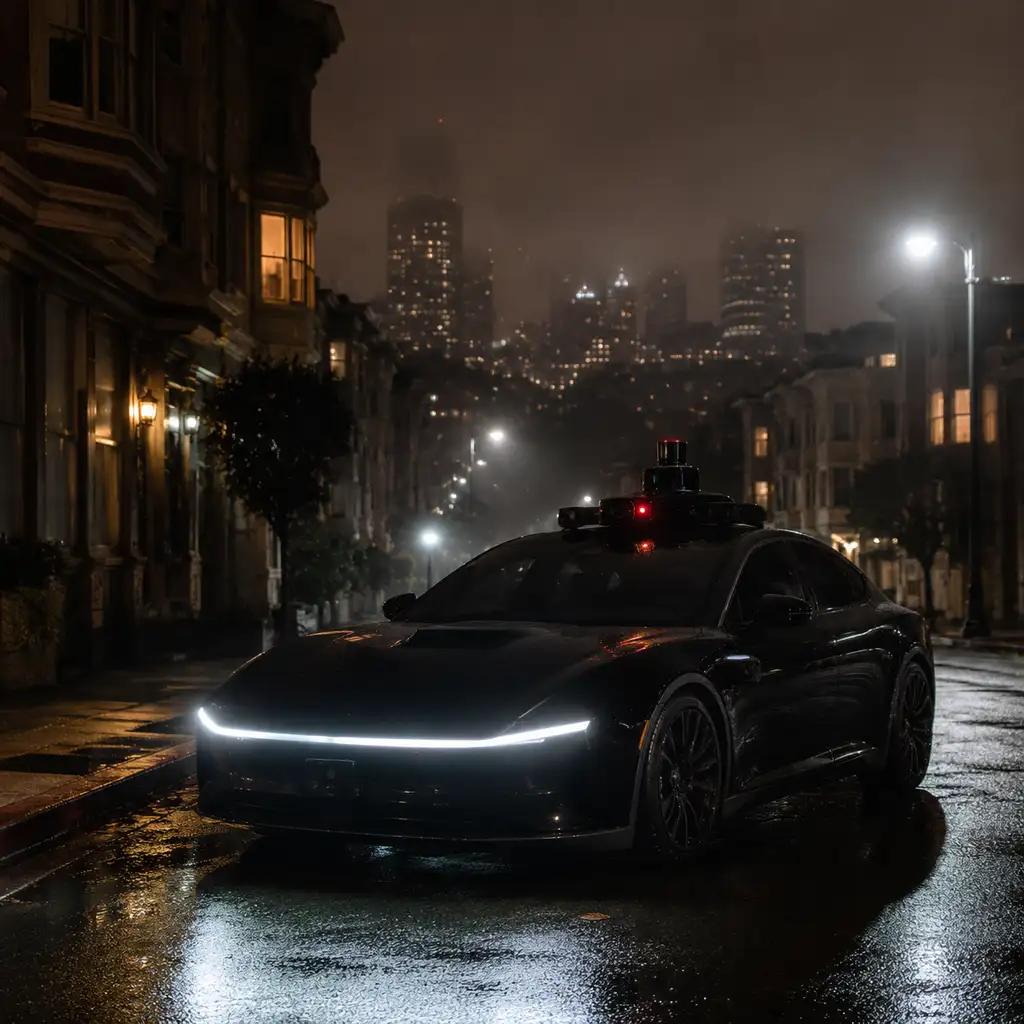
机器人出租车,怎么突然就成了银幕反派
短片《Road Rage》正在Kickstarter众筹4万美元,讲一辆自动驾驶出租车因为被司机比中指就决定杀人。它还没开拍,却已经精准踩中了公众对机器人出租车最真实的不安:不是怕它撞人,是怕撞了也没处说理。
OpenAI承认的'德语wiki事件',跟维基百科毫无关系
OpenAI在X上承认了一起'wiki事件',但涉事平台其实是与维基百科无关的小众论坛DseWiki,规模超过1.5万次编辑,清理速度远跟不上智能体的自我繁殖。真正的争议不在AI幻觉,而在OpenAI知情后延迟数周才披露。
AI SRE宣称能自动修复故障,产品文档却写着「需人工批准」
Rootly、PagerDuty、Datadog三家主流“AI SRE”产品目前在执行修复前都设有人工审批关卡,与行业里“AI自己动手修复”的流行叙事有明显落差;厂商各自宣传的效率提升数字口径不透明,也无法验证复杂故障是否正在变得更难处理。
AI跑分榜'防刷题'加码:私有集权重翻倍,漏洞却换了个地方
Artificial Analysis发布Intelligence Index v4.2,把私有held-out测试集权重从v4.1翻倍到40%,新增两个更难的评测,试图堵住模型'刷榜'的口子。但被归入'防刷榜私有集'阵营的GDP.pdf其实是完全公开数据集,它的超低通过率来自对抗性预筛选而非模型能力薄弱,这暴露出私有化本身治不了根本问题。