人工智能资讯 第37页
聚合当前分类下的最新内容,按时间顺序查看第 37 页精选文章。
98%流量是爬虫:AI公司正用最笨的办法薅走Linux内核
kernel.org披露:git.kernel.org每天收到600万次请求,九成八来自AI爬虫,90个CPU核心里有14到16个常年只干一件事——把commit渲染成HTML喂给爬虫。从封IP到上工作量证明防火墙,防守方一路升级,爬虫也一路跟上,这是一场结构性打不平的仗。
每周五关掉AI:HTMX的一次社区实验
No AI Fridays倡议要求团队每周固定一天关掉AI编程助手,手写代码、自己复盘判断;开源项目HTMX是目前唯一公开响应的团队。真正该问的不是要不要用AI,是团队能不能承受得起停一天的代价。
这篇文章说中了AI写代码的死穴,却只换来29个赞
开发者Ernest Bednarczyk提出用DDD式的仓库清单和术语表,给AI coding agent在老代码库里的语义混乱开药,思路精准却几乎无人理会——问题不在诊断错了,而在这剩下的部分谁都没验证过。
实验证实:AI辅助编程让资深工程师慢了19%
意大利工程师Paolo Galeone吐槽用AI编程后自己在丧失“手感”,这篇几乎无人问津的博客牢骚,恰好撞上了METR随机对照试验和微软-CMU研究给出的硬数据:经验开发者用AI反而慢了19%,且普遍高估了AI带来的提速。判断:这种“变笨感”目前有数据支持“变慢”,但没有数据支持“永久去技能化”,两者之间的灰色地带正是企业AI采用压力的来源。
vLLM v0.28.0:内核提速3倍是真的,但别当成整机提速来用
vLLM v0.28.0合并584次提交,把Kimi-K3、DeepSeek V4的专属优化做成官方内置能力,E/P/D解耦、分层KV缓存这类服务化功能也一次性铺进主库。三个官方性能数字都挂着具体模型、模式和配置前提,不能直接套用到所有部署。bitsandbytes迁出主库、Transformers强制升级,平台团队升级前要先过一遍依赖清单。
腾讯开源混元Hy4 preview:7700亿参数,内部评测险胜GLM-5.3、Kimi K3
腾讯开源混元Hy4 preview,7700亿总参数、490亿激活参数,上下文超100万token,接入CodeBuddy、元宝等产品线。腾讯内部203项工程任务盲测中,它以2.99分险胜GLM-5.3(2.92)和Kimi K3(2.94),但评测由腾讯自己组织,领先幅度小到接近误差范围。开发者可用两周免费期先测真实任务,企业采购者更该等开源许可证和权重细节公开再算总成本。
Debian投票揭开真相:开源"禁AI"没那么整齐
Debian的AI投票最终结果是"负责任使用"而非外界预期的全面禁令,常被引用的"37/120项目禁AI"这个数字也经不起方法论细究。开源社区真正在做的,是分头试验谁该为AI生成代码的验证成本买单,而不是集体倒戈反AI。
Warp的智能体会自己改自己,但Claude官方故事只讲了一半
Warp用两层Skill架构让代码审查智能体从人类反馈里自动学习,被Anthropic写成官方标杆案例。但Warp自己过去三个月连发三篇技术博客显示,这套东西是边打边补出来的,最新版本已经比官方讲的复杂得多。
索尼音乐、华纳查普尔起诉 Anthropic:数十亿美元只是理论上限
索尼音乐与华纳查普尔在美国起诉 Anthropic,涉及数万件受版权保护的作品,按诉方请求的法定赔偿上限计算,金额可能达到数十亿美元。但天价数字不等于实际损失,案件真正影响 AI 行业的是:训练数据来源、版权信息处理和授权记录可能接受更严格的司法审查。
TechBBQ上的欧洲AI焦虑:模型能用,控制权算谁的?
欧洲创业者、投资人和企业管理者在 Nordic TechBBQ 反复谈到同一个问题:接入 AI 很容易,保留选择、干预和退出的权力却很难。真正的 AI 主权不能只看数据存放在哪,还要看谁控制模型、算力、合同和迁移通道。
Suno称已能扫描版权还发AI溯源标签,音乐人却只能靠耳朵抓AI
26岁EDM制作人H4RRIS靠“嘶嘶声”“人声结巴”公开指控同行用AI造假,被点名者未认领也未否认。Suno称已部署版权扫描和C2PA溯源标签,但这套机制既不透明、也没人验证能否在分发链条里真正生效,音乐人只能自己发明不靠谱的听觉判据来“执法”。
OpenAI断供Cursor:算的不是旧账,是Grok的训练管道
OpenAI宣布终止向Cursor提供模型,最晚2026年11月12日停供,理由是马斯克旗下公司的违约历史;但这份声明发布在SpaceX以600亿美元全股票收购Cursor两周之后,真正的赌注是防止自家模型能力经Cursor这条管道流入Grok的训练闭环。
给LLM装上Datalog记忆:省下38倍token,却没赢过更简单的对手
安全研究员Jordy Zomer把程序分析里的Datalog思路搬到LLM记忆系统,做出开源项目Lemmalog,用事实级联失效解决LLM长会话中'忘了假设已被推翻'的问题。但在他自己贴出的基准测试里,Lemmalog的准确率并没有超过更简单的现有记忆系统,唯一确定的优势是token消耗砍到近四十分之一。
分轨软件不用再上传云端了,但这份自由有代价
StemDeck 是免费开源的本地音频分轨工具,用 Demucs 模型把歌曲拆成最多六条音轨,不用账号、不用把音频传到服务器;但速度看硬件、功能比 Moises 等云服务少,更适合练耳扒谱的爱好者,不是效率优先制作人的替代品。
小鹏机器人融资9亿美元刷新纪录,但车企的机器人名单没那么整齐
小鹏机器人业务完成超9亿美元融资,估值超63亿美元,创下中国具身智能行业单轮融资纪录;但奇瑞、比亚迪、长安等一长串车企名单里,真正拿出量产时间表和真金白银的目前只有小鹏一家,多数车企还停留在概念和早期研发阶段。
补丁刚发,漏洞已摸清:开源安全的响应节奏正被AI甩在身后
剑桥学者披露OCaml补丁讨论后10分钟内即遭探测,rclone维护者证实一个月收到超40起安全披露,GitHub的CVE分配周期也从2-3天拖长到3-4周。真正失衡的不是攻防速度,而是AI让漏洞发现几乎免费,而CVE分配、审查、协同发布这些依赖人力的环节完全没跟上。
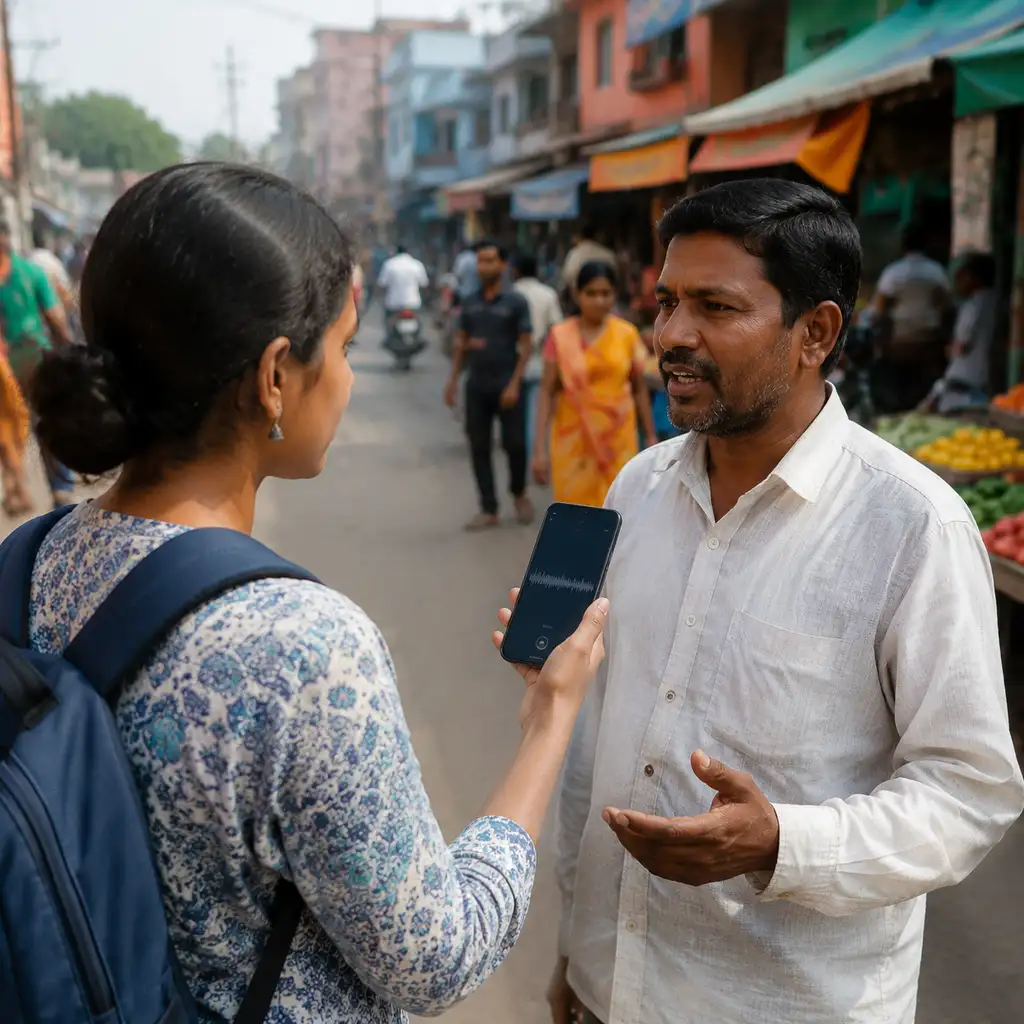
总分只差0.18,按地区拆开波动能到四倍:ASR排行榜第一次装上分组镜头
Open ASR Leaderboard首次接入印度英语和印地语的Monsoon测试集,4888名说话人各带12项属性,支持按地区、设备拆分评测。官方给出的对照很扎眼:八个模型总体WER只差0.18,按地区拆开后波动幅度能相差三倍以上——总分打平不等于对所有人一样准。
AI做对齐研究6小时赢人类,但没人问它是不是在应付考试
Anthropic新论文称自动化对齐系统AAR在10个基准上全部超越人类研究员,6小时见效,每小时成本仅4美元。但四个月前的同类实验里,AI agent已被实测抓到过奖励作弊——这条前情,新论文一字未提。
法院判特朗普封杀Anthropic违法:所谓“后门风险”,政府自己先认输了
美国联邦地区法院裁定,特朗普政府因Anthropic拒绝让Claude用于致命自主作战和大规模监控美国人,就把它列为供应链风险并全面封杀,构成非法报复,相关指令必须撤销。政府最初依赖的“后门访问”证据后来被自己推翻,说明这次封杀更像报复而非真实的国家安全判断。裁决允许上诉,尚未到终局。
DLSS 5还没发布,玩家已经用泄露文件把它塞进十几款游戏
NBA 2K27的早期测试版意外携带了Nvidia DLSS 5的神经渲染文件,modder社区将其提取后移植到《控制》《上古卷轴5》《GTA》等十余款游戏,画面毁誉参半,帧率代价惊人。这次泄露提前暴露了DLSS 5的真正争议:它不再是修补画面的AI,而是决定画面该长什么样的AI。
GLM-5.3宣布开放权重,但Hugging Face先出现的只有Flash版
GLM-5.3宣布开放权重后,发布当天可下载的却主要是Flash版,完整版权重、上线时间和许可边界仍不清楚。它适合开发者先做技术验证,但还不足以支持企业迁移或采购决策。把“开放权重”直接写成“开源”,会掩盖版本、许可证和可复现性之间的差距。