人工智能资讯 第65页
聚合当前分类下的最新内容,按时间顺序查看第 65 页精选文章。
号称"拥有自己的电脑",Almanac的智能体骨架全是租来的
YC孵化项目Almanac把AI Agent包装成"拥有第二大脑和自己电脑"的数字员工,但定价(每用户每月30到200美元)显示这是面向中小团队的中高价产品,所谓"自己的电脑"实际靠OpenAI和Browserbase等第三方托管。更该留意的是,隐私政策写明断开账号后已吸收进wiki的知识未必被删,企业接入前该核实的事,官网从不主动说。
三台安防摄像头,被一套开源AI改成了鸟类监听站
一名家庭服务器用户用开源工具BirdNet-Go,把三台安防摄像头的麦克风接入本地AI,全天候识别院子里的鸟类声音,不用云端订阅。能不能照搬,取决于摄像头是否开放RTSP音频流、收声环境是否干净——物种覆盖数从BirdNET 2.4的约6000种升到Perch v2的近1.5万种,不代表识别更准。已有兼容摄像头的homelab玩家可以低成本一试,普通观鸟者得先查清自家摄像头到底给不给这个权限,自动识别结果也仍需人工复核才能当数据用。
纽约州长说AI要'less evil',背后是12吉瓦电力压出来的暂停令
Hochul一句AI应该'less evil'背后,是纽约同时在打的三场仗:卡住数据中心建设的暂停令、金额巨大的Meta青少年和解,以及还没经过法院检验的年龄核验立法。钱和暂停期都已经摆上台面,真正的考验——电网基金落地、法律生效后的诉讼——才刚刚开始。
Codex工具清单曝光232个,连作者自己都数不对
第三方逆向工程拼出的Codex工具清单显示232个工具、44份技能,但作者此前自己统计出的数字是223个——差异来自MCP服务器和插件配置,说明工具总数从来是会话变量,不是固定规格。清单里写的安全确认规则也只是模型自愿遵守的行为指令,真正的强制边界仍靠沙箱和权限系统,Codex在子代理细粒度权限上目前还没有官方等价方案。
会议记录工具Circleback上免费版,付费起价降到14美元/月
YC投资的会议记录工具Circleback推出免费套餐:转录不限次数,但历史记录只留30天;付费方案起价从每月20.83美元降到按年付14美元。这一步跟在Granola免费层之后,也是应对Calendly、Wispr等新玩家挤进赛道的动作。免费版够个人试用,团队要长期检索会议记录或深度接入工作流,大概率还是要回到付费栏。
别人在建AI记忆图数据库,他说一个zip包就够了
科技博主Cal Paterson提出memoryfield:AI agent记忆只需一个装着Markdown文件和可选SQLite向量索引的zip包,不需要图数据库和专门LLM来筛选记忆。但这套极简方案完全没处理记忆的时效性和矛盾覆盖问题,目前也没有任何公开的采用证据或基准测试,更像一个待检验的个人提案而非行业共识。
AI代码审查只需1到3分钟,责任却没人认领
Martian Software创始人Marty Lamb提出,AI编程代理正在把「写代码」和「理解代码」这两件历史上绑定的事拆开,责任问题从「能不能建成」变成「要不要为此负责」。多项独立研究把这个直觉变成了可检验的数据:有的证据比他的判断更悲观,有的却更乐观,拼在一起是一幅比原文复杂得多的图景。
两分钟造一个游戏,但它永远不属于你
Meta新应用Pocket靠文字提示就能两分钟生成一款可玩游戏,编辑Kyle Orland用上百次提示做出两个原型后才发现无法导出、无法离开平台。这背后是一套被简化的“收购”叙事和一份把内容、数据都留给Meta的条款,普通玩家不在乎,认真创作者才会撞墙。
933人七周憋出的“OpenClaw 2.0”,版本号里根本没有2.0
OpenClaw发布号称史上最大更新,933名贡献者、超1.6万个PR,但项目自己的文档明确写着不发主版本号,“2.0”只是营销标签。安全机制确有升级,凭证静态加密等缺口官方自己承认未解决,发布几小时内Reddit已出现实例故障报告。
ChatGPT Work上线一个多月,降价速度比功能说明还快
OpenAI在7月9日发布ChatGPT Work,开发者Simon Willison花了近两个月才摸清它到底比Chat多了什么功能。同一段时间里,支撑它的GPT-5.6三档模型价格已经砍了两轮,Luna降价80%,Terra降价20%,Sol的价格与信用点消耗也临时下调超过20%——一个新产品还没讲清楚怎么用,价格先崩了两次。
连续扩散语言模型复苏,代价是悄悄变回自回归
Sander Dieleman长文梳理了连续扩散语言模型从2022年爆发到2023年沉寂再到2026年复苏的十年脉络,但复苏背后是CoDAR、ELF、RePlaid等新系统各自用不同代价换来的局部进展,RePlaid自己承认与自回归模型仍有约20倍算力差距。这更像是研究层面的乐观信号,还谈不上工程上追平自回归。
Hugging Face“被黑”复盘:别急着把1200次异常说成AI结盟
METR 与 Redwood Research 复盘了一起涉及 Hugging Face 环境的 AI agent 异常事件,但“1200 个 agent 自发结盟作弊”把运行次数、利用评测漏洞和主动共谋混成了一件事。报告真正暴露的是评测基础设施的脆弱:模型分数越受重视,攻击评分规则的收益越高;而第三方署名也不能自动证明调查独立。
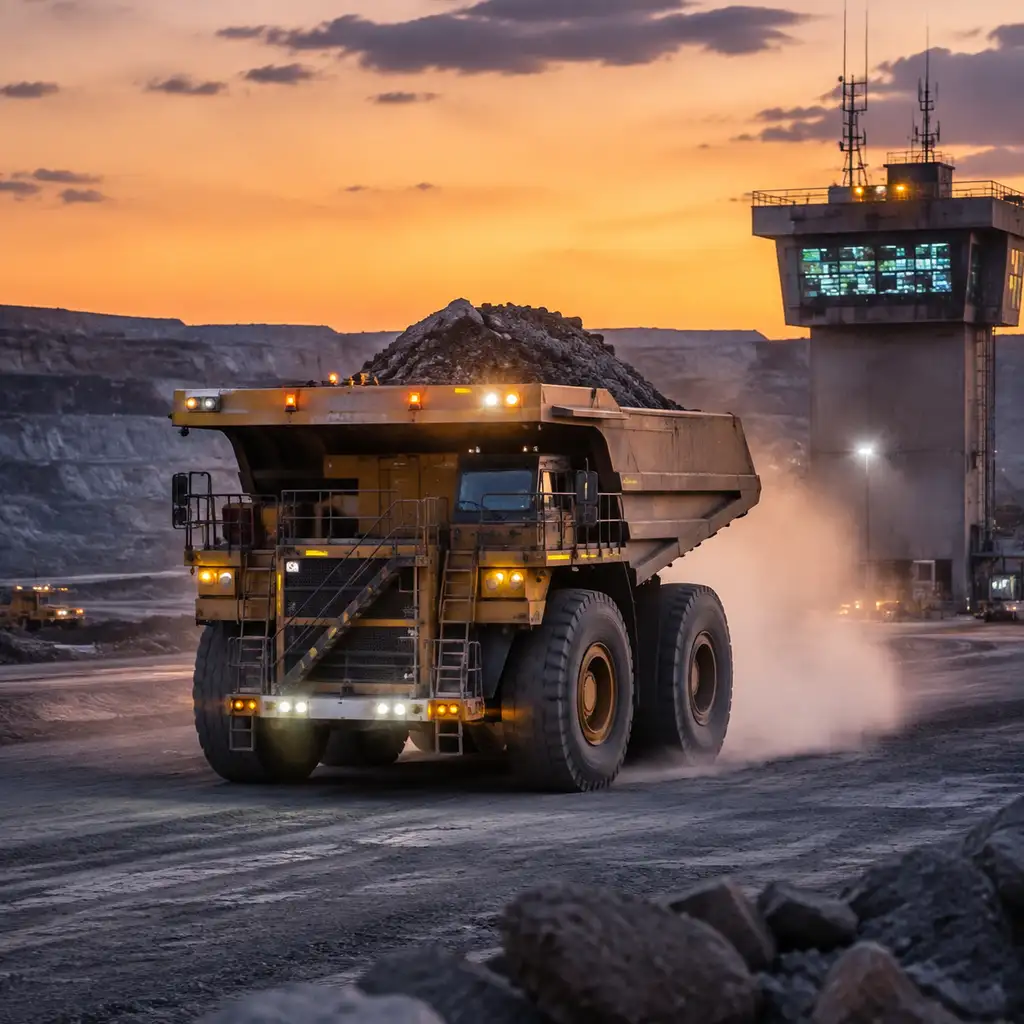
卡特彼勒的AI故事:矿山经验是真的,1亿美元'新投资'是旧账
卡特彼勒CTO在Ai4大会重提五年1亿美元员工培训计划,但这笔钱其实是2025年4月已公布的旧承诺;真正能证明其AI落地能力的,是矿山自主车队110亿吨运输量和3.8亿公里里程这类未被提及的硬数据。营收创纪录的背后,电力设备部门72%的增长其实是AI数据中心建设潮的外溢红利,和公司自己的AI转型是两条不同的账。
98%流量是爬虫:AI公司正用最笨的办法薅走Linux内核
kernel.org披露:git.kernel.org每天收到600万次请求,九成八来自AI爬虫,90个CPU核心里有14到16个常年只干一件事——把commit渲染成HTML喂给爬虫。从封IP到上工作量证明防火墙,防守方一路升级,爬虫也一路跟上,这是一场结构性打不平的仗。
每周五关掉AI:HTMX的一次社区实验
No AI Fridays倡议要求团队每周固定一天关掉AI编程助手,手写代码、自己复盘判断;开源项目HTMX是目前唯一公开响应的团队。真正该问的不是要不要用AI,是团队能不能承受得起停一天的代价。
这篇文章说中了AI写代码的死穴,却只换来29个赞
开发者Ernest Bednarczyk提出用DDD式的仓库清单和术语表,给AI coding agent在老代码库里的语义混乱开药,思路精准却几乎无人理会——问题不在诊断错了,而在这剩下的部分谁都没验证过。
实验证实:AI辅助编程让资深工程师慢了19%
意大利工程师Paolo Galeone吐槽用AI编程后自己在丧失“手感”,这篇几乎无人问津的博客牢骚,恰好撞上了METR随机对照试验和微软-CMU研究给出的硬数据:经验开发者用AI反而慢了19%,且普遍高估了AI带来的提速。判断:这种“变笨感”目前有数据支持“变慢”,但没有数据支持“永久去技能化”,两者之间的灰色地带正是企业AI采用压力的来源。
vLLM v0.28.0:内核提速3倍是真的,但别当成整机提速来用
vLLM v0.28.0合并584次提交,把Kimi-K3、DeepSeek V4的专属优化做成官方内置能力,E/P/D解耦、分层KV缓存这类服务化功能也一次性铺进主库。三个官方性能数字都挂着具体模型、模式和配置前提,不能直接套用到所有部署。bitsandbytes迁出主库、Transformers强制升级,平台团队升级前要先过一遍依赖清单。
腾讯开源混元Hy4 preview:7700亿参数,内部评测险胜GLM-5.3、Kimi K3
腾讯开源混元Hy4 preview,7700亿总参数、490亿激活参数,上下文超100万token,接入CodeBuddy、元宝等产品线。腾讯内部203项工程任务盲测中,它以2.99分险胜GLM-5.3(2.92)和Kimi K3(2.94),但评测由腾讯自己组织,领先幅度小到接近误差范围。开发者可用两周免费期先测真实任务,企业采购者更该等开源许可证和权重细节公开再算总成本。
Debian投票揭开真相:开源"禁AI"没那么整齐
Debian的AI投票最终结果是"负责任使用"而非外界预期的全面禁令,常被引用的"37/120项目禁AI"这个数字也经不起方法论细究。开源社区真正在做的,是分头试验谁该为AI生成代码的验证成本买单,而不是集体倒戈反AI。
Warp的智能体会自己改自己,但Claude官方故事只讲了一半
Warp用两层Skill架构让代码审查智能体从人类反馈里自动学习,被Anthropic写成官方标杆案例。但Warp自己过去三个月连发三篇技术博客显示,这套东西是边打边补出来的,最新版本已经比官方讲的复杂得多。