人工智能资讯 第113页
聚合当前分类下的最新内容,按时间顺序查看第 113 页精选文章。
隐私牌AI独角兽:Venice AI融资6500万美元,估值10亿美元
Venice AI两年做到10亿估值,自称年化收入超7000万美元且已盈利,靠的是主流AI收紧审核时反向主打'隐私+少审查'。但用户量、收入、盈利全靠公司自报,'端到端加密'也只对付费订阅用户开放。想接入它的企业和开发者,得先搞清楚哪些是卖点,哪些是限制。
YC新公司Parsewise卖的不是文档解析,是企业敢不敢用AI的胆子
YC P25公司Parsewise在Hacker News发帖,把PDF、Excel、通话记录转成带词级引用的结构化数据,卖点是每个字段都能追溯来源。它真正解决的不是抽取精度,而是企业让AI经手关键数据时最缺的责任链。SOTA、跑赢Claude Fable这些说法目前只是自述,还没有第三方基准复现。
Manufact 招 DevRel:MCP 创业公司开始抢开发者入口
YC S25 公司 Manufact 正在招 Developer Advocate & Partnerships,薪资 10万-16万美元,股权 0.10%-0.70%。这不是一个单纯写内容、跑大会的 DevRel 岗位,而是把 demo、集成、合作和开发者反馈揉在一起的前线增长岗。真正值得看的是:MCP 公司已经开始从发 SDK,转向抢开发者工作流和工具调用入口。
谷歌新智能音箱硬件过关,但 Gemini 还撑不起“第二阶段”
The Verge 评测谷歌六年来首款新智能音箱 Google Home Speaker,给出 6 分:音质、外观和智能家居控制表现不错,但 Gemini for Home 慢且不稳定。真正的问题不在 99.99 美元的音箱本体,而在 AI 助手还没成熟到足以重新定义智能音箱。
Godot 拒收 AI 生成代码:开源项目开始追问谁来背锅
Godot 宣布不再接受 AI-authored code contributions,理由不是全面反 AI,也不是把问题定性为版权争议,而是维护者无法信任重度 AI 使用者真正理解并能修复自己提交的代码。 这条规则真正指向的是责任:开源贡献不只看能不能产出代码,还要看能不能解释、跟进 review、修回归。 对开源开发者和游戏开发团队来说,AI 编程工具还能用,但提交到公共工程里的代码,必须有人能说清、改得动、扛得住。
Vinton Cerf 从 Google 退休,AI 代理又撞上协议老问题
83 岁的 Vinton Cerf 将于下周卸任 Google 副总裁兼首席互联网布道师,结束自 2005 年以来在 Google 的任职。他与 Robert Kahn 共同奠定 TCP/IP,代表的是开放协议塑造互联网的那一代人。AI agents 正把行业重新推回一个老问题:谁定义协作标准,谁就更接近下一层入口。
Anthropic称Claude Fable 5和Mythos 5出口管制解除,访问将从次日恢复
Anthropic在Twitter/X称,已收到美国商务部通知,Claude Fable 5和Mythos 5的出口管制已解除,将从次日开始恢复访问。真正的影响落在可用性:此前受限的开发者和企业用户,可能重新评估接入、测试和采购安排。边界也要说清:这不是所有Claude模型解禁,也不能直接推成美国AI出口政策转向。
OpenClaw 登陆 iOS 和 Android:Agent 上手机,真正考的是可靠性
OpenClaw 已推出 iOS 和 Android 应用,手机端需配对 OpenClaw Gateway,用来调用用户自己的 agents、工具和技能。重点不在多了一个移动入口,而在 Agent 开始靠近手机权限:开发者可以试,普通用户不必急。接下来最该看三件事:执行是否稳定、权限边界是否清楚、失败后有没有兜底。
前 DeepMind 三人组把扑克 AI 用到量化交易,EquiLibre 估值已超 5 亿美元
EquiLibre Technologies 完成未披露金额 A 轮融资,Creandum 领投,估值超过 5 亿美元。 这家公司最值得看的是:强化学习能不能从扑克桌迁移到真实市场,并持续赚钱。 对 AI 投资人和量化团队来说,现在该看的不是估值故事,而是业绩口径、规模衰减和合作分成。
NotebookLM 把研究资料剪成 60 秒短视频:Google 做对了入口,也埋下了浅化的坑
Google 正在向 AI Ultra 和 Pro 订阅用户推出 NotebookLM 的 Short Video Overviews,可把用户上传资料生成 60 秒竖屏 AI 视频,含 AI 图像和旁白。它不是 TikTok 或 YouTube Shorts 发布功能,而是把研究资料变成更容易消费的摘要媒介。效率是真的,风险也清楚:用户可能更快入门,也更容易把摘要误当理解。
ScarfBench 给 AI 编码代理划线:企业 Java 迁移不能只看能否编译
IBM Research 发布 ScarfBench,专门评测 AI 编码代理做企业 Java 框架迁移,覆盖 Spring、Jakarta EE、Quarkus。它的关键信号很冷:当前最强代理的行为成功率低于 10%,构建成功会明显高估迁移质量。对企业现代化团队来说,AI 可以做迁移草稿,但不能替代测试、部署验证和架构师复核。
Acti 把 AI 智能体塞进输入法,真正难的不是打字
Acti 已上线 iOS 和 Android AI 键盘,把 Gemini 驱动的智能体能力放进输入法,主打跨 App 调用和自然语言创建 Skills。看点不在“键盘加 AI”,而在输入法能不能成为智能体入口。成败要看三件事:系统权限、隐私信任、用户是否愿意为省下的动作付费。
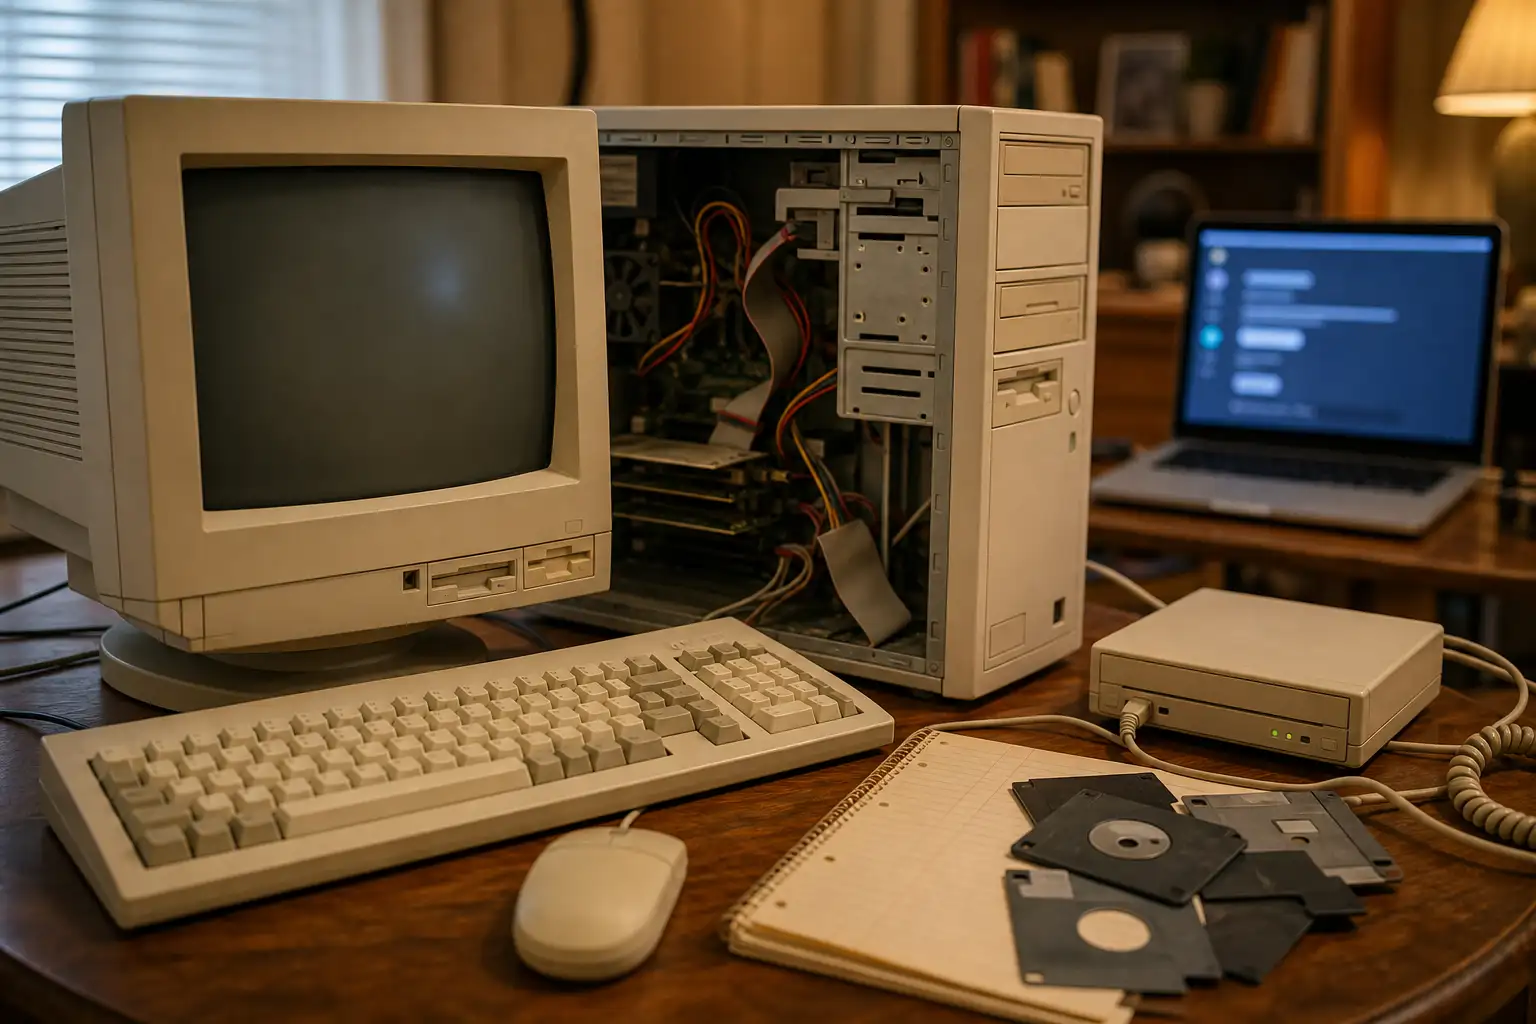
AI 助手越顺手,我们越不认识机器
unix.foo 这篇文章把 1990 年代配置电脑玩游戏的麻烦,和今天 AI 助手的顺从放在一起看。它真正讨论的不是技术知识消失,而是人通过失败、排错、反复尝试建立的亲历式熟悉感正在变少。对开发者和技术教育者来说,关键动作不是拒绝 AI,而是保留日志、复核、测试和手动排错这些“不顺手”的训练。
Claude Sonnet 5 上线:Anthropic 把更强智能体能力放进中档价格
Anthropic 发布 Claude Sonnet 5,并把它设为 Claude Free 和 Pro 的默认模型,同时开放 Claude Code 与 API。它不是用来全面取代 Opus 4.8,而是用更低价格补上 Sonnet 与 Opus 之间的智能体能力空档。开发者和企业团队该重点看三件事:长流程任务成功率、真实 token 成本、安全拦截边界。
OpenAI的GeneBench-Pro:基因测试题真正难在脏数据
OpenAI公开了GeneBench-Pro的10个案例题,材料包括原始prompt、数据集和支撑材料,但没有公布模型成绩、排名或通过率。它的重点不是证明AI能做临床决策,而是把模型推到基因组学里最麻烦的地带:混杂因素、伪影、校准和不确定性。对AI生物医药团队和计算生物学研究者来说,接下来要看的不是模型会不会说术语,而是能不能少犯危险的确定性错误。
OpenAI GeneBench-Pro:31.5%之后,AI科研卡在判断力
OpenAI 发布 GeneBench-Pro,用 129 个合成但贴近真实的计算生物学任务,测试 AI 在基因组学、生物学和科研分析中的高阶判断。GPT-5.6 Sol Pro 最高通过率为 31.5%,比 GPT-5 起初低于 5%进步很快,但仍不到三分之一。真正的变化不是 AI 会不会跑流程,而是它开始被拿来考“能不能做研究判断”。
The AI Compass:AI 圈有了政治罗盘,但别把标签当能力
Simon Willison 推荐了 The AI Compass:一个由 bambamramfan 制作的 AI 立场测试,29 道题后把用户归入 30 种原型之一。它好玩,但不是严肃量表;真正有意思的是,它把 AI 圈的分裂压成了两条轴:GOOD/BAD 与 OVERHYPED/TRANSFORMATIVE。我的判断很简单:标签可以帮人看清分歧,但不能替代把模型接进真实工作流的能力。
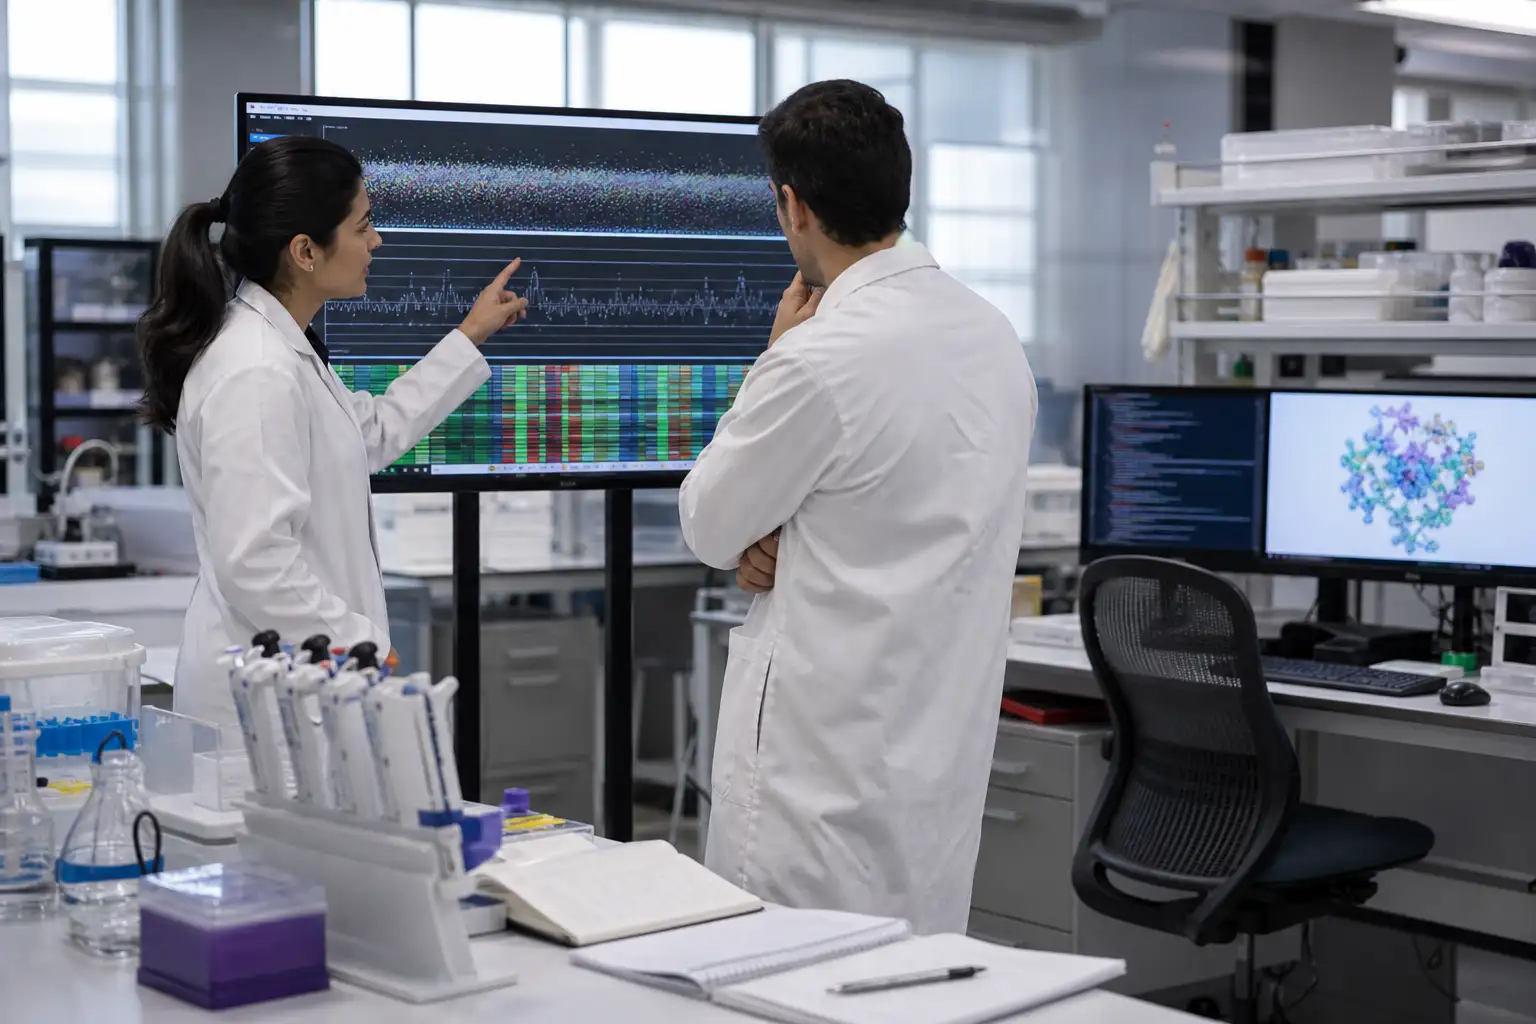
Claude Science 公测:它不是新模型,而是 Anthropic 想塞进实验室的 AI 工作台
Claude Science 是 public beta app,不是新的 Claude 模型;它使用用户计划内已有模型,面向 macOS 和 Linux,开放给 Pro、Max、Team、Enterprise 用户。真正的变化在工具层:连接科学数据库、Python/R、HPC/SSH、Modal 和结果溯源。对生命科学团队来说,它更像一个待验证的科研工作台,而不是能替代专业工具和专家判断的万能助手。
Netflix《Wonka’s The Golden Ticket》用 AI 复刻 Gene Wilder 声音:授权之后,边界才开始
Netflix 真人竞赛节目《Wonka’s The Golden Ticket》将于 9 月 23 日首播,9 月 30 日播出两集结局;预告片旁白使用 ElevenLabs 生成的 Gene Wilder AI 声音,Netflix 称已获其家属同意。 这件事的关键不只是声音像不像,而是经典 IP 真人秀化和逝者声音复刻被放进同一个商业包装。 授权能解决一部分法律问题,但观众是否接受、平台是否充分披露、合同如何限制二次使用,才是更难的部分。
Google 推出 Nano Banana 2 Lite:图像模型竞争开始拼速度和成本
Google DeepMind 发布 Nano Banana 2 Lite,称其为最快、最高效的 Gemini Image 模型,入口已开放到 Google AI Studio,模型参数为 gemini-3.1-flash-lite-image。它的核心价值更像是降低图像生成与编辑的等待时间和调用成本,而不是宣称图像质量全面领先。对开发者和内容团队来说,这类 Lite 模型的意义在于让批量试稿、A/B 素材和快速编辑更容易进入日常流程。
OpenAI 修掉的不是模型问题,是 AI 基础设施的隐蔽裂缝
OpenAI 工程师批量分析 Rockset 过去一年的生产 core dump,把一组诡异 C++ 崩溃拆成两类根因:一台 Azure 物理宿主机的静默硬件错误,以及 GNU libunwind 中潜伏 18 年的竞态 bug。 这事的重点不在模型能力,而在可靠性方法:大规模 AI 产品已经不能只靠工程师盯单个 core dump 破案,必须把崩溃样本做成可查询、可归因的数据资产。 对 SRE、后端和基础架构团队来说,真正该补的不是口号里的“稳定性”,而是 crash 数据留存、标签体系、硬件相关性分析和开源依赖边界。