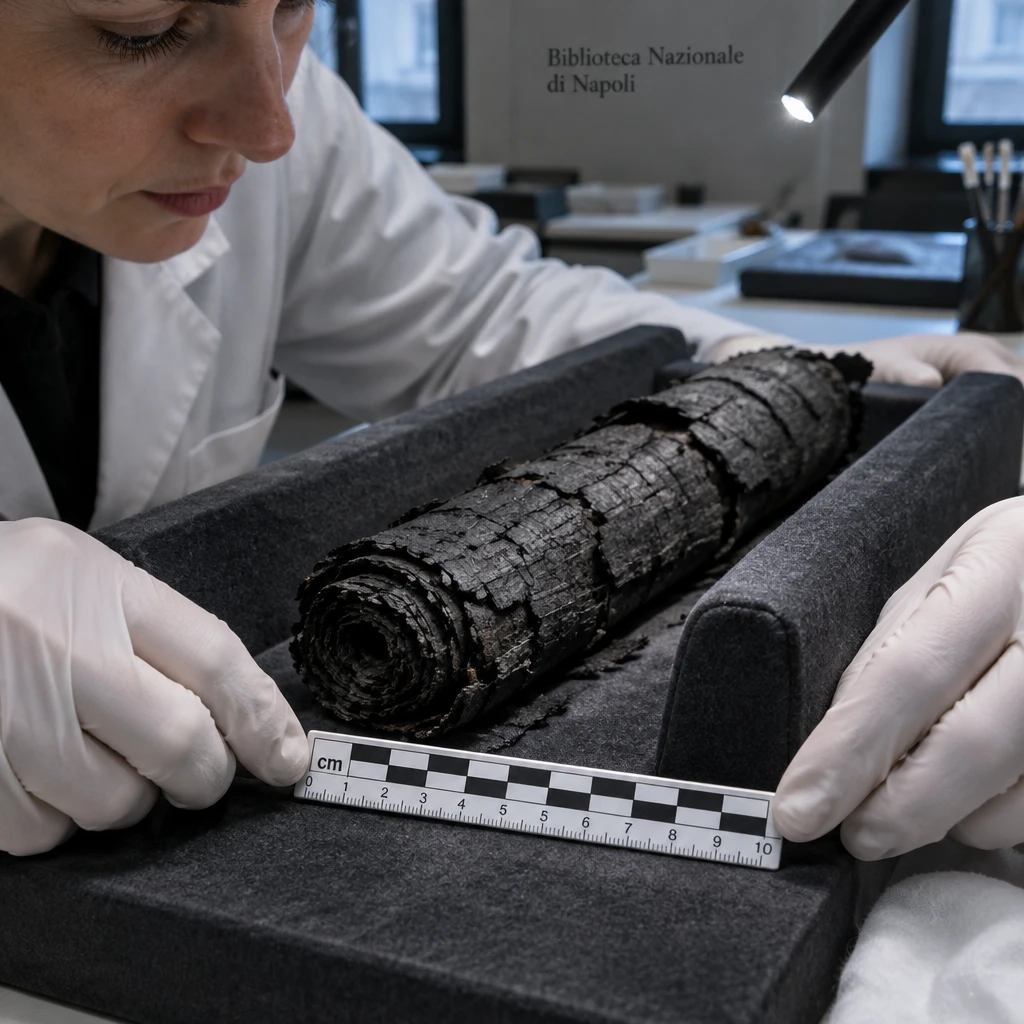
两千年前被维苏威火山灰烤成焦炭的纸莎草卷 PHerc. 306B,在 2026 年 11 月 2 日终于被人读出了第一行字。Vesuvius Challenge 官方当天由 Paul Henderson 与 Federica Nicolardi 联合署名宣布,向英国软件工程师 Liam Warner 与澳大利亚古典学硕士生 Nicola Bodill 颁发 5 万美元首字母奖。这笔奖金最反常的地方,在于多达 25 份社区提交围攻同一块 4 平方厘米区域整整一个月,前 8 个希腊字母早就被认出来了,评委却一直扣着奖金不发,直到获奖团队抠出了决定生死的一道斜笔。
先把这次破译的账面信息摊开:
- 破局对象.公元 79 年掩埋、18 世纪 50 年代出土的碳化残卷 PHerc. 306B,现藏那不勒斯国家图书馆,距原出土点赫库兰尼姆纸莎草别墅约 10 公里,其微焦点 CT 数据于 2025 年在法国格勒诺布尔欧洲同步辐射光源(ESRF)采集。
- 意外收获.靠新识别出的墨迹与书写方向,学界首次确认断成两截的 PHerc. 306 中,306B 是上半卷,较小的 306A 是下半卷,306A 瞬间成了高优先级扫描对象。
- 暂拟文本.目前合理释读指向希腊语短语 τὸ δι᾽ αὑτὸ αἱρ̣ε̣τ̣όν̣(意为本身即值得欲求之物),在亚里士多德、塞克斯都·恩披里柯及菲洛德穆《论愤怒》中都有平行用例,但后续字母仍带不确定点号,还定不了全卷归属。
一道斜笔卡住 25 份提交,AI 怎么自证没撒谎
首字母奖的硬门槛是在 4 平方厘米内读出至少 10 个字符。过去近一个月里,包括官方专门致谢的 8 支惜败队伍在内,好几拨人都在同一位置认出了 7、8 甚至 9 个字符。其中序列 τοδιαυτο(8 个字母)早成了明牌,偏偏紧跟其后的墨迹糊成一团。
古希腊抄本采用无词距、无标点的连写大写体。在这种字体里,字母 Μ、Ν 和双字母组合 ΑΙ 长得极像,连古人抄书时都经常抄错。纸莎草学家看着前 8 个字母,顺着古希腊伦理学常见套语往下猜,心里大概率知道后面该接什么词;但竞赛规则死死卡住两条红线,既防模型生成虚假字母图案,也防模型背诵训练集标注。我非常买账评审团这种近乎死板的克制。当大模型越来越擅长顺着上下文补全残缺信息时,人文考据最怕的就是把概率脑补当成历史铁证。清代朴学讲求无征不信,孤证不立,放在 AI 读古卷上更是保命底线。
Warner 和 Bodill 赢在没用单一大模型硬算。他们先用螺旋拟合工具在卷层里找准种子点,在官方 m7 曲面预测上用 VC3D 的 GrowPatch 工具精细剥出局部曲面;接着拿公开模型 TRACE v3B 与自己微调的 A-hn 模型,把两者的墨迹预测输出直接相乘。A-hn 训练时还专门给把空白纸莎草误判为墨迹的行为加了额外惩罚。只有两个底子不同的神经网络同时指认有墨,像素才会亮起来。这一乘,筛掉了单模型噪点,把第二个 α 左斜笔底部向上挑起的那道中间斜笔清清楚楚显影出来,与前一个 α 笔法严丝合缝。专家组这才一致拍板认下 αι。算术上 8 加 2 刚好凑够 10 个字母,但官方并未公布逐字计分表,真正一锤定音的就是这道物理笔画。
展开不等于读懂,7.91 微米正撞上物理墙
媒体一写这事,总爱渲染成 AI 已经能流水线通读古罗马图书馆了。我不太买账这种乐观。把 PHerc. 306B 和另一卷明星样本 PHerc. 172(项目内称 Scroll 5)摆在一起对比,工程瓶颈立刻就露出来了。
古罗马碳黑墨水与烧焦的纸莎草基底,对 X 射线的吸收率几乎一样,肉眼看 CT 切片往往一片漆黑。PHerc. 172 条件算极好的:它在英国钻石光源以 7.91 μm 体素分辨率、53 keV 入射能量分两段扫描合并,哪怕不经过机器学习增强,原始 CT 曲面上都能直接瞅见部分字迹。即便拿着这种好牌,团队在 2026 年 1 月 13 日的交底依然很骨感:PHerc. 172 下半部虽然虚拟展开了约 70% 的含墨区域(不含空白页边),但上半部约 30% 因为挤压扭曲太狠,连曲面都没法可靠追踪;而展开的内圈卷层里,大多只能看出模糊行距和零星字母。
曲面展得平只是体力活,墨迹认得真才是鬼门关。
三维曲面恢复与墨迹信号恢复,根本是两道独立的关口。大面积展平纸莎草层,绝不等于同等比例的文字可读。PHerc. 172 的卡壳说明,现有的 7.9 μm 级别数据集正逼近当前模型与渲染管线的实用极限。官方嘴上说把可靠检测推广到相对经济实用的 8–9 μm 扫描就能解锁整座馆藏,身体却很诚实:内圈粘连和顶部几何畸变,光靠软件调参已经很难硬抠,未来同步辐射光源能不能给到更高分辨率或更优相衬成像机时,才是决定破译上限的硬约束。
悬赏赛的算力扎堆,与 80 万美元的真硬仗
我更在意的是这次评奖暴露出的激励副作用。25 份提交、至少 9 支有名有姓的团队,近一个月里全挤在同一块 4 平方厘米的指甲盖大小区域死磕同一个词。
这很像 19 世纪淘金热里的浅滩淘金,只不过当年的淘金客赌的是体力,今天的开源极客拼的是闲置 RTX 4090 显卡和公共模型库。大家共享 VC3D、m7 曲面和前人训练好的模型权重,接力迭代的效率确实惊人;但『天下熙熙,皆为利来』,5 万美元的局部悬赏天然会诱导全球算力向局部最优解扎堆。谁都想找全卷最平整、信号最强的一小片抢先撞线,没人愿意白费功夫去啃顶部那 30% 拧成麻花的几何畸变。
- 风险.局部精细修补加双模型相乘虽能拿下单点首字母奖,却没法低成本平移到全卷自动化追踪,众包社区存在算力重复内耗的隐患。
目前项目里还有 20 卷已扫描古卷等着人去拿首字母奖,社区在另外 13 卷上的尝试还没达标;而真正的大头是 80 万美元大奖——要求在极少人工干预下,虚拟展开并读出一整卷 70% 的文本。接下来值得盯紧两件事:一是刚摸清方位的下半卷 PHerc. 306A 何时排上微焦点 CT 扫描,和上半卷 306B 拼回同一篇古籍;二是社区能不能从抠那一道 α 斜笔的精细手艺里跳出来,拿出能跨过全卷褶皱的自动化曲面算法。毕竟,在 4 平方厘米灰烬里认出十个字母是奇迹,把两千年前的整本书真正端上桌,才算把技术账结清。