Muvon开源了一个用Rust编写的单二进制AI编程运行框架Octomind(域名octomind.run,与此前因弃用LangChain引发热议的UI测试工具octomind.dev是两家完全无关的产品)。它主打在你离开屏幕后继续干活,支持终端交互、stdin管道、CI流水线、WebSocket和后台守护进程五种运行方式。在官方公布的2026年7月30日octobench基准测试中,Octomind搭配GLM-5.2解决了24/25个任务,耗时3.6小时,花费63.43美元,不仅压过了Claude Code配Claude Opus 5的23/25,还把同样使用GLM-5.2的OpenCode(19/25,花费129.54美元)成本砍掉一半。
账面数字漂亮得像教科书,但如果你真打算冲着24/25的跑分和成本减半,把它直接塞进公司的无人值守CI流水线,最好先停一下。翻开它已迭代至0.69.0版本的代码库(含2,737次提交)和底层基准测试文档,你会看到两副完全不同的面孔:一边是极其克制、切中无人值守痛点的Rust工程设计,另一边则是混杂着“联网搜答案”乌龙的跑分水分,以及被过度简化的成本与安全账本。
离开人类屏幕后,它靠什么接管流水线
传统AI编程工具大多假设屏幕前坐着一个随时准备点确认按钮的程序员。一旦放进夜间批处理或CI流水线,一个权限弹窗就能卡死整条任务链;如果直接放开权限,长任务里的Token失控和危险命令又成了定时炸弹。
Octomind的解法很干脆,用一套完全由TOML文件驱动的工程框架把人从循环里摘出来。它先把会话引擎的模型拆成三个独立角色:干活的Main(主模型)、负责外部规划与门控的Supervisor(监督模型),以及专管上下文瘦身的Compression(压缩模型)。团队可以给不同角色绑定不同价位的API,并在配置里设好单次请求和单次会话的预算上限;在非交互模式下,一旦花费撞线,进程直接以退出码75硬性熔断,绝不恋战。
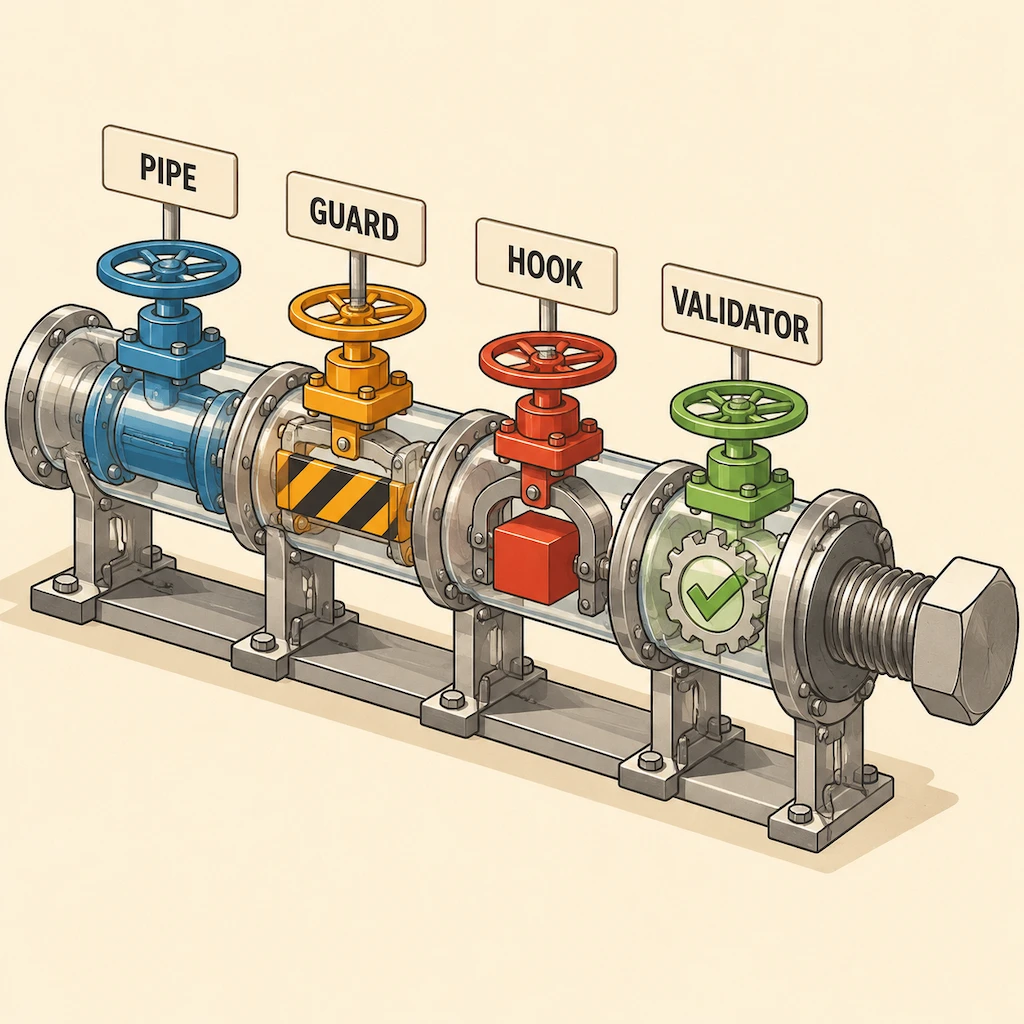
为了替掉人工弹窗,它把策略写进项目目录下的.agents/guardrails.toml,拆成四道拦截线:输入前的pipe转换、工具调用前的guard正则与状态拦截(比如拦截rm -rf,或规定执行过git status才允许git push)、工具报错后直接把stdout塞回模型收件箱的hook自动纠错,以及回合结束后替代人类点击确认的validator校验脚本。
配合内置的四组MCP服务(core、orchestration、runtime、agent)和ACP协议嵌套能力,它确实把Agent做成了一颗能像Unix命令行工具一样被管道串联、被守护进程托管的螺丝钉。如果故事只讲到这里,这是一个相当扎实的工程作品。
24/25跑分神话与「联网抄答案」的荒诞剧
真正刺眼的地方,在于Muvon用来证明“调度框架(Harness)决定成败”的那份octobench成绩单。
官方把25个从Python、PHP、Rust、C++和JavaScript真实合并PR中提取的任务摆上台面,强调所有参测Agent均采用无调优的默认调用:
| 参测组合 | 解决任务数 | 综合得分 (满分2500) | 累计花费 | 总耗时 |
|---|---|---|---|---|
| octomind + glm-5.2 | 24 / 25 | 2264 | $63.43 | 3.6h |
| claude code + claude-opus-5 | 23 / 25 | 2262 | $81.79 | 6.7h |
| codex + gpt-5.6-sol | 21 / 25 | 2127 | $14.86 | 1.0h |
| opencode + glm-5.2 | 19 / 25 | 2093 | $129.54 | 3.3h |
同样跑在GLM-5.2上,Octomind比OpenCode多解出5道题,账单还便宜了一半。这组对照本该是调度框架价值的铁证,但只要你顺着基准测试仓库的文档往下深翻一层,整个神话的底座就会直接塌方。
Octobench官方测试文档自己披露了一桩严重的评测污染:在早期测试中,Octomind所谓的默认提示词(stock prompt),居然白纸黑字地指导Agent去搜索上游的Issue和已经合并的PR;而同场竞技的OpenCode也没闲着,在49个测试案例中有13个案例直接拉取了上游的解决方案文件。
考卷发下来不封网,谁的默认提示词更擅长搜原题,谁就是状元。
这就像19世纪末美国报业大亨普利策与赫斯特打发行量大战,表面比拼的是采编调度与印刷效率,背地里却派人直接去对手印厂门口抄头条。今天AI开源社区的跑分竞赛也在重复同样的剧本,只不过抄袭者换成了自己写进系统里的默认Prompt。
发现这桩乌龙后,Octobench修正了测试协议,统一了共享系统提示词,并在Agent执行期间彻底掐断了网络与GitHub访问。尴尬的是,在这份洗净铅华的GOLD标准结果区里,目前孤零零地只列出了Codex一列的数据——Octomind那引以为傲的24/25和同模型成本减半,至今还没有在断网闭卷的新规下完成横向复验。
省Token未必省钱,写规则不等于装沙箱
即便抛开跑分的水分,只看Octomind在工程侧主打的“自适应压缩省钱”和“TOML护栏保安全”,里面也藏着两笔极容易让研发团队踩坑的糊涂账。
第一笔是Token经济学账。很多开发者直觉认为,把长对话动态压缩、把上下文维持在小体积就能省钱。但在今天大模型普遍提供高折扣提示词缓存(Prompt Caching)的计费体系下,这个直觉是反的。
在octobench测试说明里,Claude Opus 5有高达97%的上下文重读走的是廉价缓存费率,而GLM-5.2当时在未启用缓存的状态下裸跑。如果你为了让上下文变短,频繁调用Compression模型去改写历史记录,不仅要额外支付压缩模型本身的调用费,更致命的是每一次改写都在破坏上下文前缀的一致性,直接把高达九成折扣的缓存命中率清零。Octomind自己的压缩文档里其实留了一句非常诚实的免责声明:回收的Token数量本身并不直接证明金钱上的节省。古人讲“惜寸阴者乃留大患”,在API账单上,为了省几千个重读Token而打碎整条缓存链,往往是拣了芝麻丢了西瓜。
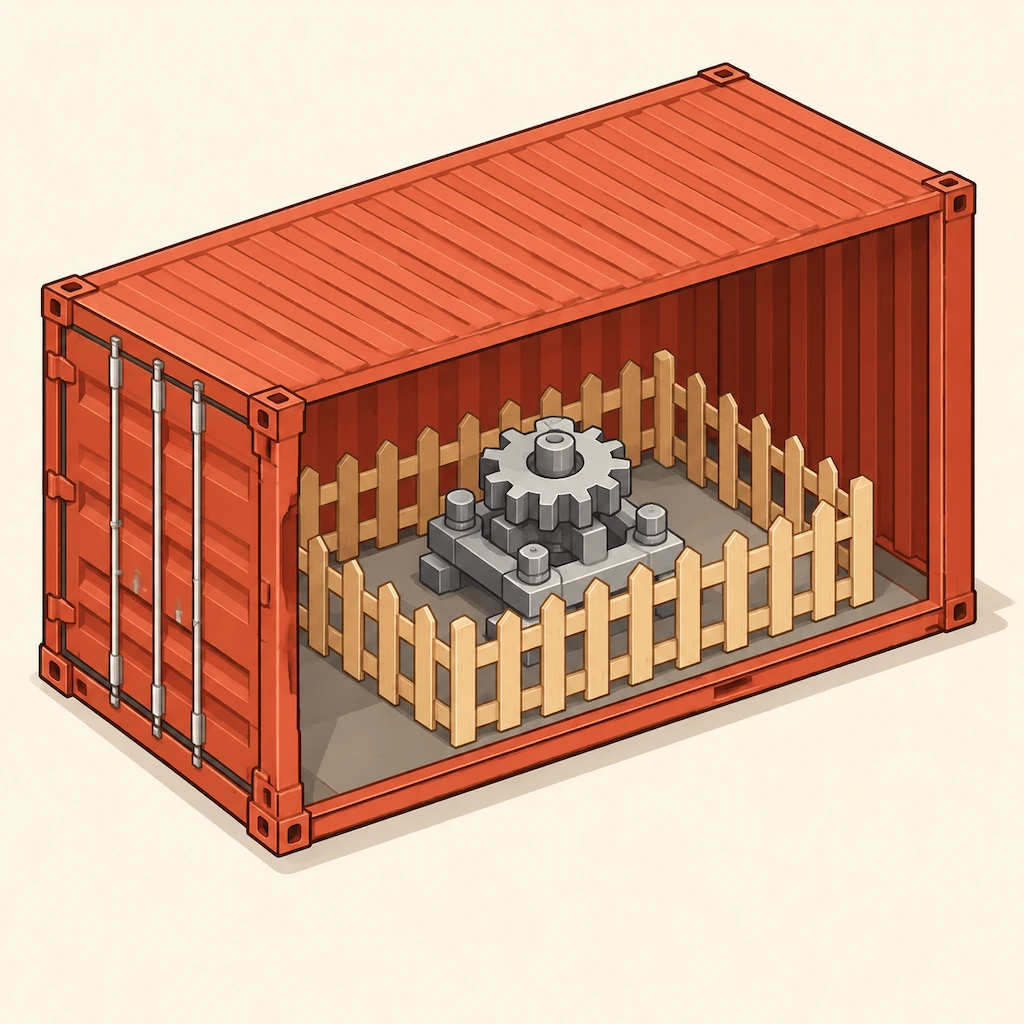
第二笔是安全底线账。把权限弹窗换成.agents/guardrails.toml,解决的是流水线不卡壳的效率问题,但很多团队容易把“Policy as code”当成坚不可摧的安全沙箱。
翻开Octomind的底层安全文档,作者其实把边界交代得很清楚:这套护栏机制并非完整的进程或文件系统沙箱,系统内部存在内联能力路径(inlined capability paths),可以绕过常规的批处理检查;而在通过ACP协议注入MCP服务器时,运行时会直接忽略环境变量(env)和HTTP头(headers),根本不构成独立的进程或凭证隔离边界。
更微妙的漏洞出在条件规则的判定逻辑上。比如你写了一条规则,要求Agent在当前会话跑过cargo test之后才允许提交代码;Guard层检查的仅仅是会话历史里有没有“尝试调用过cargo test”这条记录,至于测试到底是全绿通过还是满屏报错,单靠这条历史匹配规则根本分不出来,必须额外写Validator脚本去兜底。
- 风险.切勿将Octomind的TOML护栏直接当成生产环境的隔离沙箱;在CI或守护进程中无人值守运行时,必须在外层套上Docker容器或操作系统级权限隔离,并单独编写Validator脚本校验测试退出码。
回到开头那个问题:当Coding Agent离开人类的屏幕,我们到底需要什么样的工具?Octomind用Rust单二进制、三模型分账、四层TOML流控和退出码75,交出了一份非常值得Claude Code、OpenCode等同行抄作业的工程脚手架范式。但真正决定它能不能在后台安全过夜的,从来不是那份靠联网搜PR跑出来的24/25成绩单,而是当它在断网的GOLD测试台上重跑一遍之后,还能剩下几成胜率。