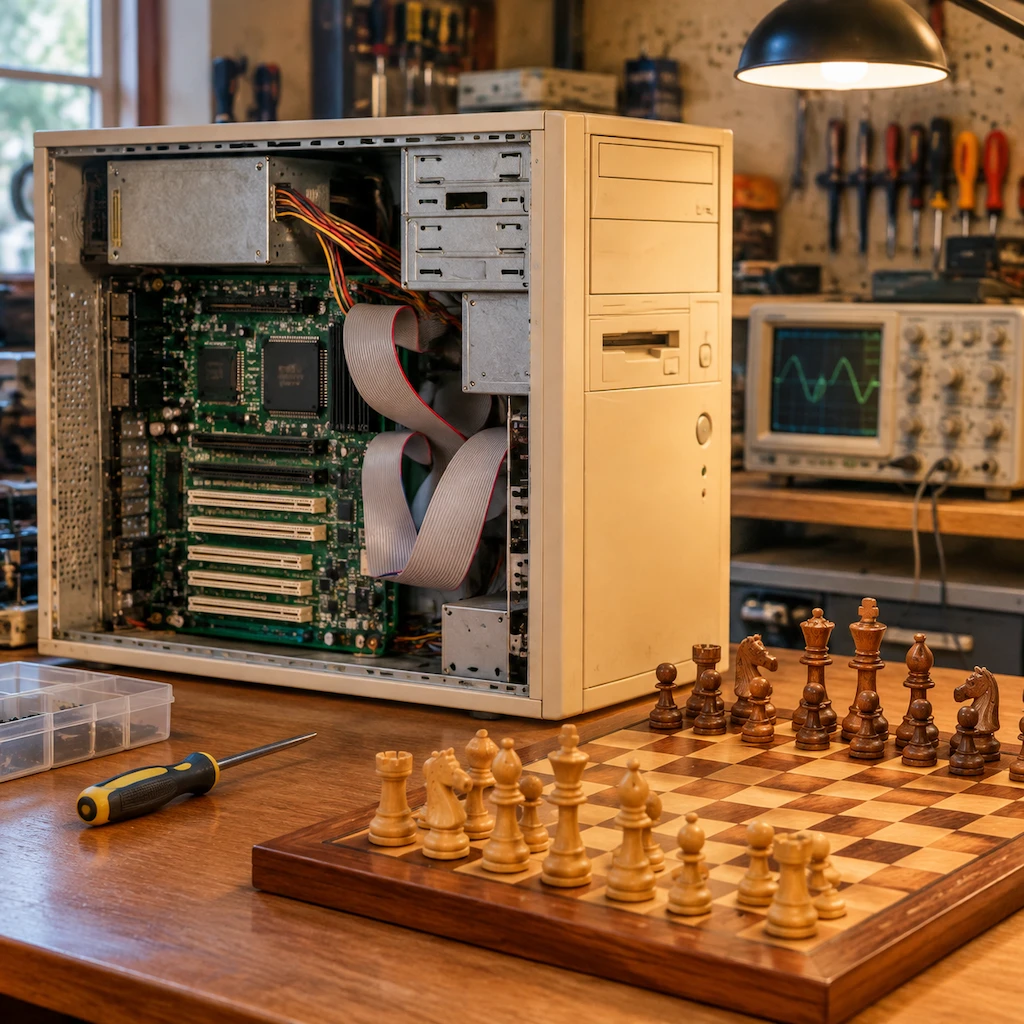
一台发布于 1995 年 11 月 1 日的 Intel Pentium Pro 台式机,主频 200 MHz,内存只有 64MB,插着一张 Realtek RTL8139C 网卡,系统从 1.44MB 软盘启动。安全与 AI 研究者 Nicholas Carlini 把现代开源象棋引擎 Stockfish 17 塞进了这台三十年前的机器,慢棋预估等级分飙到 3300±87 Elo,远超 1996 年人类棋王卡斯帕罗夫不到 2800 分的水平。这项实验看似证明当年根本不需要造超级计算机,实则掩盖了一个更冷酷的行业现实,即端侧极致的软件效率,本质上是用现代庞大的训练算力蒸馏出来的。
Carlini 在这台老机器上跑了两组对照实验,专门拆解过去三十年象棋 AI 的战力究竟来自摩尔定律还是代码改进:
- 老软件跨代跑.取 1996 年 12 月发布的顶尖引擎 Crafty 11.13,在 Pentium Pro 上按每步 1 秒下棋,等级分为 1999±90(每步 10 秒为 2383±77);原封不动挪到现代 Ryzen 7 处理器上,每步 1 秒的分数直接涨到 2614±97,纯硬件升级贡献了 615 分。
- 老硬件换新脑.保持 Pentium Pro 硬件不变,借助 Fable 5.1、Opus 5.5 与 GPT-6 等大模型改写代码,把现代搜索算法(fail-soft、晚着法缩减 LMR、correction history、改进的静态搜索)和轻量级神经网络评估(NNUE)移植进老 Crafty,每步 1 秒分数飙升至 2718±34(每步 10 秒达 2974±74),纯软件进步贡献了 720 分。
- 跨时空百局死斗.把 Stockfish 17 针对 32 位架构和 64MB 内存重写调优,在 Pentium Pro 上跑出每步 1 秒 2846±35、10 秒 3109±79、30 秒 3180±80 的战绩;让这台跑着新算法的 1995 年老爷机,去打跑着 1996 年原版 Crafty 的现代 Ryzen 7,百局结果是 78 胜 17 和 5 负。
250 万美元超算的历史错位与算力减法
1995 年底那台 Pentium Pro 整机加四根 16MB SIMM 内存售价约四五千美元,到了 1997 年因为 400 美元的 Pentium MMX 上市,二手价已跌到一千美元左右。而当年 IBM 为了击败卡斯帕罗夫,走的是一条不计成本的专用硬件暴力路线。
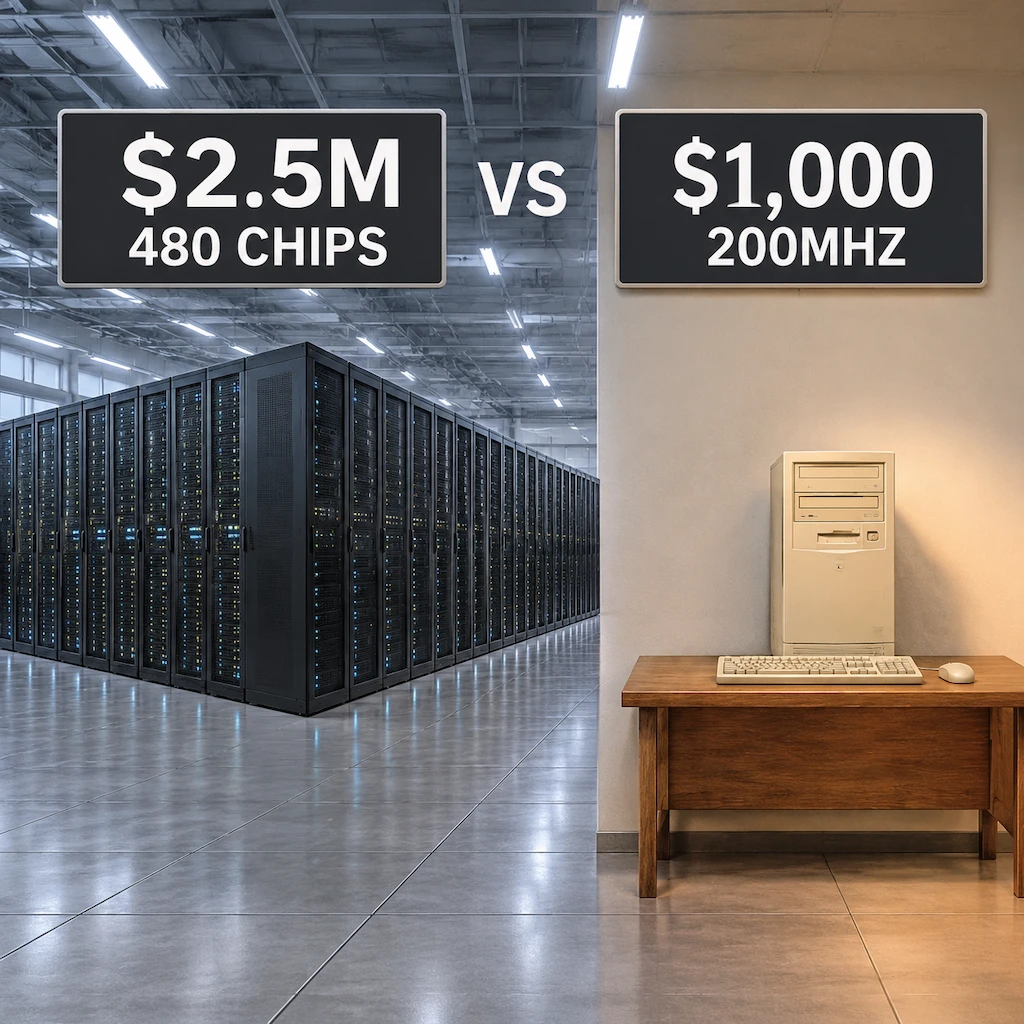
这里得先替 Carlini 修正一个史实错位。他在文中提到的 30 颗 120MHz P2SC 处理器、480 颗定制 VLSI 象棋协处理器和每秒 2 亿局面,其实是 1997 年 5 月以 3.5 比 2.5 赢下整场重赛的升级版深蓝。1996 年 2 月首次在单局中击败卡斯帕罗夫的初代深蓝,实际采用的是 36 节点 IBM RS/6000 SP 架构与 216 颗定制象棋芯片,每秒搜索速度在 5000 万到 1 亿局面之间。到了 1997 年版本,其 30 个节点由 28 颗 120 MHz 和 2 颗 135 MHz 的 P2SC 处理器组成,单节点配 1GB 内存和 4GB 磁盘并运行 AIX 4.2 系统;在超过 1 分钟的实战长考中,其实测平均速度为每秒 1.26 亿局面,2 亿只是理论峰值。即便如此,IBM 项目负责人 C. J. Tan 在 1996 年解说时就透露,单是深蓝底层那台 32 处理器的商用 SP2 主机售价就高达 250 万美元,定制芯片和研发开销还没算进去。
为什么一千美元的通用台式机换套代码,就能在账面上吊打 250 万美元的专用超算?答案藏在搜索范式的彻底反转里。
深蓝时代拼的是算得有多快,靠定制芯片把 Alpha-Beta 剪枝树往死里铺开。但过去三十年象棋 AI 干的核心工作,是让引擎学会少算废棋。通过引入晚着法缩减(LMR)和逆向空着剪枝,引擎在搜索树末端直接砍掉大量平庸分支;更关键的转折是引入了可在 CPU 上高效增量更新的神经网络评估(NNUE)。Stockfish 官方技术文档记录了一个极反直觉的事实,引入 NNUE 之后,现代 Stockfish 每秒搜索的节点数(NPS)实际上不到早期手工评估版本的一半。
算得更慢,却赢得更狠。因为单局面的直觉评估准度大幅提升,引擎不再需要靠每秒上亿次的暴力穷举去兜底战术盲区。
4000 个核心年的算力走私与统计盲区
如果故事只讲到这里,很容易得出一个让人热血沸腾的结论,即 1996 年的人类根本不需要造深蓝,几个天才程序员关起门改改算法,用普通办公电脑就能终结人类棋王。在 1335 分的总涨幅里,软件占了 720 分(54%),硬件只占 46%,算法红利似乎彻底压倒了硬件堆料。
我不太买账的是这种把部署成本当成研发成本的账面游戏。
端侧跑得动,绝不等于当年造得出;轻量化的权重里,封印着现代超算的尸骨。
仔细扒开 Carlini 改造 Crafty 的实验日志,就能抓到那头房间里的大象。当他把手工评估函数换成小型 NNUE 神经网络时,最初用引擎自对弈生成了 1100 万个局面,分数几乎没涨(每步 1 秒甚至微跌 32 分);直到他请出现代完整的 Stockfish 充当老师来重新标注训练数据,等级分才在每步 1 秒下暴涨 228 分。Carlini 自己在文中顺手算了一笔账,如果不用现代电脑,而是老老实实用 1996 年的硬件去跑完这套数据生成与训练流程,整整需要耗费 4000 个 1996 年的 CPU 核心年(core-years)。
四千个核心年是什么概念?在 1996 年,这就是一座不折不扣的超级计算机集群。所谓普通奔腾电脑打败卡斯帕罗夫,其实是一场跨越三十年的算力走私。实验把现代巨量算力烘焙出的高密度权重压缩成小网络,再塞回老芯片里做纯推理。当年如果不花几百万美元给 IBM 造深蓝,也得花同样级别的钱去建一座专门用来跑强化学习自对弈的训练机房。
除开训练算力的隐性透支,这组实验在方法论上还有两处硬伤不能轻轻放过:
- 软硬件耦合被强行拆成线性加减.Carlini 把硬件单独升级的 615 分与软件单独升级的 720 分直接相加,算出软件占 54%。这隐含了软硬件收益互不干扰的强假设。可在实验二里,Stockfish 17 刚砍掉多线程、端局库和 71MB 原始大网络、硬塞进 32 位奔腾 Pro 时,每步 1 秒只有 2496 分;随后针对老 CPU 调整累加器更新、换用 PeSTO 混合评估并把评估耗时砍掉三分之二,才一路涨到 2846 分。这 350 分的涨幅恰恰说明,脱离了底层硬件特性去谈纯算法红利根本站不住脚。
- 跨体系等级分直接换算胜率存疑.3300 分并非实测值,而是根据每步 1 秒到 10 秒、10 秒到 30 秒每延长三倍时间涨 70 分的规律,从 3180 分按慢棋每步约 6 分钟外推出来的。更严谨的限制在于,Stockfish 官方文档早已申明,引擎 Elo 高度依赖对手池、时限和开局库,拿引擎池校准的分数直接跟人类国际棋联(FIDE)的 2800 分做减法算胜率,在科学上并不成立。
- 提醒.不要把端侧推理的低门槛误判为技术研发的低门槛,任何试图在边缘设备上复现跨代智能的团队,首先得算清云端合成数据与蒸馏的算力总账。
历史回声与今天的大模型焦虑
汉代桓宽在《盐铁论》里写过一句老话,叫作明者因时而变,知者随事而制。回顾计算机象棋三十年,从深蓝靠 480 颗定制芯片堆出每秒上亿局面的暴力美学,到今天 Stockfish 砍掉一半搜索速度、靠微型神经网络在 200MHz 老古董上杀得片甲不留,技术演进从来不是单向的算力狂飙。
这件事跟上世纪航空工业的演进颇有几分神似,但不完全一样。早年飞机想飞得快,全靠把活塞发动机越造越大;后来空气动力学和涡扇结构成熟了,推重比才迎来质变。不同的地方在于,象棋 AI 的新算法并不是凭空想出来的数学公式,它高度依赖现代算力在后台反复试错、搜索和蒸馏。
把视线拉回今天的大模型战场,这台嗡嗡作响的 1995 年奔腾电脑其实给深陷算力焦虑的 AI 行业递了一面镜子。
现在的云端万卡集群,干的就是当年深蓝和那 4000 个核心年训练集群的苦活。先用极其笨重、昂贵的算力暴力蹚出能力边界,攒够高质量的合成数据(就像用现代 Stockfish 标注那 1100 万个棋局),接着通过模型蒸馏、激进剪枝和推理阶段的树搜索优化(Test-time compute),把高高在上的智能塞进手机、汽车甚至几十兆内存的边缘芯片里。
接下来最值得盯紧的行业变量,不是哪家巨头又买了几万张显卡去堆参数,而是谁能率先在大模型领域复现象棋引擎的 NNUE 时刻。当每秒生成的 Token 数量不再是唯一指标,谁能用一半的搜索节点换取翻倍的决策质量,谁才真正拿到了下一代端侧 AI 的船票。