把同一个开源权重模型 GLM-5.3-flash 塞进三个不同的 Agent Harness(智能体控制框架),去跑 90 个跨应用 API 任务,任务通过率能从 30.0% 拉升到 81.1%。2026 年 11 月 3 日,IBM Research 的 13 名研究人员用这样一份对比报告,推介自家基于 Apache 2.0 协议开源的企业级框架 CUGA(ConfigUrable Generalist Agent)。
表面上看,这是一场工程框架的胜利,证明企业不必盲目追逐昂贵的闭源旗舰大模型。但交叉核验 IBM 公开的代码仓库与竞品技术文档就会发现,这场悬殊胜利背后藏着非对称调优与测试集不透明的争议;而真正值得企业架构师抄作业的,反而是跑分之外那套专门用来剥夺模型自由度的代码级风控。
剥夺模型自由度,换来十倍的一致性差距
在社区维护的 awesome-agent-harness 等列表中,同类控制框架已经逼近 200 个。此前 best-of-Agent-Harnesses 引用的一份分析就曾展示过,同一个 GLM-5.2 模型在 SWE-bench Pro 上仅更换控制框架,得分就能从 23% 涨到 52%。
为了验证企业级业务场景的差异,IBM 团队把自家基于 LangGraph 构建的 CUGA、Nous Research 主打个人全天候助手的 Hermes,以及 LangChain 主打长周期研究任务的 Deep Agents 拉到了同一个考场。测试选用 Stony Brook NLP 推出的 AppWorld 基准,涵盖邮件、支付、文件存储等 9 个模拟应用和 457 个 API(IBM 在测试配置中实际接入了 469 个工具),通过检查底层系统的最终状态(包括是否产生意外的数据篡改)来判分。
在抽取的 30 个场景、90 个任务中,规定每个任务只有 1 次尝试机会。CUGA 的单任务通过率(TGC)拿到 81.1%(73/90),Hermes 为 46.7%(42/90),Deep Agents 为 30.0%(27/90)。如果看更严苛的场景通过率(SGC,要求同一场景下的 3 个变体任务全部通过才算得分),三者的差距直接拉大到了 十倍:CUGA 达到 66.7%(20/30),Hermes 为 26.7%(8/30),Deep Agents 跌至 6.7%(2/30)。
中小尺寸的开源模型在面对几百个 API 时,极易出现选错工具、漏看分页数据或写错参数的问题。CUGA 之所以能稳住场景一致性,核心手段就是用确定性的工程管线去接管模型决策。
在规划阶段,CUGA 会把复杂任务按单应用拆解,开启聚焦工具(Focused tools)机制——每一步只让模型看到当前应用所属的 API 和少量共享工具,而不是把 469 个工具一股脑全塞进上下文;缺工具时再通过 find_tools 动态检索。在执行与校验阶段,模型在沙盒中编写 Python 代码调用 API(CodeAct),任何修改数据的代码块在运行前必须经过一次静态审查;执行后除了自动反思,还专门设了一道分页审计(Pagination audit),只要发现列表查询返回了满页数据而模型没有请求下一页,框架就会直接报错拦截。
模型少做一次自由选择,业务系统就少踩一个幻觉大坑。
审计横评背面:不对称的配置与巧合的 90 个任务
如果一名企业 AI 架构师仅凭 81.1% 对 30.0% 的数字就决定替换底座,很可能会掉进厂商基准测试的经典陷阱。把实验配置表和 GitHub 代码库拆开来看,这场对照实验存在三处明显的科学性硬伤。
最直接的不公在于调优精力的倾斜。在测试中,CUGA 挂载了专门针对 AppWorld 编写的定制指令(AppWorld instructions),并全套开启了任务分解、执行前验证与自动反思;而 Hermes 仅仅使用了 Harbor 评估框架下的默认 MCP 设置;Deep Agents 也只配了 MCP 工具加常规中间件(工具选择、上下文摘要、待办列表、重试等),外加两个防止 GLM 格式错误中断运行的小修补。在缺乏消融实验的前提下,外界根本无法分清这 51.1 个百分点的领先,究竟有多少来自 CUGA 的架构优势,又有多少来自那份未向竞品共享的专属提示词配置。
| 核查维度 | IBM 报告呈现的口径 | 交叉核验代码库与文档的实况 |
|---|---|---|
| 实验对等性 | 固定 GLM-5.3-flash,对比框架与工作负载匹配度 | CUGA 用专属定制指令,竞品仅用默认或基础 MCP 配置 |
| 样本与复现 | 抽取 30 场景 90 任务,复现配置公开于 harbor-eval | 数量与 AppWorld 公开训练集完全吻合,仓库缺任务 ID 清单 |
| 工具集数量 | 接入 469 个工具完成测试 | 比 AppWorld 官方 457 个 API 多出 12 个未指明身份的工具 |
| 安全与私有化 | 强调 CUGA 独具策略强制执行与物理隔离部署 | 跑分全程关闭策略控制;Hermes 等竞品同样支持审批中断与私有端点 |
更微妙的疑点在于测试样本的选取。AppWorld 原始论文包含 750 个任务(其中训练集 105 个、开发集 60 个)。而在 IBM 旗下的另一个评估仓库(IBM/draco)中,AppWorld 公开的训练集(train split)恰好被记录为 30 个场景、90 个任务(另有 57 个开发集任务)。这一数字与本次 CUGA 横评的样本量完全重合。
尽管 IBM 在文中宣称将复现设置公开在了 cuga-project/harbor-eval 仓库,但实际检视该分支会发现,其根目录仅有一份通用的 Harbor 框架说明,并未直接提供本次实验锁定的任务 ID 清单、精确配置文件或比官方 457 个 API 多出来的那 12 个工具的具体定义。如果一套挂着专属定制指令的框架,恰好在公开的 90 个训练集任务上跑出了高分,这套配置面对未知企业业务时的泛化能力就要打上问号。
- 风险.切勿直接采信厂商不对称调优下的榜单跑分,企业选型自测必须锁定未公开的业务测试集,并强制拉平各框架的 Prompt 调优工时与 Token 消耗预算。
跑分没测的真战场:当 Agent 手握支付接口
IBM 在报告中坦承,这轮 90 个任务的跑分全程关闭了策略控制(Policy),因为基准测试并不考核合规拦截。但对于真正要把 Agent 接入 CRM、ERP 和支付系统的企业团队来说,跑分没测的这部分才是决定项目生死的底线。
目前绝大多数团队仍在把业务红线(例如付款需审批、禁止泄露客户隐私数据)写进系统提示词(System Prompt)。但提示词只是建议而非铁律,模型可能误读,用户可以通过多轮对话诱导绕过,中间步骤读取的外部网页或邮件也可能夹带提示词注入攻击。
CUGA 在其发表于 ACM CAIS 2026 的论文中提出了一套构建即治理(Governance by Construction)的策略层,将规则从提示词移到了运行时框架中,在五个节点设卡:
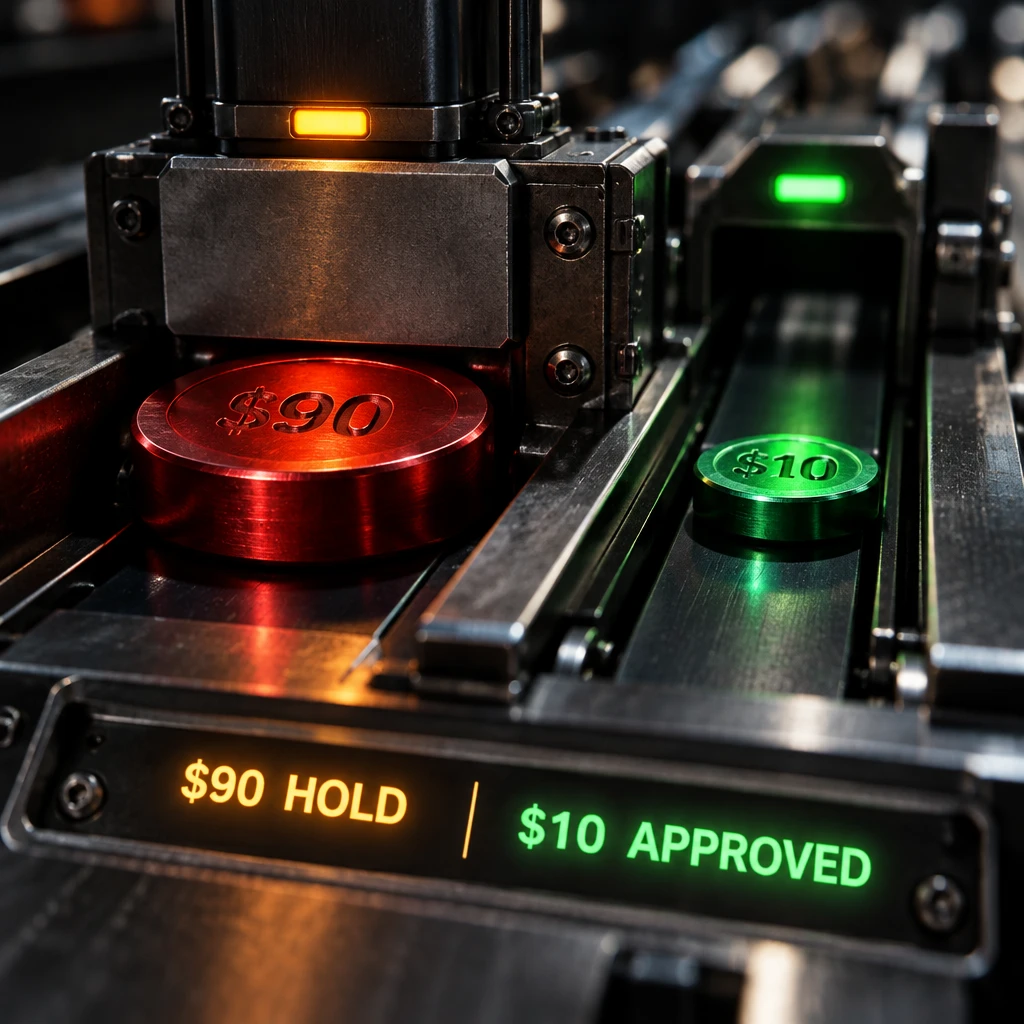
在 IBM 提供的在线策略演练场案例中,面对一句支付所有欠款的模糊指令,无策略保护的 Agent 把一笔已被拒付并进入催收环节的款项一并算入,直接划走了 90 美元;而挂载了策略层的 Agent 在工具调用前被代码级守卫(ToolGuard)拦下,挂起等待人工审批后,仅支付了真正到期的 10 美元。
不过,IBM 暗示只有 CUGA 才能满足企业边界与合规需求,同样带有明显的公关色彩。查阅 Hermes 和 Deep Agents 的官方技术文档可知,后两者绝非毫无防备地裸奔:Hermes 原生支持危险命令审批、文件写入限制、容器隔离与凭证过滤,也能直接对接企业内部自定义的模型端点;Deep Agents 同样提供特定工具的审批中断、工具参数的条件检查中间件,并支持将 SDK 托管在企业自有容器中。
真正的分野不在于有没有安全与私有化能力,而在于规则颗粒度与断网交付。Hermes 和 Deep Agents 的安全原语偏向通用的系统防破坏与人工审批中断;而 CUGA 的 ToolGuard 更进一步,允许企业将复杂的交易金额阈值、跨表状态核验写成确定性的前置校验代码,并围绕 Kubernetes、OIDC 身份认证以及 IBM Sovereign Core 做好了进驻物理隔离(air-gapped)主权云集群的工程封装。
对于正在接近 200 个框架中做选型的技术负责人来说,与其争论哪套框架在特定配置下跑分更高,不如把即将上线测试的框架拉进真实业务沙盒,直接考核两个硬指标:一旦开启全套 ToolGuard 级别的前置代码校验,模型的任务完成率会掉多少、端到端延迟会增加几秒;以及拔掉外网网线后,整套系统能不能在不依赖任何外部云端组件的前提下独立跑通。