开源社区最近出现了一个极其吸睛的标题:13 秒训练一个 Transformer。开发者 lostmsu 在 Hacker News 上发布了名为 TurboGPT 的项目,声称能在十几秒乃至一分钟内完成微型模型的完整训练。在行业习惯了以集群规模和月度耗时来衡量训练周期的今天,这种秒级反馈迅速挑动了开发者的神经。
然而翻开代码库,展现在眼前的并不是某种颠覆物理定律的算法奇迹,而是一次把模型规格压缩到极限的硬核工程实验。
跑分宣传与源码账本的断层
公众往往容易被几秒训完大模型的字眼吸引,但只要逆向推导其代码实现,落差立刻显现。
TurboGPT 在代码中给出的默认结构非常极端:4 层 Transformer、4 个注意力头、Embedding 维度仅为 16、FFN 维度 48,词表是基础的 256 字节。最关键的约束在于,它的上下文长度仅为 4。
依据这套结构核算,模型全量标量参数只有 21,648 个。在标准的 FP32 单精度浮点下,仅权重体积就约为 84.6 KiB,这与宣传标题中醒目的 22 KiB 明显脱节。那 22 KiB 大概率是早期极小测试分支或某种精简格式,而非当前代码的真实开销。
不仅参数量存在落差,训练耗时同样有口径分裂。当前项目的说明文件中并未给出 13 秒的标准化基准测试,而是将宣传语修正为在 1 分钟内训练一个微型 GPT。项目实际记录的收敛数据,是在 hn1g.txt 数据集上喂了 15 亿 tokens(1.5B)后,压缩率达到 2.5295 BPB。
所谓的十几秒,本质上是在极小参数与极短上下文下跑出来的特定切片。
裸金属压榨:脱离 Python 的底层实验
如果抛开带有噱头色彩的宣传口径,TurboGPT 在纯系统工程层面依然有其亮眼之处。
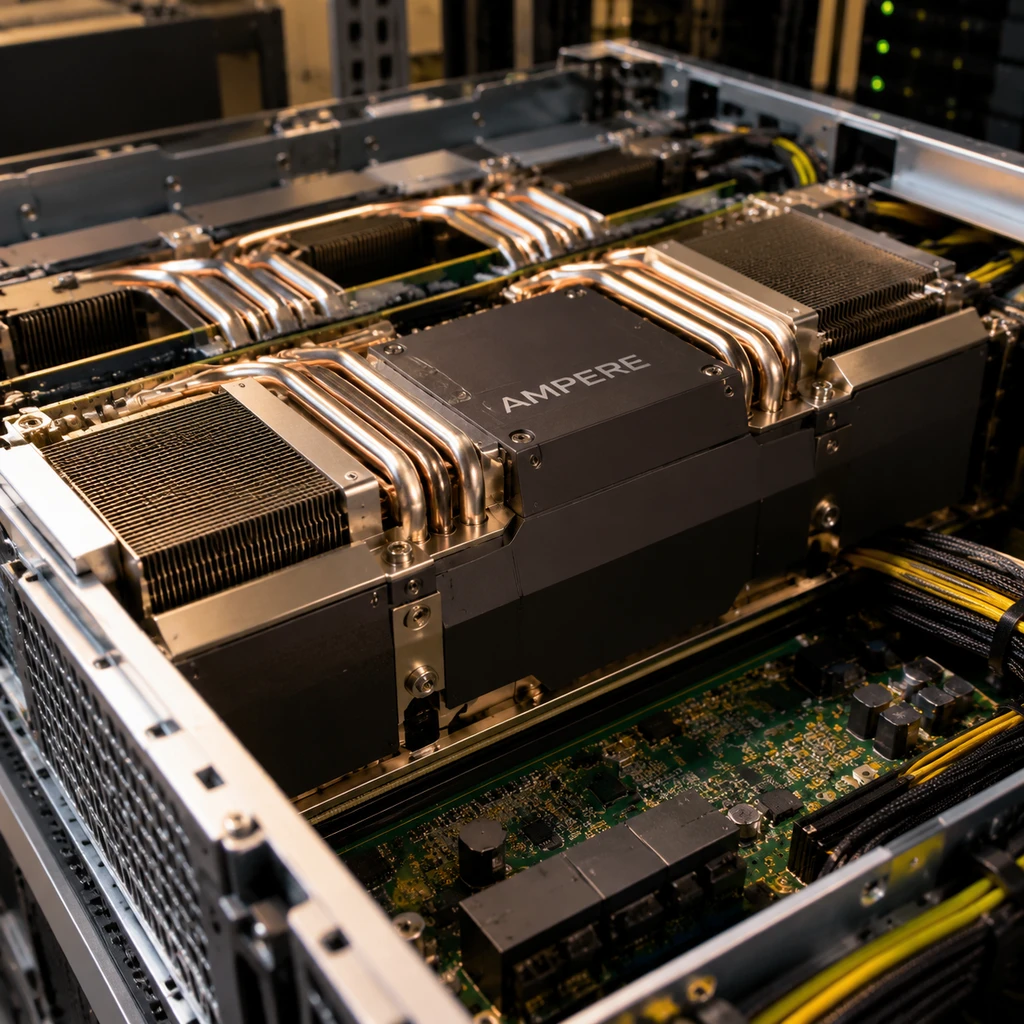
它彻底绕开了 PyTorch、LibTorch 等主流深度学习框架的运行时,选择用纯 CUDA C++ 裸写整个前向传播与反向传播循环。构建系统支持 Linux、NixOS 以及 Windows 平台下的 Visual Studio 2022,强制依赖 CUDA 13.4,基准构建针对的是代号 sm_86 的 NVIDIA Ampere 架构。
在调度与优化上,项目引入了新型优化器 Muon,设定学习率为 0.02,并配合 Adam 类参数(学习率 0.0006、动量 0.95、beta 参数为 0.9 与 0.95)。它甚至允许在 inflight > 1 时进行乱序且带有陈旧梯度的异步更新,最大程度挤出流水线延迟。
这种设计的初衷与此前 Andrej Karpathy 开源的 llm.c 一脉相承,目标是剔除 Python 层的解释开销、内存拷贝以及多余的算子抽象,把控制权直接交还给 GPU。
- 结论.剥离庞大框架运行时的纯 C++ 方案,为深入理解 CUDA 底层显存搬运与算子融合提供了清晰的教学样本。
算力饥饿与四字节的认知玩具
工程上的极致压榨,掩盖不了模型结构本身的严重残缺。
在现代高吞吐 GPU 架构下,极小模型反而会撞上严重的物理瓶颈。NVIDIA Ampere 架构拥有规模庞大的流式多处理器(SM),面对一个仅有 2 万参数的网络,硬件算力根本无法达到饱和。
GPU 处理这种极小网络时,大量时间并没有消耗在张量核心的浮点计算上,而是耗费在频繁的 kernel 启动开销、主机与设备的隐式同步以及微小显存块的搬运上。
更为严峻的是表达能力的坍塌。业界广为人知的教学基准 nanoGPT,在莎士比亚数据集上的经典配置拥有 10.7M 参数,FP32 权重约 43 MiB,单张 A100 训练约需 3 分钟。虽然它也是玩具模型,但足以拟合出具备基本戏剧韵律的英文句子。
相比之下,TurboGPT 的参数规模仅为 nanoGPT 的千分之二。4 个字节的上下文窗口,甚至不足以容纳一个完整的英文单词或中文词组。古人云:刻舟求剑,不亦惑乎。试图通过裁掉上下文和参数来证明训练变快,无异于卸下车辆的全部承重结构,只推着轮毂狂奔。
它无法形成上下文注意力机制,更遑论语法逻辑或语义常识,其最终产物仅仅是对极狭窄字节共现概率的过拟合。
- 风险.切勿将微型算子基准误判为大模型生产力工具,该项目无法支撑任何需要逻辑推理或实际代码生成的业务场景。
TurboGPT 是一份值得算子开发者研读的底层范式,它把 CUDA 编程技巧展现得淋漓尽致。但在评判 AI 系统的演进时,速度若脱离了表征能力的基准线,就只是一场数字游戏。