为了让大模型在五个分类工单里选一个,或者判断一张质检照片是否合格,很多团队一直在忍受荒唐的工程代价。系统必须跑一遍完整的自回归解码循环,按输出 token 掏钱,再战战兢兢地解析随时可能少了个逗号的 JSON 字符串。
工业控制和边缘网关不需要会写长文的聊天助手,只需要毫秒级落地的确定性开关。2026 年 10 月 7 日,脱胎于麻省理工学院 CSAIL 的 Liquid AI 开源了端侧多模态决策模型 d1 家族,包含 3.12B 参数的 d1-3B 与 587M 参数的全模态 d1-omni-600M。它的核心改动只有一条:彻底拔掉文本生成头,单次前向传播直接输出结构化判决,把输出 token 数量清零。
把生成模型改造成只给判断的判别网络,看似是用奥卡姆剃刀割除了大模型的虚火。但在极致压缩的毫秒级反应背后,多模态输入的强行阉割与未知分布下的泛化崩塌,正在暴露出这种架构极难回避的工程代偿。
撕开自回归的边缘开关
d1 追求的不是长篇大论,而是把分类概率直接映射出来。它输出三种类型化结果:判别是非的布尔值、选择具名标签的选项分布,以及输出期望等级的数值评分。
单次前向传播砍掉了逐字读写显存的开销。在桌面显卡 RTX 4090 上,d1-3B 的单问题时延被压缩至 8 毫秒;在 AMD MI325X 上为 9 毫秒。放在低功耗嵌入式板卡上同样迅速:Jetson AGX Thor 为 16 毫秒,Orin 64GB 为 26 毫秒,Apple M5 Pro 为 30 毫秒,即便是最小的 Orin Nano 也只要 50 毫秒。
对需要挤进 10Hz 控制闭环的具身机械臂与工厂闸机而言,50 毫秒以内的本地时延确实具备杀伤力。但早先传闻的云端免费 API 并不存在,Liquid AI 官方明确表示不提供托管接口,模型仅以开源权重形式发布在 Hugging Face,必须由开发者自备硬件部署。
零输出不仅不是凭空跑出来的黑魔法,在算力分配上也并非全额免单。它省掉的只是解码生成过程,文本预填充、SigLIP2 NaFlex 的多模态图像编码与音频特征抽取,该耗的算力一分都不会少。
跑分滤镜与模态割裂
为了证明架构的统治力,Liquid AI 拿出了一份包含 38 项测试的 Decision Index 0.2.1 基准。官方数据显示,d1-3B 跑出 48.57 分,越级压过了 35B 参数的 Decider 35B-A3B(47.11 分)。
但翻开详细测试项,这套模型的成色出现了严重割裂。在 11 个公开图像基准中,d1-3B 平均分仅为 74.1,对比基座 LFM2.5-VL-3B 的 73.9 只涨了 0.2 分。所谓的多模态决策能力,根本没有带来视觉理解的深层演进,本质上只是给成熟的视觉编码器重新焊上了一个判别头。
更成问题的是官方评测口径的分歧。官方博文宣称 d1-3B 在 7 项文本基准的均分为 82.9,但 Hugging Face 模型卡显示的公开数据却是 77.1。由于中途加入了 HelpSteer2 评测并更换了基准组合,加上缺乏同行评审的正式技术报告,第三方重现的成本被大幅推高。
| 核心指标 / 限制 | d1-3B (主力版) | d1-omni-600M (实验版) |
|---|---|---|
| 物理参数量 / 基座模型 | 3.12B / LFM2.5-VL-3B | 587M / LFM2.5-Encoder-350M |
| 模态支持形式 | 文本 + 图像 | 文本 + 图像 或 文本 + 音频 (两者互斥) |
| 上下文 / 截断限制 | 32,768 tokens 全长 | 图像模式截断至 896 tokens / 音频上限 30 秒 |
| 决策基准总分 (Decision Index) | 48.57 分 | 15.95 分 (几乎不可用) |
| 部署精度 / 开源协议 | BF16 / lfm1.0 | FP16 / lfm1.0 |
为了塞进 587M 的参数躯壳,同台发布的 d1-omni-600M 付出了近乎粗暴的工程代价。它在 Decision Index 上仅拿到 15.95 分,几乎处于不可用状态。更致命的是模态互斥:图像与音频输入不能共存;一旦输入图片,文本提示词被硬性截断到 896 tokens,音频则被死死卡在 30 秒上限。这显然只是一个仓促放出的早期检查点。
泛化雪崩与盲目自信的数学隐患
比起格式截断,真正致命的危险潜伏在数学层面。自回归模型虽然臃肿,但在逐字解码时隐式更新注意力,能依靠较长的推理步骤缓冲逻辑偏差;单次前向模型只走一步就必须敲定输出,剥离了一切自省和回溯的余地。
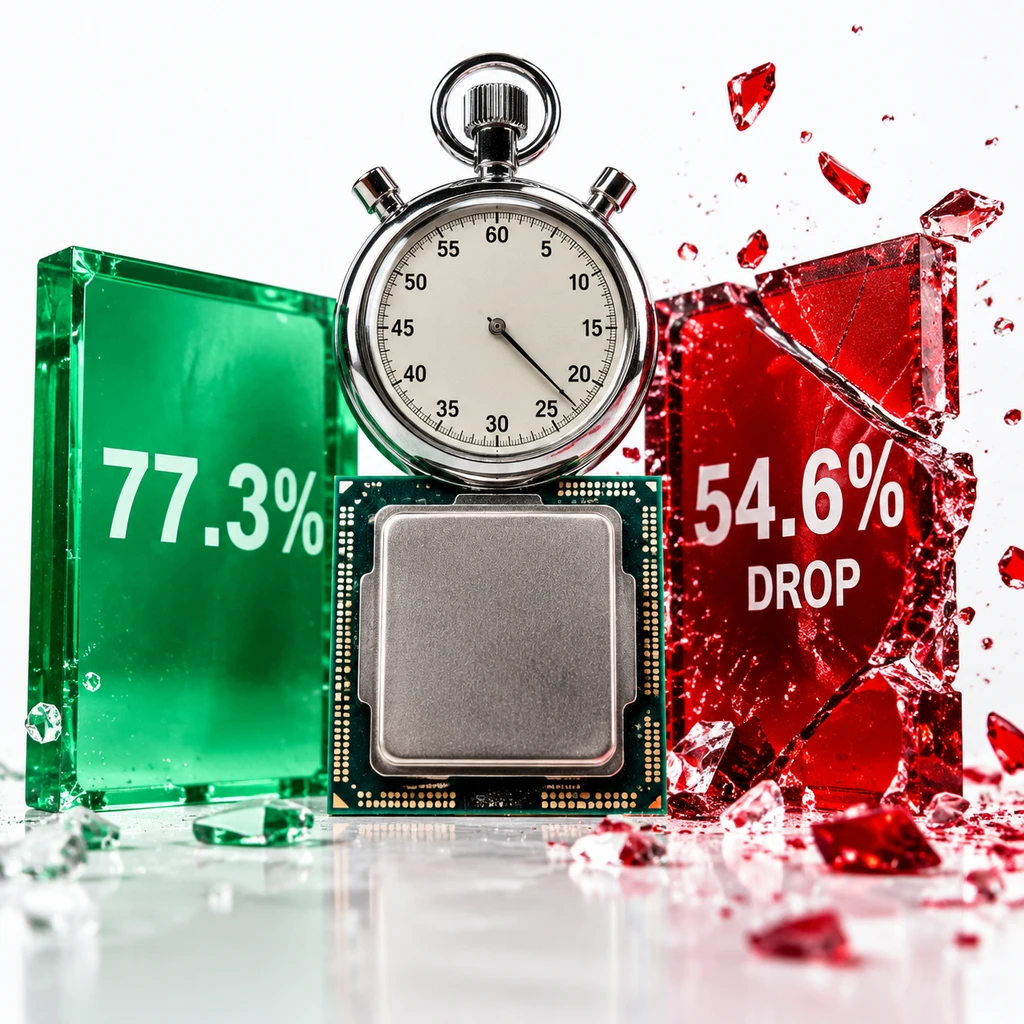
对该架构原型的实测揭示了惨淡的泛化落差。在域内测试中能拿到 77.3% 准确率的模型,一旦扔进未见过的域外分布,准确率会断崖式暴跌至 54.6%。这意味着面对生产现场从未标注过的异常工况,模型的裁决基本等同于抛硬币。
雪上加霜的是预期校准误差(ECE)。单次前向输出的 softmax 分布只是数学上的相对比率,不能等同于现实概率。同类竞品在 Banking77 任务上的校准误差扩大到了 0.098,在毫无先验信息的抛硬币测试中,仍然会极其自信地输出超过 0.9 的高分。
这种伪置信度是自动化防线的噩梦。质检系统若将 0.95 当作 95% 的通过把握,遇到未知形变的残次零件,系统会在毫无察觉的高确信状态下一路放行。
选项死线与旧技术的借尸还魂
分类头与指针网络带来的另一个物理约束是选项硬上限。动态输入的候选标签一旦超出模型预设容量,系统不会像通用大模型那样在长上下文里慢慢处理,而是直接抛出越界异常拒绝服务。
技术演进并非只有一种范式。《韩非子》尝言:「长袖善舞,多钱善贾。」然而在边缘计算的严苛现场,算力从来不是可以挥霍的长袖,而是捉襟见肘的功耗与显存。剥掉自回归机制确实能换来极速,但这绝非万能解药。
开发者在不同任务面前,始终面对着三套完全不同的工程账本:
| 架构形态 | 吞吐与延迟 | 选项扩展能力 | 维护与校准成本 |
|---|---|---|---|
| 传统专用编码器 (ModernBERT / DeBERTa) | 毫秒级极速响应 | 极差(仅限写死预设标签) | 极低(权重微小、行为确定) |
| 通用自回归大模型 (JSON 解码) | 缓慢且重载显存 | 极强(支持数百个动态长尾项) | 较高(需防范格式崩溃与延迟) |
| 新型决策模型 (d1-3B / Jev) | 百毫秒内单次遍历 | 中等(动态支持但有硬上限) | 极高(需自建 ECE 置信度校验) |
如果业务面对的是固定标签的工单初筛,百兆参数的 ModernBERT 几年前就能在 CPU 上跑出极低延迟,根本用不着 3B 规模的模型;如果任务充满未知的开放世界上下文,需要逐步调用工具与容错排查,通用的自回归模型依然是唯一的安全兜底。
d1 真正的生存空间被卡在一个狭窄的缝隙里:动态候选集较小、单次判断必须锁死在几十毫秒之内、且允许开发者在外层单独搭建温度缩放校准的边缘场景。把它当作低成本的前置安全哨兵或协议分流器是合理的,但若指望它在缺乏校验机制的情况下直接接管工厂闭环,速度再快,判错也是徒劳。