半秒转写一小时音频,听起来像是在说一条录音多久能出结果。Reson8 这次报的是满批吞吐。它开源了 0.5B 语音识别模型 Rumble-2-Flash,采用 Apache 2.0 许可证,支持 40 多种语言和自动语言识别,也能指定语言、控制数字写法和是否保留填充词。对已经在用 Transformers 或 vLLM 的团队,我更看重它能直接接入现有推理栈。
成绩也够一个小模型上桌。Open ASR Leaderboard 的快照里,Flash 的英文词错误率(WER)是 6.60%,多语言平均错误率是 6.96%。后者混合了中文的字错误率(CER)和其他语言的词错误率。在 Reson8 报告的 AppTek 客服通话测试里,Flash 的 WER 是 7.86%,接近 NVIDIA 30B 的 Nemotron 3.5 Transcribe 所报的 7.78%。
半秒处理一小时,得先把批次填满
Reson8 公布的峰值超过 7,000 RTFx。RTFx 算的是一段处理时间里,系统合计转写了多长的音频。在英文榜单上,模型卡给出的平均值是 6,338 RTFx,测试用的是 H200 和 vLLM。模型卡也附了 vLLM 部署示例,将 max-model-len 设为 4096。
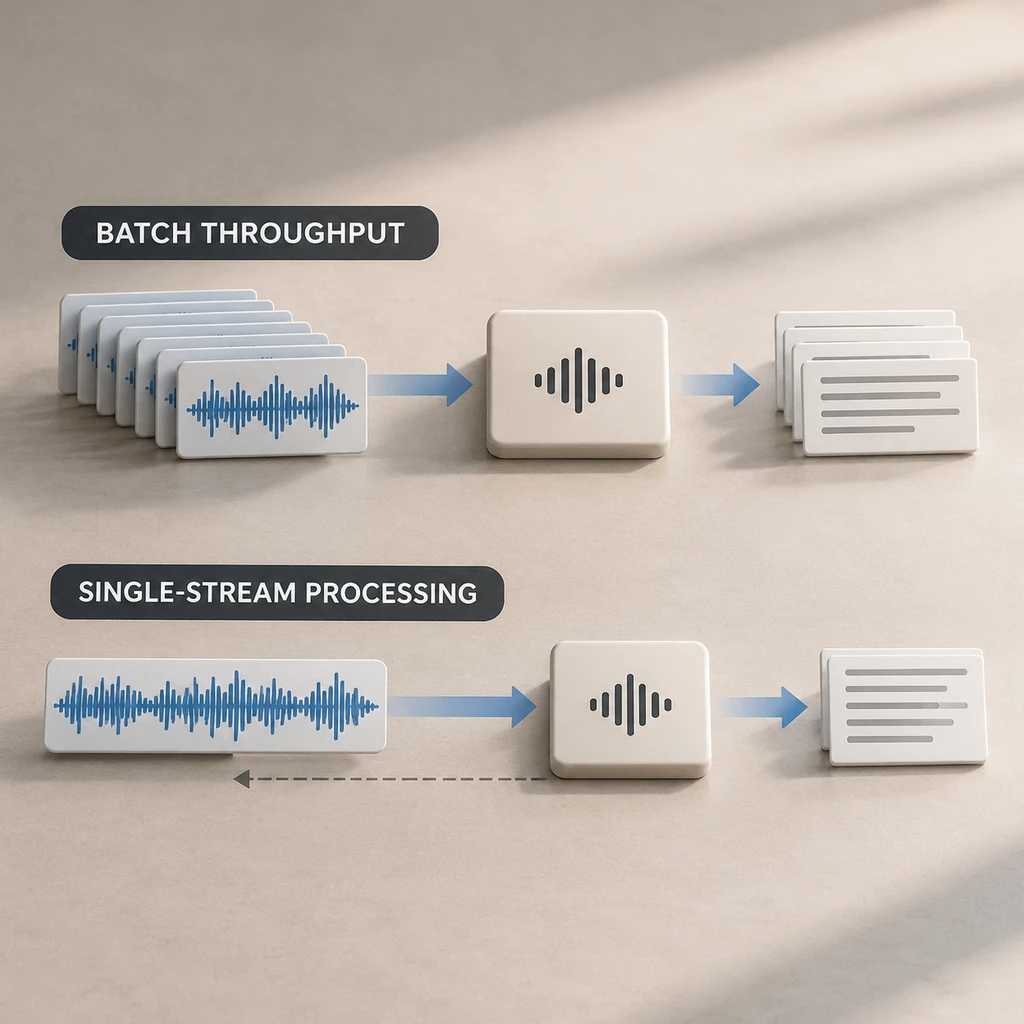
处理积压录音或批量字幕,任务够多,团队可以用吞吐估算清空队列要多久。换成实时客服,用户等的是自己这一段话出字。批量大小、音频长度、排队和切段都会改变等待时间。采购算力时,拿 H200 上的满批峰值去估普通设备的单路延迟,账从起点就算偏了。
电话榜上接近,换一套题就拉开了
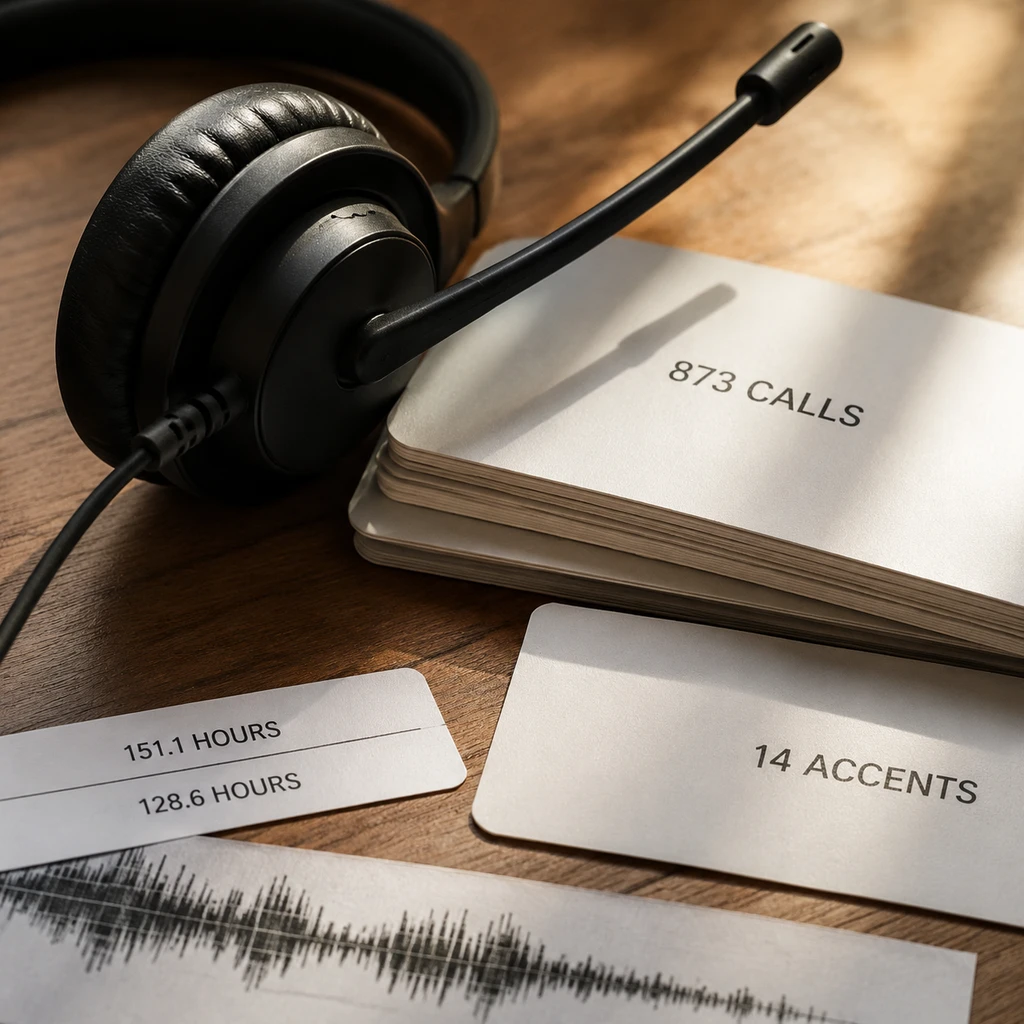
AppTek 的公开资料收录了 873 段角色扮演式客服通话,覆盖 14 种英语口音。合并录音共 151.1 小时,其中语音时长为 128.6 小时。Reson8 所称的 302 小时,可能是将两路通话声道分别计时后的总和,具体口径尚未确认。评测脚本先用 Whisper 的英文归一化规则和数据集自己的映射处理文本,再用 jiwer 统计替换、删除和插入。数据集说明也明说,切段方式会影响 WER。
<svg viewBox='0 0 760 234' width='100%' height='234'>
<rect x='1' y='1' width='758' height='232' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='39' font-size='20' font-weight='700' fill='#b25a3a'>词错误率对照</text>
<line x1='28' y1='54' x2='732' y2='54' stroke='#e2dccf' stroke-width='1'/>
<rect x='184' y='72' width='262' height='134' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='470' y='72' width='262' height='134' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='315' y='99' text-anchor='middle' font-size='16' fill='#2c2822'>Flash</text>
<text x='601' y='99' text-anchor='middle' font-size='16' fill='#2c2822'>Nemotron</text>
<text x='28' y='138' font-size='15' fill='#7a7266'>客服通话</text>
<text x='28' y='182' font-size='15' fill='#7a7266'>英文榜单</text>
<line x1='204' y1='153' x2='426' y2='153' stroke='#e2dccf' stroke-width='1'/>
<line x1='490' y1='153' x2='712' y2='153' stroke='#e2dccf' stroke-width='1'/>
<text x='315' y='138' text-anchor='middle' font-size='23' font-weight='700' fill='#2c2822'>7.86%</text>
<text x='601' y='138' text-anchor='middle' font-size='23' font-weight='700' fill='#2c2822'>7.78%</text>
<text x='315' y='183' text-anchor='middle' font-size='23' font-weight='700' fill='#2c2822'>6.60%</text>
<text x='601' y='183' text-anchor='middle' font-size='23' font-weight='700' fill='#2c2822'>5.33%</text>
</svg>
AppTek 的两个成绩来自 Reson8 的报告,目前缺少独立复现,也缺少按同一批通话配对估计误差的分析。换到公开榜单的快照,Nemotron 的英文 WER 是 5.33%,多语言平均错误率是 4.62%,两项都低于 Flash。独立维护的 Dutch ASR Leaderboard 也曾将 Nemotron 排在第四、Flash 排在第八。这份荷兰语榜单只回答荷兰语场景的问题。要判断电话转写能不能换模型,还得拿同一批录音,固定切段、归一化和计分方式再比。
权重能直接用,蒸馏还缺教师接口
Reson8 用生产模型 Rumble-2 当教师,让采用 Qwen3-ASR 架构的学生先自行转写。教师沿着学生写出的序列,在每个位置给出下一个 token 的概率分布。学生由此能在自己容易漏词或误听的位置获得反馈。师生把同一段文字切成 token 的方式不同,GOLD 会对齐切分边界不同的片段,让两边在对应文本上比较。
公开权重可以直接在 Transformers 和 vLLM 里跑,开发者不用维护定制运行时。训练复现还卡在教师那一端。Rumble-2 的公开 API 文档提供了转写接口,目前找不到能提交学生转写、让教师沿该序列解码并返回逐 token 概率的公开接口。外部研究者可以检验成品,仅凭这个 API 很难重跑整套蒸馏。
上线要算人工复核的账
批量转写团队可以先用积压录音试跑,同一批文件既测吞吐,也看返工量。客服团队还得单独盯住姓名、金额和工单号。漏掉一个口头语和写错一个金额,在 WER 里都可能只算一次错误,人工复核的代价却差得很远。
开头那半秒回答了满批时能跑多快。到了客服生产线,决定 Flash 能接多少活的,是它在实际负载、实际录音上,每处理一小时会留下多少人工校对。