2026 年 11 月 18 日,IBM 与 Confluent 宣布将 Granite 时间序列基础模型接入 Streamhouse。用户可以用 Apache Flink SQL 对流式数据做预测和异常检测,模型在云端和本地都能用 CPU 运行。过去要等批处理交付的预测,现在有机会在补货或生产调整之前送达。能否赶上这些决策窗口,还要看整条数据链路。
Confluent 把预测放进事件流
Flink 可以在接收、清洗和汇总事件的同一作业中,用 SQL 内置函数 AI_FORECAST 和 AI_DETECT_ANOMALIES 生成预测和告警,再把结果交给业务应用。预训练模型也给大量商品或设备序列提供了共同起点,减少逐条建模的工作。
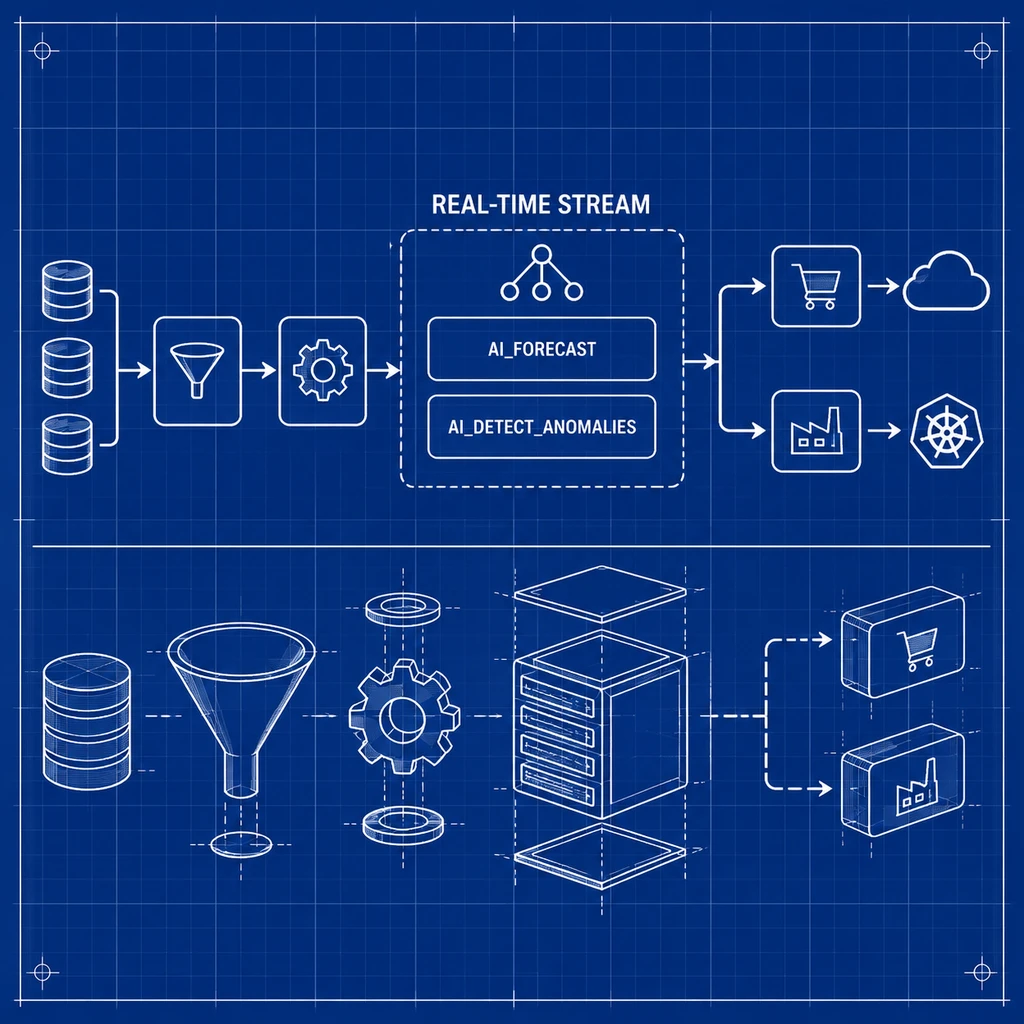
云端由 Confluent 托管模型服务,本地则要在客户自己的 Kubernetes 集群中运行模型服务器。发布时,云端仍是 Early Access,本地仍是 Preview。两种部署都降低了接入门槛,但采购和上线仍需核对预览阶段的模型支持与运维要求。
<svg viewBox='0 0 760 218' width='100%' height='218' role='img'>
  <rect x='1' y='1' width='758' height='216' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
  <text x='28' y='38' fill='#b25a3a' font-size='20' font-weight='700'>从事件到业务动作</text>
  <line x1='28' y1='56' x2='732' y2='56' stroke='#e2dccf'/>
  <rect x='28' y='88' width='154' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
  <rect x='211' y='88' width='154' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
  <rect x='394' y='88' width='154' height='96' rx='10' fill='#fbf9f4' stroke='#b25a3a'/>
  <rect x='577' y='88' width='154' height='96' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
  <line x1='186' y1='136' x2='201' y2='136' stroke='#7a7266'/>
  <polygon points='200,132 207,136 200,140' fill='#7a7266'/>
  <line x1='369' y1='136' x2='384' y2='136' stroke='#7a7266'/>
  <polygon points='383,132 390,136 383,140' fill='#7a7266'/>
  <line x1='552' y1='136' x2='567' y2='136' stroke='#7a7266'/>
  <polygon points='566,132 573,136 566,140' fill='#7a7266'/>
  <text x='105' y='130' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>事件接入</text>
  <text x='105' y='154' text-anchor='middle' fill='#7a7266' font-size='13'>销量或设备读数</text>
  <text x='288' y='130' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>流式处理</text>
  <text x='288' y='154' text-anchor='middle' fill='#7a7266' font-size='13'>清洗与窗口聚合</text>
  <text x='471' y='130' text-anchor='middle' fill='#b25a3a' font-size='17' font-weight='700'>模型推理</text>
  <text x='471' y='154' text-anchor='middle' fill='#7a7266' font-size='13'>预测或异常信号</text>
  <text x='654' y='130' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>业务处置</text>
  <text x='654' y='154' text-anchor='middle' fill='#7a7266' font-size='13'>补货审核或告警</text>
</svg>
CPU 跑分只覆盖 Flink 作业的一段
IBM 公布的超 5000 万次是模型家族的累计下载量。生产采用规模需要看实际接入的作业。TTM-r3 模型卡报告每秒约 180 个样本,TTM-r3 Lite 约 800 个,对比模型约 1 至 20 个,但未注明 CPU 型号或批量大小。TTM 论文另在特定条件下测得 CPU 推理约 0.01 秒,所比较的 TimesFM 配置约 0.4 秒。
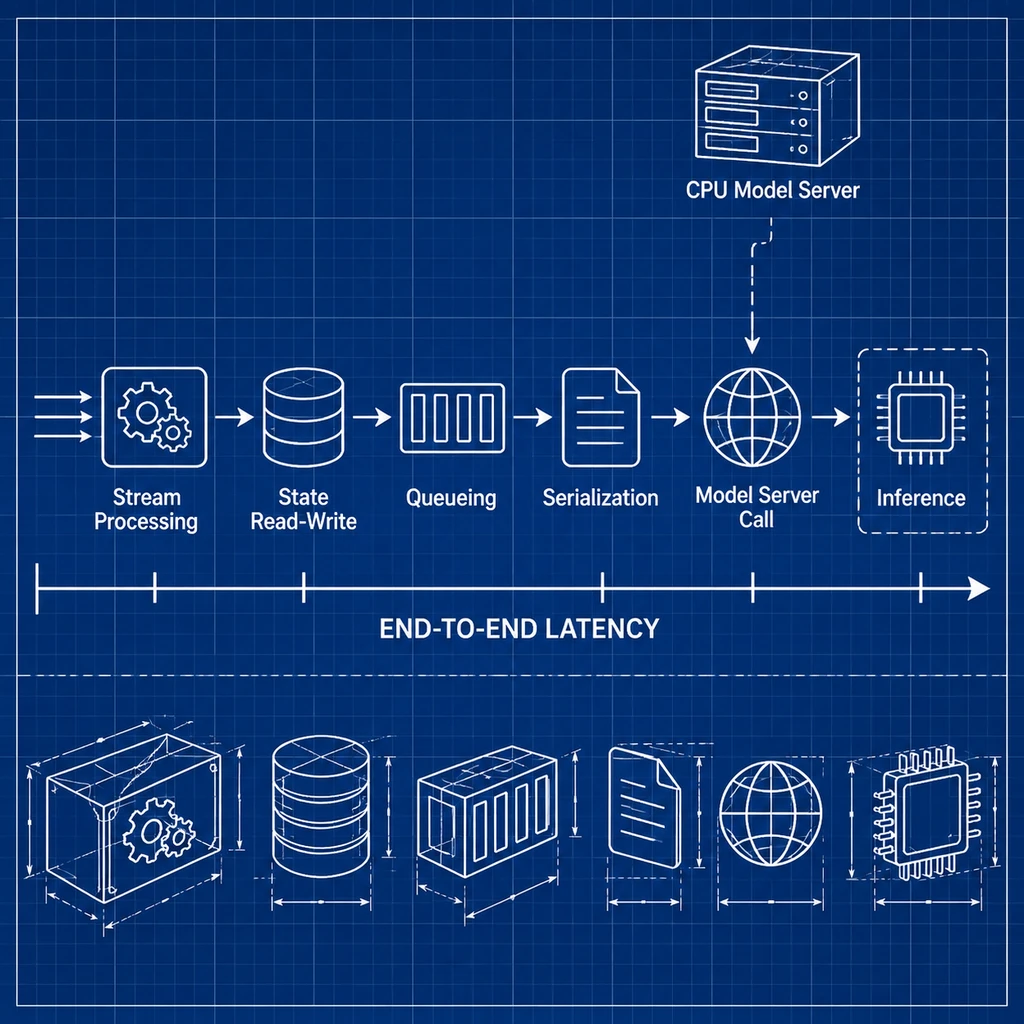
目前没有公开的 Flink 端到端基准。模型跑分只计推理,业务还得等流处理、状态读写、排队和序列化,本地模型服务器的调用也有网络开销。按事件、按窗口还是按聚合更新触发推理,公开材料没有统一答案。活跃序列一多,触发频率就可能决定 CPU 预算和高峰时段的告警延迟。
<svg viewBox='0 0 760 218' width='100%' height='218' role='img'>
  <rect x='1' y='1' width='758' height='216' rx='16' fill='#fbf9f4' stroke='#e2dccf'/>
  <text x='28' y='38' fill='#b25a3a' font-size='20' font-weight='700'>模型跑分与作业验收</text>
  <line x1='28' y1='56' x2='732' y2='56' stroke='#e2dccf'/>
  <rect x='28' y='84' width='340' height='104' rx='10' fill='#fbf9f4' stroke='#e2dccf'/>
  <rect x='392' y='84' width='340' height='104' rx='10' fill='#fbf9f4' stroke='#b25a3a'/>
  <text x='52' y='118' fill='#2c2822' font-size='17' font-weight='700'>公开模型跑分</text>
  <text x='52' y='146' fill='#7a7266' font-size='14'>单次推理耗时</text>
  <text x='52' y='168' fill='#7a7266' font-size='14'>每秒处理样本</text>
  <text x='416' y='118' fill='#b25a3a' font-size='17' font-weight='700'>生产作业待测</text>
  <text x='416' y='146' fill='#7a7266' font-size='14'>并发序列容量</text>
  <text x='416' y='168' fill='#7a7266' font-size='14'>高峰端到端延迟</text>
</svg>
默认告警走 TinyTimeMixer,TSPulse 跑分另有口径
IBM 展示的四款模型各有分工。TTM-r3 主打轻量预测,FlowState-r1.1 可对不规则或混合频率数据做点预测,PatchTST-FM-r1 提供带分位数区间的概率预测,TSPulse 则做异常检测、分类和相似度搜索。Confluent 函数文档列出的可选模型包括 TTM、FlowState、PatchTST-FM 和 TimesFM 2.5,其中未列 TSPulse。
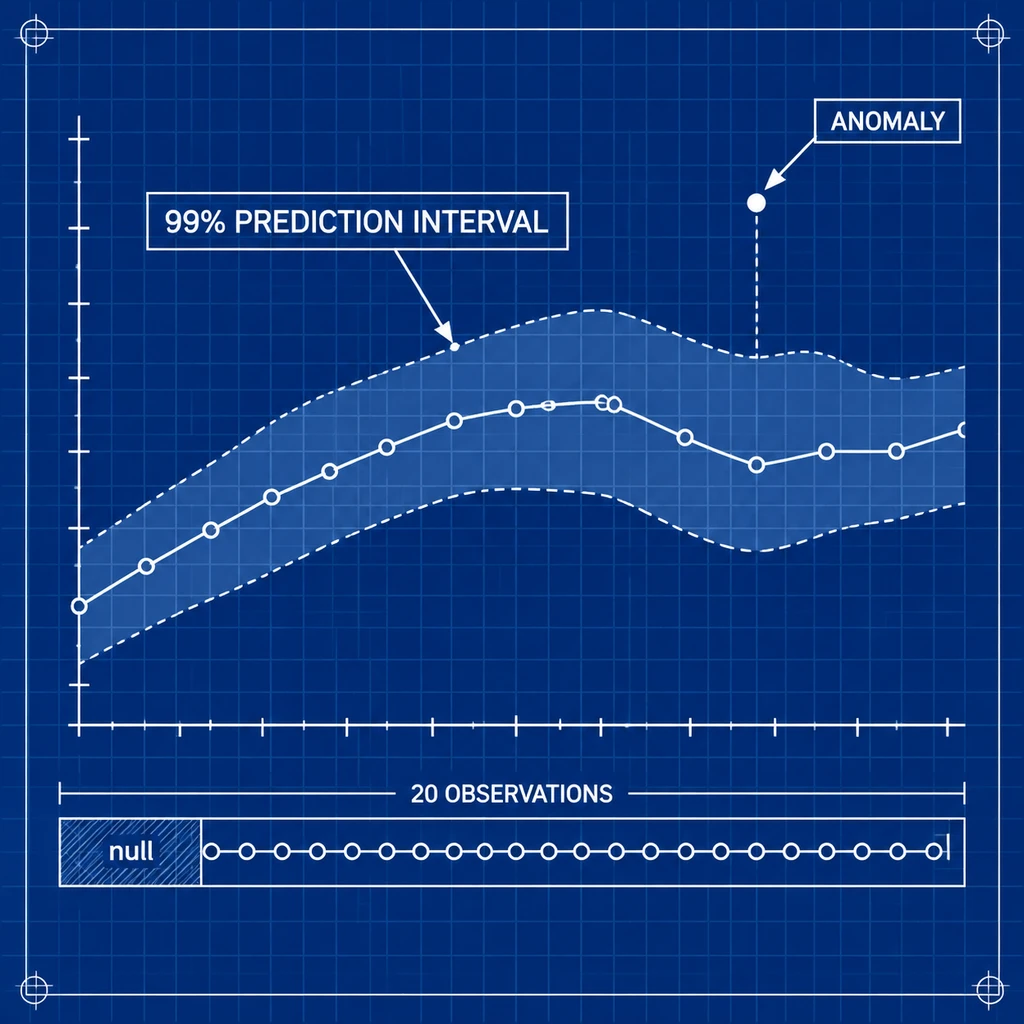
异常函数默认用 TTM,也就是 TinyTimeMixer。观测值落到默认 99% 预测区间之外才会触发异常,积累满 20 个观测值前返回 null。门店若把空值当作正常,新商品就可能在预热期被漏看。TSPulse 在 TSB-AD 单变量基准上的 VUS-PR,零样本为 0.48、微调后为 0.52,衡量的是另一套检测器的表现。
同一事件流回放,比论文排名更接近采购决策
IBM 在 2026 年 9 月 8 日公布的 GIFT-Eval 比较中,PatchTST-FM r2 在无数据泄漏的可复现零样本比较里,点预测 MASE 和概率预测 CRPS 均排第二。常被引用的 TinyTimeMixer r2 归一化 MASE 0.679 则来自逐数据集微调。直接调用预训练 SQL 函数的用户,应以自己的序列评估误差。
Confluent 已有采用 ARIMA 的 ML_FORECAST 和 ML_DETECT_ANOMALIES。数据平台团队可以用同流回放,在相同硬件、历史窗口和预测跨度下,把新函数和 ARIMA、季节性朴素方法放在一起,比较预测误差、误报率、检测延迟、CPU 与内存占用,再记录高峰期的 p95/p99 延迟和故障恢复表现。补货团队据此能判断,多刷几次预测究竟能多挽回多少次缺货,又会多出多少条待复核的采购建议。账算清之前,试点有理由开,替换旧系统的预算还可以等。