当硅谷还在渲染动辄百亿美元的预训练账单时,全栈 AI 实验室 Ricursive Intelligence 在 2026 年 11 月 4 日端出了 Ripple-65B Preview。这是一个采用 Apache 2.0 协议开源权重的 65B 稠密架构模型,底层原本服务于该公司自家的 AI 芯片设计平台,现已在 Hugging Face、Together AI、GMI Cloud、OpenRouter 和 Fireworks 上线。官方账本里最扎眼的数字是 3200 万美元——这笔从零起步、包揽数据配比、阶梯实验与后训练的全部研发总开销,据其估算只有前代美国开源智能体编程 SOTA 模型成本的十分之一。
这头 65B 的小兽在 TerminalBench 2.1 上跑出了 80.52 分,正面压过了 Reflection Beam 501B(80.1 分)、Meta Muse Spark Open 816B(76.4 分)、Thinking Machines Inkling 975B(63.8 分)以及 NVIDIA Nemotron 3 Ultra 550B(56.4 分)。官方还给出了 SWE-bench Pro v2.0 Hard 79.1 分、SWE-bench Verified 76.5 分和 DeepSWE 1.1 44.3 分的成绩单。但如果你顺着新闻稿以为自己马上就能在单台 NVIDIA DGX Spark 桌面机上满血流畅跑起这个冠军模型,或者以为 80.52 分代表了纯粹的裸模代差,那正好踩进了当下开源评测与硬件宣传的盲区。
砍掉 MoE 的工程算计:3200 万美元怎么花在刀刃上
当前开源圈的主流叙事是把混合专家模型(MoE)堆到 500B 甚至 975B,但超大 MoE 在预训练和后训练里伴随极高的通信与基础设施复杂度。Ricursive 反其道而行,选了 65B 的稠密(Dense)Transformer 架构,走窄而深的路线(隐藏层维度 5120,共 80 层),在英伟达硬件上不写一行自定义算子、不做训练期量化,仅靠简单分片就把训练算力利用率(MFU)死死稳在 40%。
为了在小参数量里榨出推理能力,团队在架构上做了精细的对冲:超额配置注意力头数量,同时提高滑动窗口注意力(SWA)与全局层的比例、缩小窗口尺寸来抵消算力开销,并叠加上 FFN 激活裁剪、门控注意力、全局 NoPE 和值残差。在以 Olmo 3 为起点的 6 轮模型阶梯实验中,他们引入 StepFun 缩放定律优化批次与学习率,并在 4B 规模果断砍掉了小规模有效但放大后失效的双流 mHC 设计,配合大幅上采样代码的 12 万亿 token 预训练语料,最终用 16 倍的算力效率优势跑赢了基准。
后训练阶段同样克制。他们在长上下文训练与 SFT 阶段把序列拉到了 2M(官方对外宣称支持 1M 上下文),且一分钱外部后训练数据都没买,全靠自建长程合成环境与难度递进课程。这套采用截断重要性采样、分数中心化和线性长度惩罚的强化学习配方,只跑了 700 个训练步、140 万次采样(rollouts),采样量是前任冠军 Reflection Beam 的七十分之一。
0.42 分还是 9.7 分:脚手架里的评测罗生门
把工程账本翻过面,我不太买账的是这次围绕 SOTA 展开的榜单叙事。仔细看官方给的王冠定语,前面精准地焊死了美国开源权重(U.S. Open-Weight)几个字,既避开了闭源前沿模型,也巧妙绕开了海外开源强手的同台竞速。
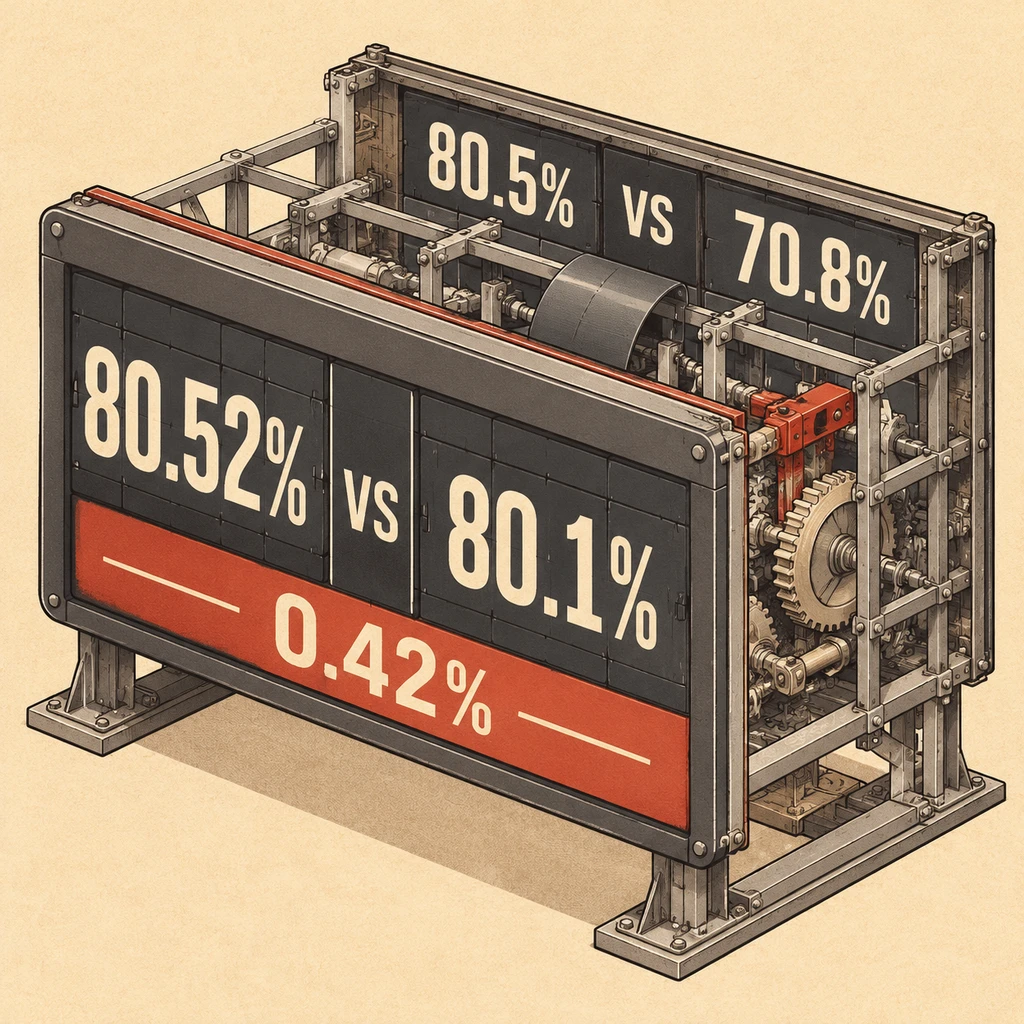
更耐人寻味的是 TerminalBench 2.1 上的两组分裂数据。在新闻稿头版的自报成绩里,Ripple-65B 的 80.52 分只比 Reflection Beam 501B 的 80.1 分高出 0.42 个百分点,属于贴身肉搏;但在模型卡披露的另一组对照里,当把双方统一塞进 Terminus 2 脚手架(128K 上下文带摘要)测试时,Ripple 依然稳在 80.5%,而 Beam 直接暴跌到了 70.8%,分差瞬间拉大到 9.7 个百分点。
| 评测模型 | 参数规模与架构 | 头版自报成绩 | 统一 Terminus 2 脚手架成绩 | 默认适配脚手架 |
|---|---|---|---|---|
| Ripple-65B Preview | 65B Dense | 80.52% | 80.5% | OpenCode / Terminus 2 |
| Reflection Beam | 501B MoE | 80.1% | 70.8% | 官方推荐自研 Mirror |
| Meta Muse Spark Open | 816B MoE | 76.4% | 未披露 | 各自默认配置 |
| Thinking Machines Inkling | 975B MoE | 63.8% | 未披露 | 各自默认配置 |
近 10 个百分点的断崖下跌,撕开了智能体编程(Agentic Coding)评测长期心照不宣的底牌。模型早就不在真空里写代码了,Ricursive 的评测重度依赖 OpenCode 与 Terminus 2 脚手架,而竞争对手 Reflection 官方推荐的是自研的 Mirror 脚手架。把别人的模型塞进自己调优过的上下文摘要容器里,无异于让客队穿主队尺码的球鞋上场。
智能体编程早已没有裸模跑分,谁掌握脚手架,谁就握着计分牌。
况且,TerminalBench 2.1 官方仓库目前已关闭社区提交,仅接受维护者亲自跑满 5 次试验、完成公开 Harbor 上传与轨迹审查的记录。截至发稿,80.52 分仍停留在厂商自报阶段,尚未走完独立复现与数据去污染审计。
算清本地运行的物理硬账:DGX Spark 塞不下满血版
新闻稿里另一个极具诱惑力的卖点,是宣称小巧的稠密参数包能让 Ripple-65B 在 NVIDIA DGX Spark 这类高算力、低内存带宽的本地设备上高效运行。如果真能把击败 500B 巨兽的满血编程大脑装进桌面主机,本地开发者的硬件采购逻辑都会改写;但只要拿出计算器核对一遍 Hugging Face 仓库,这层滤镜就会碎掉。
主仓库提供的 BF16 完整指令微调权重,下载体积约为 130 GB,而单台 NVIDIA DGX Spark 的共享内存上限只有 128 GB。不用算操作系统和 1M 上下文的 KV Cache 开销,光是把满血模型权重搬进去,内存就已经溢出了。
要想塞进 DGX Spark,开发者只能退而求其次,去下载官方另行发布的 57.2 GB 实验性 NVFP4 混合量化版本(仅量化 MLP 层,注意力层保留 BF16)。但官方所有 80.52 分的漂亮跑分全是在 BF16 下测出来的,这个实验性量化版到底掉了多少点,目前没有任何验证数据。更要命的是带宽墙:模型卡里高调展示的 250 tokens/s 推理速度,实际是在两张数据中心级 B200 GPU(batch size 为 8)上跑出来的;放到内存带宽只有 273 GB/s 的 DGX Spark 上,哪怕跑 57.2 GB 的阉割版,常规单序列解码的理论物理上限也只有 每秒 4.8 个 token 左右。靠每秒不到 5 个字的速度去跑动辄消耗几十万 token 的长程智能体编程,体验只能说是灾难。
- 提醒.打算为本地代码智能体采购桌面级硬件的团队,切勿将 B200 的并发吞吐当成端侧速度,务必等 NVFP4 量化版的独立精度与实测延迟报告出炉后再动手。
醉翁之意不在开源:一堂 3200 万美元的芯片招生广告
既然端侧跑不快、榜单还有待复核,Ricursive 为什么要急着把底牌亮出来?韩非子有言,善持势者,早绝其奸萌。但放在商业博弈里,善借势者往往用副业打主业的广告。
回看二十世纪九十年代的 PC 显卡大战,最顶尖的硬件厂商往往自己写测试基准或引擎 Demo,表面上是给玩家送福利,骨子里是为了定义下一代硬件的负载标准。今天的情况不完全一样,但商业激励如出一辙。Ricursive 的真正主业是用 AI 设计芯片、再用芯片反哺 AI 的软硬件闭环平台,开源出来的 Ripple-65B Preview 只是其内部专有芯片设计模型的通用变体。
花 3200 万美元训出一个能压倒千亿 MoE 的编程模型,对开源大模型厂商(Meta、NVIDIA、Reflection)是一记性价比闷棍,逼着行业重新审视中尺寸稠密架构的潜力;而对 Ricursive 自己来说,这笔钱既是向半导体客户证明底层基座实力的技术背书,也是文末那句招聘链接最响亮的招牌。至于开发者,先别急着把 130 GB 的权重往桌面机里硬塞,紧盯接下来第三方在统一脚手架下的复现分,以及 57.2 GB 量化版在真实代码仓库里的掉点幅度,才是眼下最划算的省钱之道。