2026年11月4日,Dharma-AI在Hugging Face博客发布了参数量仅20亿(2B)的文档结构化提取模型Dharma Field Extractor,宣称无需针对特定单据微调,就能把发票、医疗申请单、身份证件和合同图像直接转成指定结构的JSON数据,表现超越所有受测前沿大模型,且运行成本比商业API低6至147倍。把这套漂亮的数据拆开看,所谓的越级挑战建立在容忍字符微瑕的复合计分公式、限制对手推理预算,以及拿裸卡电费单对比云厂商零售价的错位算法之上。
跳过纯文本OCR,用4.3万条样本直出JSON
企业在做文档自动化处理时,最头疼的往往不是认不出纸上的字,而是怎么把字塞进数据库对应的列里。传统的OCR引擎搭配正则表达式或版面解析代码,能把合同或发票逐行还原成文本,可一旦供应商换了发票排版,下游字段映射代码就会报错。通用多模态大模型虽然能看图直出JSON,但在每天成千上万张单据的流水线上,视觉Token费用和响应延迟让企业IT部门难以长期承担。
Dharma-AI给出的解法是用垂直小模型跳过中间的纯文本OCR环节。这款2B提取器以经监督微调(SFT)和直接偏好优化(DPO)打磨的DharmaOCR-LITE v1.1为底座,再通过43,384条样本训练LoRA适配器。训练数据分三路收集:公开网页上的英文多领域单据、内部采集的巴西葡萄牙语真实业务文档,以及少量欧洲和亚洲语种样本,覆盖收据、商业发票、银行对账单与身份证件。
模型在调用时提供两种方式:一种是不给预设结构的开放提取(Open),由模型根据版面自己判断键值对和表格;另一种是Schema引导提取(Schema-directed),开发者直接传入目标数据库里已有的字段名和数据类型(支持字符串、数字、布尔值及嵌套表格)。遇到单据上没有的字段,模型会返回null而不是凭空编造。在未参与训练的SROIE收据和FUNSD表单公开数据集上,它能把多行未标注账单地址合并成单个字段,也能在12项复选框里准确识别出唯一打钩并带有手写备注的选项。
0.834分力压旗舰背后,藏着两道主场规则
真正让技术圈停下来细看的,是Dharma Field Extractor在官方基准测试里交出的成绩单。测试涵盖546份文档、3种请求场景(无Schema开放提取、仅含真实字段的部分Schema、故意混入不存在字段的Schema),共1,638个测试用例。
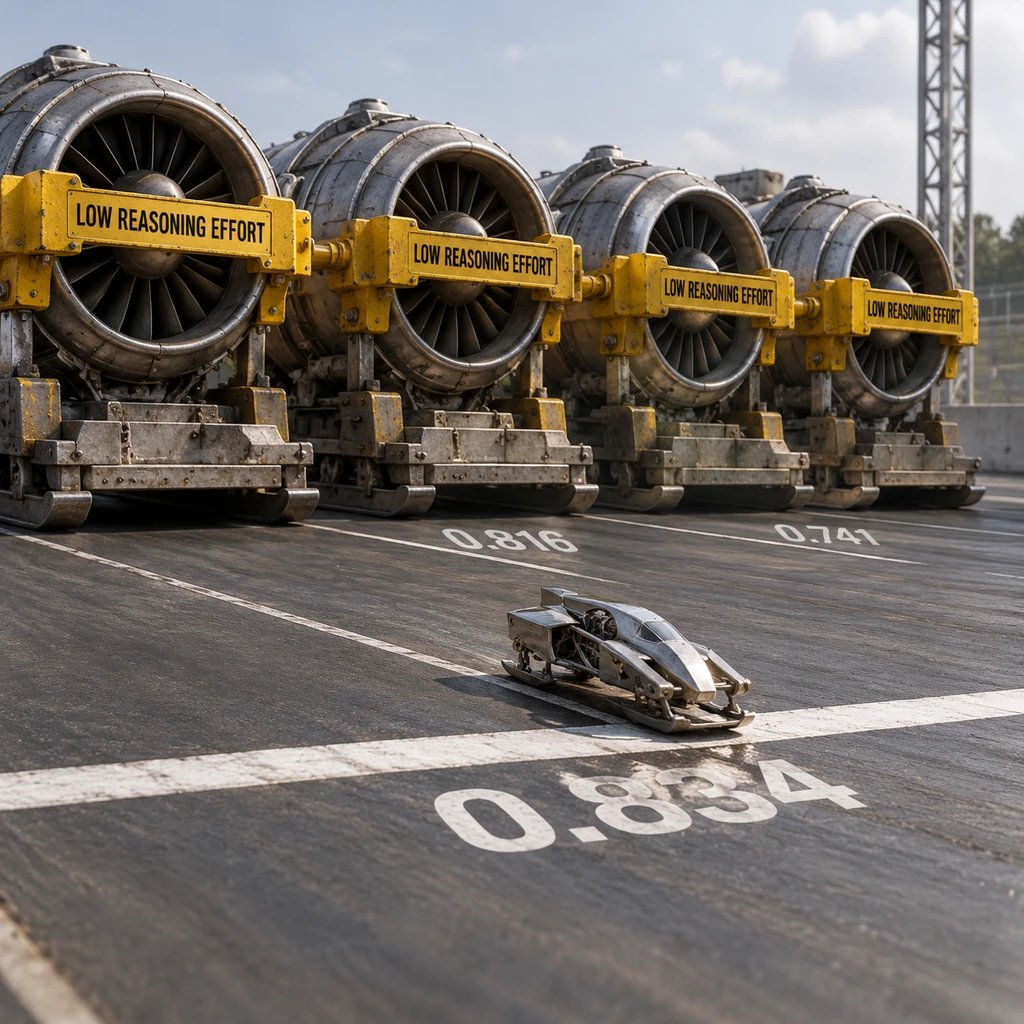
在这套测试里,2B模型拿到了0.834分,把同场竞技的4个前沿大模型配置全部压在身下——离它最近的Claude Opus 5得分为0.816,差距最大的GPT-5.6 Luna只有0.741(官方正文并未完整列出全部4个受测前沿配置的明细表)。一个小巧的2B适配器为什么能赢下参数量大自己百倍的旗舰?秘密藏在计分公式和对手的应战限制里。
财务入库对金额与账号零容忍,99%的字符相似度在生产系统里等于100%的坏账。
官方采用的并非文档级完全正确率,而是把“路径匹配字段F1 × 匹配值Levenshtein编辑距离相似度 × 合法JSON比例”三者相乘。引入编辑距离相似度意味着,一张十万块钱的供应商发票如果漏看或看错了一个数字,或者身份证号错了一位,在字符串相似度上依然能拿到接近满分的权重。可在企业的ERP、财务核算和医疗排期系统里,金额或账号差一个字符就是彻头彻尾的错误,后面必须跟上人工复核。
- 风险.前沿大模型在测试中均被强制设为低推理强度(low reasoning effort),Claude Opus 5开启的自适应模式也会在简单页面跳过推理;且官方未单独披露混入不存在字段时的幻觉率,也未开放评测脚本供第三方复现。
裸卡时租对比商业API,开源社区并非免费午餐
另一组抓人眼球的数字是“成本降低6倍(对比GPT-5.6 Luna)至147倍(对比GPT-5.6 Sol)”。如果你是企业数据工程团队负责人,准备拿着这个倍数去向老板申请替换现有的大模型API预算,最好先算清两边的计价口径。
前沿大模型的成本,是按单页实际消耗的输入、输出及推理Token,乘以云厂商公开挂牌零售价算出来的;而Dharma-AI的成本,是按单张L40S显卡每小时2.24美元的租赁电费单折算的。官方在文末坦承这并非销售报价,同时也没有公布2B提取器的SaaS按页定价或具体的单页延迟与吞吐量数据(作为参考,其前代3B模型Dharma-OCR-LITE在L40S上的延迟为1.464秒/页)。拿理想满载状态下的裸金属硬件成本,去比包含运维、弹性扩容和商业毛利的云端API零售价,算出来的倍数在真实采购中很难原样兑现。
更关键的一步在于合规与交付形态。这篇文章虽然发在Hugging Face社区,极易让开发者误以为又多了一个可以免费拉下来私有化部署的2B开源利器,但官方目前并未公开2B提取器的模型权重或LoRA适配器,只放出了一个需要登录的在线试用入口。翻看其前代底座Dharma-OCR-LITE的许可协议,采用的是非OSI开源的DharmaOCR Lite Noncommercial License 2026,明文禁止任何未经书面授权的商业及营利性企业内部使用。
- 建议.拉美葡语区或英文单据量庞大的金融、医疗与法务团队,可以把Dharma的在线Demo当成压降大模型API账单的备选探路石,但在正式签单或替换流水线前,必须用本企业的真实票据重测“字段100%精确匹配率”,并向厂商索要包含商业授权费与并发SLA的真实报价单。