2026 年 11 月 4 日,AI 研究机构 Interconnects 主理人 Nathan Lambert 公开了追踪开源模型采用率的免费数据看板 Interconnects Dashboard,并首次将 Fireworks、Baseten、Together AI 三家开源推理初创公司的 Token 吞吐量与 Google 财报数据进行同台对标。数据直接回答了笼罩行业已久的疑问,开源模型推理早已不是 OpenAI 或 Anthropic 身后的舍入误差,头部开源推理平台的日均吞吐量已跨入 40 万亿至 50 万亿 tokens 的工业级量级。但把物理流量与商业账本放在一起审计就会发现一个残酷的反差,开源模型在公有网关抢下了超七成的物理流量,却只分走约两成的账面收入。
日均 40T 吞吐直追大厂,但“破百亿”推算踩中口径陷阱
过去评估开源权重模型的繁荣度,行业习惯看 Hugging Face 的静态跑分或仓库下载量,而后者只统计 GET 与 HEAD 文件请求,根本无法反映生产环境里的真实调用。随着多步推理和 GLM 5.2 带来的开源 Agent 跃升,实际推理 Token 吞吐量成了唯一的硬标尺。
把各家最新披露的数据拉到同一张桌面上,开源推理平台的体量已经相当可观。Baseten 首席执行官 Tuhin Srivastava 在 2026 年 9 月 15 日的访谈中透露,其平台日均推理量已达 40 万亿至 50 万亿 tokens,年度增长达 40 倍;Together AI 在 7 月 8 日披露其月度 API 吞吐量在 9 个月内从 300 亿飙升至超 400 万亿 tokens,折合日均约 13.3 万亿 tokens。作为参照,Alphabet 在 10 月 28 日发布的 2026 年 Q3 财报中披露,Google 第一方模型 API 吞吐量接近每分钟 320 亿 tokens(环比增长 40%、同比增长超 4 倍),按 30 天折算相当于每月约 1382 万亿 tokens,即每天约 46 万亿 tokens;而 OpenAI 最新可查的同类披露还停留在 4 月 8 日公布的每分钟超 150 亿 tokens(月折算超 648 万亿 tokens)。单看物理吞吐量,Baseten 或 Fireworks 单一平台的日均规模,已经与 Google 第一方 API 处于同一数量级。
但把初创公司的宣传口径直接当成严谨的统计基数,极易掉进外推陷阱。Nathan Lambert 在笔记中提到,Fireworks 在 11 月初的首届公司大会上宣布向“客户定制模型”日均提供超 40 万亿 tokens(较夏季增长超 2 倍),他因此把“客户定制模型”当成局部业务切片,乐观预测 Fireworks 今年秋季的总日均推理量将远超 100 万亿 tokens。
核查 Fireworks 早在 2026 年 7 月 15 日发布的 D 轮融资官方公告就会发现,“日均服务超 40 万亿 tokens”当时就是作为公司整体服务量披露的,且公告明确注明其中超 95% 的 Token 来自基于客户专有数据特化的定制模型。既然定制模型本身就占了总盘子的 95% 以上,把它当成局部切片再去翻倍外推“总盘子破 100 万亿”,在统计逻辑上并不成立。
- 风险.跨平台比对 Token 规模还面临严重的底层会计失真。各家披露不仅存在时间错位(如拿 OpenAI 的 4 月基数对比 Google 的 10 月数据)和瞬时峰值折算月度总量的误差,更缺乏统一的计量准则——AWS Bedrock 会通过 CloudWatch 严格区分输入、输出与缓存读写 Token,而不同平台对缓存命中(Cached tokens)、思维链推理(Reasoning tokens)是否计入总量各自为政,叠加不同模型原生分词器(Tokenizer)的编码效率差异,账面 Token 数字天然带有水分。
七成流量只换两成收入,中国开源模型全面接管网关
如果只看对数增长曲线,开源模型似乎正在平分天下;可一旦引入财务支出维度,开源推理赛道“赚吆喝不赚钱”的商业剪刀差就会暴露无遗。
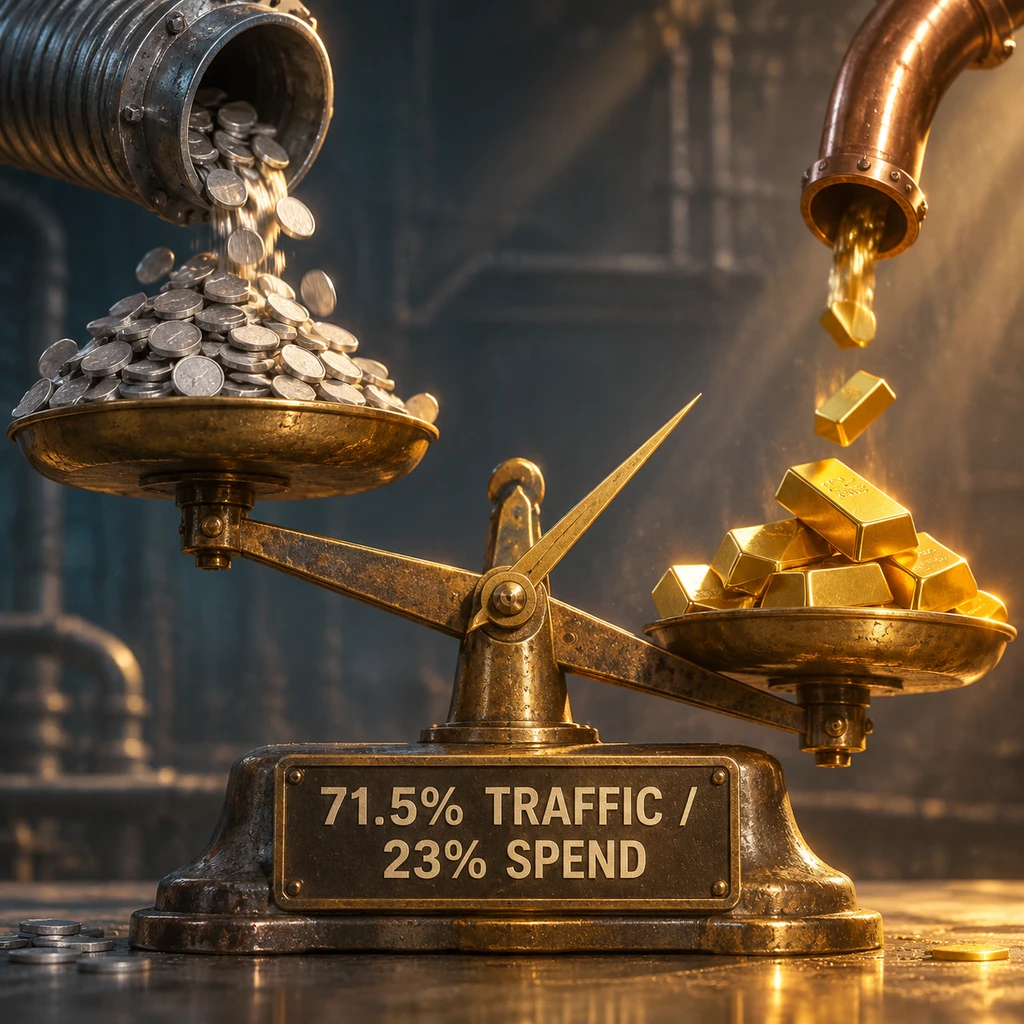
Vercel 在 2026 年 10 月 15 日发布的 AI Gateway 生产指数报告揭开了这层窗户纸。2026 年 9 月,开源权重模型吞下了该网关 71.5% 的 Token 流量,但按公开目录价估算,它们只分走了 23% 的账面支出;反观闭源模型,仅凭 28.5% 的 Token 流量就拿走了 77% 的支出。而在 Vercel 前一期(8 月)报告中,这种分化更加极端,开源模型占 56% 流量却只换回 14% 支出,Anthropic 一家就凭高溢价复杂任务捕获了整个网关 64% 的估算支出。
开源模型吃下七成算力苦活,闭源巨头拿走八成高毛利账单。
除了开源与闭源的价值倒挂,开源阵营内部的权力交接同样剧烈。在另一家主流聚合网关 OpenRouter 公布的 2026 年 10 月 26 日当周文本请求份额(按请求数统计)中,中国模型已经成为绝对主力:
| 模型厂商 / 系列 | 10 月末周请求份额 | 阵营归属与地位 |
|---|---|---|
| DeepSeek | 29.8% | 开源权重,全网第一 |
| OpenAI | 18.8% | 闭源第一方 |
| 14.4% | 闭源第一方 | |
| Z.ai (GLM 系列) | 11.9% | 开源权重,Agent 跃升核心 |
| Anthropic | 5.7% | 闭源第一方,高客单价 |
| Qwen | 5.6% | 开源权重,主力底座 |
| Mistral / 腾讯 / Meta Llama | 2.2% / 1.9% / 1.5% | Llama 份额已跌至边缘 |
在开发者高频调用的聚合路由层,DeepSeek、Z.ai 与 Qwen 合计拿走了近半壁江山,而昔日开源标杆 Meta Llama 的请求占比已萎缩至 1.5%。
双向黑盒与推理初创公司的唯一活路
看到 OpenRouter 或 Vercel 的数据后,业界常有一种直觉,既然公开网关统计不到企业基于 vLLM 在私有集群上的自托管流量,那么开源模型在全球的真实占比一定比网关数字还要高。
这种推论忽略了分母端的黑盒。OpenRouter 在其覆盖超 100 万亿 tokens 元数据的年度研究中明确说明,网关数据排除了本地私有部署和封闭内部系统;但网关同样漏掉了全球大企业直连 OpenAI、Anthropic 官方 API 的巨额流量,以及托管在 Amazon Bedrock 和 Azure Model Garden 内部且从未按模型类别拆分披露的黑盒调用。vLLM 仅在算子侧暴露本地计数器,云大厂又对模型分类三缄其口,分子(私有开源自托管)与分母(大厂直连与云托管闭源)同时缺失,使得任何人也无法在数学上判定净偏差的方向。
弄清这套账本后,两类直接做预算决策的人需要调整动作。
对于 Fireworks、Baseten 和 Together AI 这类开源推理基础设施公司,靠低价倾销标准开源模型 API 是一条死胡同。当 71.5% 的流量只能换回 23% 的账面收入时,纯拼标准接口吞吐量只会沦为算力搬运工。Fireworks 之所以能撑起估值,关键在于其超 95% 的流量都绑在“客户专有数据定制模型”上——只有把企业客户拉进微调、强化学习与专属吞吐托管的管线里,才能跳出公有网关的比价泥潭。
对于正在规划 AI 预算的企业技术负责人,当前最划算的架构不再是“非开即闭”,而是利用聚合网关把 70% 以上的高频、结构化与子 Agent 任务切给 DeepSeek、GLM 5.2 或 Qwen 的定制微调版,仅将最复杂的顶层规划留给 Anthropic 或 OpenAI。接下来真正决定开源推理商业成败的变量,不是哪家初创公司又宣布日均突破了 100 万亿 tokens,而是随着 GLM 5.2 等开源模型补齐 Agent 短板,开源阵营在网关里的账面支出占比能否从 23% 实质性跨过 40% 的分水岭。
- 结论.物理 Token 吞吐量证明了开源模型的工业可用性,但支出占比才代表真实的商业议价权;盯紧定制化微调占比与单 Token 变现率,远比盯着对数增长图更有价值。