9 个月时间,语音 AI 平台 Retell AI 的月通话量从 3000 万暴涨到 超过 1 亿次,服务超 4000 家企业,累计吃掉 OpenAI 模型超 1 万亿 tokens。OpenAI 在 2026 年 10 月 27 日把这份成绩单挂上官网,核心叙事很直接:平台上 80% 的通话响应由 GPT-6 Astra、GPT-5.5 等 OpenAI 模型生成,客户问题解决率超过 80%,模型首句中位延迟压到了 497 毫秒至 883 毫秒。
如果你是一家企业的 CIO 或客服负责人,只看这份公关喜报就去签采购合同,大概率会踩坑。把 Retell 自己的底层评测数据和第三方真实电话拨测对照着看,就会发现大模型厂商宣传的实验室跑分,和真实电话线上的生产环境,完全是两本账。
推理开关背后的跑分温差
先看 OpenAI 拿来背书的成绩单:在 Retell 自建的 2026 年 10 月 13 日 vCX 基准测试中,GPT-6 Astra 以 89.7% 的指令遵循率排第一(Retell 实时榜单默认视图里,其 Grounding 为 96.7%、工具调用 94.6%、延迟 849 毫秒);而在 GPT-6 Astra 发布前,开启推理(reasoning enabled)的 GPT-5.5 在非幻觉率(88.0%)和工具调用准确率(88.3%)上,双双击败了 Gemini-3.1-Pro 和 Claude-4.6。
客户端的标杆数字同样漂亮:Anker 在美英的一线售后支持用它查订单、做保修排查,拿到 80.4% 的解决率和 63 的净推荐值(NPS);医疗机构 Pine Park Health 用它做预约提醒,接通后的预约转化率达到 55.7%,省下了相当于 2.1 个全职医疗助理的时间;Retell 内部工程师还靠 Codex 查代码、修 Bug,并用 GPT-6 Astra 的计算机使用能力自动点击测试前端界面,让人均年化营收跑到了 160 万美元。
但这里藏着实时语音场景最残酷的悖论:电话那头的活人等不起模型慢慢思考。为了把响应时间控制在人类能容忍的范围内,企业在生产环境(production 模式)里往往必须关闭深度推理,或者把推理调到最低档。
翻开 Retell 在 2026 年 10 月 19 日发布的 vCX-Hard 底层数据(采样自 2026 年 2 月 6 日至 5 月 1 日的真实生产流量,含 2075 个幻觉案例和 1514 个工具调用案例),一旦关掉推理进入生产模式,排位立刻洗牌:
| 模型名称 | 非幻觉率(生产 / 最佳) | 工具调用准确率(生产 / 最佳) |
|---|---|---|
| GPT-5.5 | 84.8% / 88.0% | 75.6% / 88.3% |
| Gemini-3.1-Pro | 82.6% / 83.6% | 85.7% / 85.9% |
| Claude-4.6-Sonnet | 81.2% / 81.6% | 80.1% / 80.4% |
去掉深度推理的拐杖后,GPT-5.5 的工具调用准确率从 88.3% 暴跌到 75.6%,反而比 Gemini-3.1-Pro 的 85.7% 低了整整 10 个百分点。而在客服场景里,工具调用哪怕错一次,就意味着查错订单状态或改错预约时间。更何况,这套 vCX 基准本身是由供应商自己构建、用前沿模型组成的委员会打分,官方也承认存在裁判偏见,且没有公开数据集供外部复现。
消失的一秒钟去哪了
第二个容易让人产生幻觉的数字,是延迟。
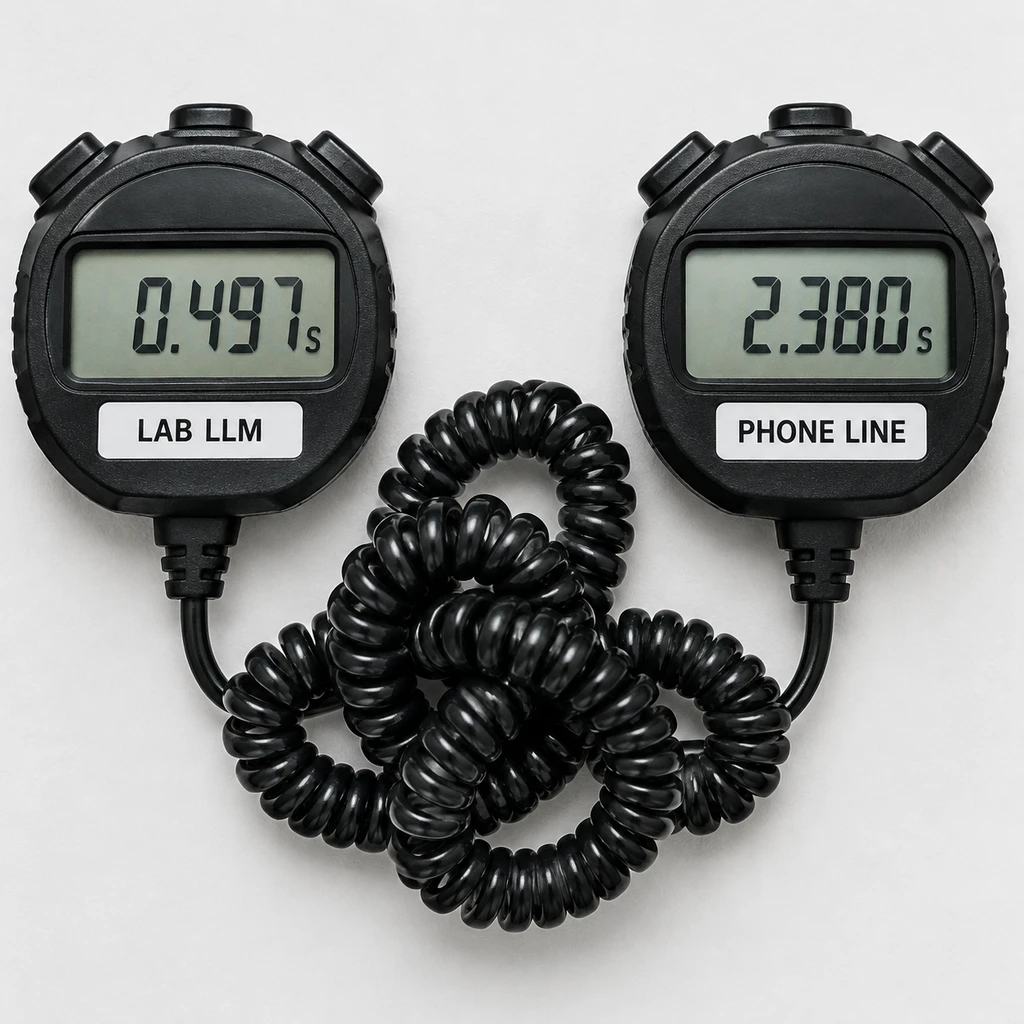
OpenAI 原文写得很清楚,在 10 月 13 日的测试里,GPT-6 Astra 和 GPT-6 Sol 的首句中位延迟是 883 毫秒,最快的 GPT-5.6 Luna 只要 497 毫秒。不到一秒,听起来跟真人接话差不多快。
但这只是大模型吐出第一个词的时间,不是客户举着手机听到的时间。一通真实电话要走完语音识别(STT)、大模型推理、工具调用、语音合成(TTS),还要穿过运营商的电话网。
第三方机构 OpenBenchmarks 对 5 个平台打了 550 通电话(共 2078 个可用对话轮次),从真实呼叫方测出来的中位响应延迟:Bland AI 是 1.520 秒(p95 为 2.248 秒),Vapi 是 1.558 秒(p95 为 2.008 秒),Retell AI 是 1.740 秒(p95 为 2.259 秒)。而在另一家机构 Cekura 对公开生产电话线的测试里,排名又反了过来:Retell 为 2.38 秒,Bland 为 2.62 秒,Vapi 高达 3.34 秒。
实验室里争的是几百毫秒,电话线上漏掉的是一整秒。
多出来的这一秒多钟,正是 Retell、Vapi、Bland 这类语音中间层平台真正卖钱的地方。Retell 平台白天的流量峰值是夜间低谷的 50 倍以上,为了不在高峰期卡壳,他们必须跟 OpenAI 租用跨客户共享的专用服务器,用区域 API 端点就近路由流量(顺便满足医疗和金融的数据驻留合规),还要自己维护双电话栈冗余——主栈挂了,备用电话栈、备用语音和备用模型立刻顶上。
早期贝尔实验室铺设跨洋电话线时,工程师最怕的不是平时声音不够亮,而是高峰期回声抑制器失灵和交换机阻塞。今天的语音 Agent 也一样,Demo 里聊得再像真人,扛不住早高峰 50 倍的并发洪峰,或者在用户插话打断时乱了阵脚,照样上不了生产环境。
隐性账单与转人工的脏活
现在企业级语音 AI 中间层基本形成了三强割据:Retell 偏重开箱即用的运营配置与可视化工作流,Vapi 偏重底层工程控制与供应商灵活拼装,Bland 则主打打包基础设施与重度企业级支持。
很多采购方只盯着表面上的每分钟单价看,觉得几美分一分钟简直白菜价,等账单出来才发现全是累加项。
算细账的话,Retell 的语音基础设施是 0.055 美元/分钟,加上平台语音 0.015 美元、美国电话费 0.015 美元以及大模型费用,默认计算器跑下来大约是 0.125 美元/分钟,这还没算知识库、降噪和安全护栏等附加费;Vapi 虽然标着 0.05 美元/分钟的托管费,但模型和语音供应商全得另算,要签带 99% 可用性保障的 Pro 支持包最低得交 999 美元/月,医疗行业加个 HIPAA 合规还得再掏 2000 美元/月;Bland 的打包价看着省心(0.12 到 0.14 美元/分钟),但一遇到呼叫转接,每分钟还得再收 0.04 到 0.05 美元。
比计费猫腻更决定生死的,是那 20% 解决不了的问题怎么转给真人员工。《韩非子》里讲,千丈之堤,以蝼蚁之穴溃。语音客服的蚁穴,往往就在转人工(Warm Transfer)的那十几秒里。
真实企业的客服热线前面往往挡着好几层传统按键菜单(IVR)和排队队列。如果 AI 决定转人工,直接把电话甩过去,客户就得重新听一遍音乐、再跟真人把事情复述一遍。在这件事上,Retell 把脏活做得比较细:它的 Agent 可以自己穿越对方的 IVR 菜单、替客户在内部队列里等着,接通真人坐席后,先用私密耳语简报(whisper debrief)把前因后果交代清楚、回答完坐席的追问,确认坐席准备好了,再把客户切进来,挂断后还用 GPT-5.6 Terra 分析录音提取结果写回系统。相比之下,Vapi 文档里基于助手的暖转接目前还挂着实验性(Experimental)的标签。
这也是我不太买账笼统的 80% 解决率 的原因。行业里根本没有统一的审计口径:一通电话算解决了,到底是 AI 真的改好了数据库,还是转给人工后由真人擦了屁股,又或者是客户听烦了直接挂断、且三天内懒得再打进来?
- 风险.如果只按每分钟通话单价和笼统的解决率招投标,企业极易买回一个在简单问答上刷高分、却在关闭推理调工具和转人工排队时频繁掉链子的半成品。
对于准备把客服热线交给语音 Agent 的团队来说,现在最该做的不是去争论 GPT-6 Astra 和 Gemini-3.1-Pro 谁的极限跑分高,而是把采购验收标准彻底改写。在 PoC 测试里,直接把大模型推理关到生产环境档位,拿最刁钻的内部工单去测 p95 端到端延迟、测 CRM 状态写入的真实准确率、测坐席占线时暖转接的失败降级分支。把账本的计价单位从每分钟多少钱,换成每一次真实验证解决的成本(cost per verified resolution),谁在裸泳,一算便知。