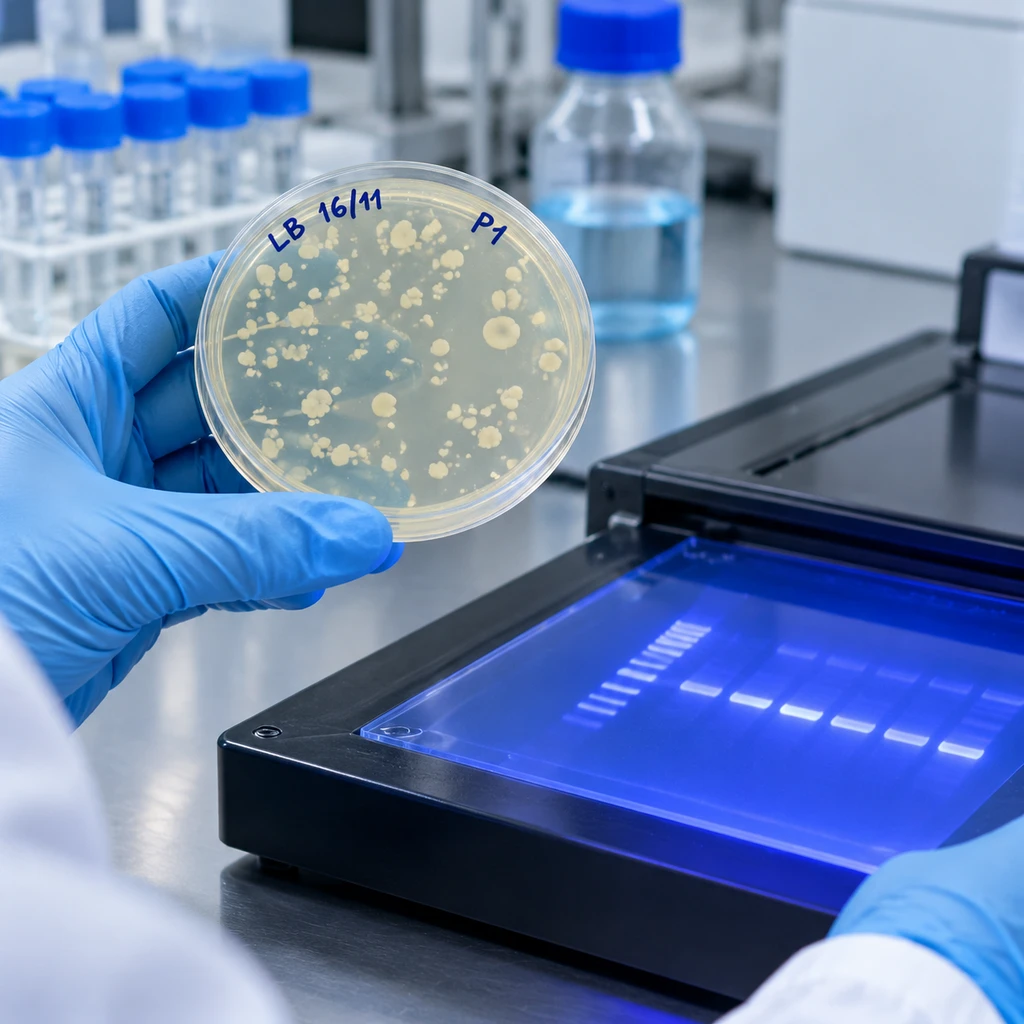
2026年11月6日,OpenAI联合酶设计生物技术公司Ligo发布了BioBasicsBench基准,用100项涵盖蛋白质分析、分子克隆等五大领域的日常湿实验任务,测试AI处理原始实验数据和排查错误的能力。在7款模型累计18,500次测试中,GPT-6 Astra在xhigh推理设置下拿到66.7%的平均得分,远超前代GPT-5.6 Sol的43.8%。生命科学AI的评测终于走下论文精修图的神坛,开始直面实验室里的脏数据与失败对照;原生多模态能力带来了代际跃升,但模型习惯用书本先验假设覆盖实验对照的毛病,意味着它目前只能做排错辅助,远未到替代研究员拍板的时候。
告别论文精修图:OpenAI联合Ligo把湿实验脏数据拉入评测
过去的生物AI基准大多拿期刊论文里筛选修饰过的图表当考题,而一线研究员每天面对的却是跑花掉的电泳胶图、贴歪的手写标签和互相矛盾的仪器读数。BioBasicsBench直接用Ligo科学家的真实实验记录出题,包含31项跑胶与印迹任务、27项实验协议与手写笔记分析,以及显微图像、测序文件和实验台操作视频(单任务常包含多类数据,标签统计存在重叠)。
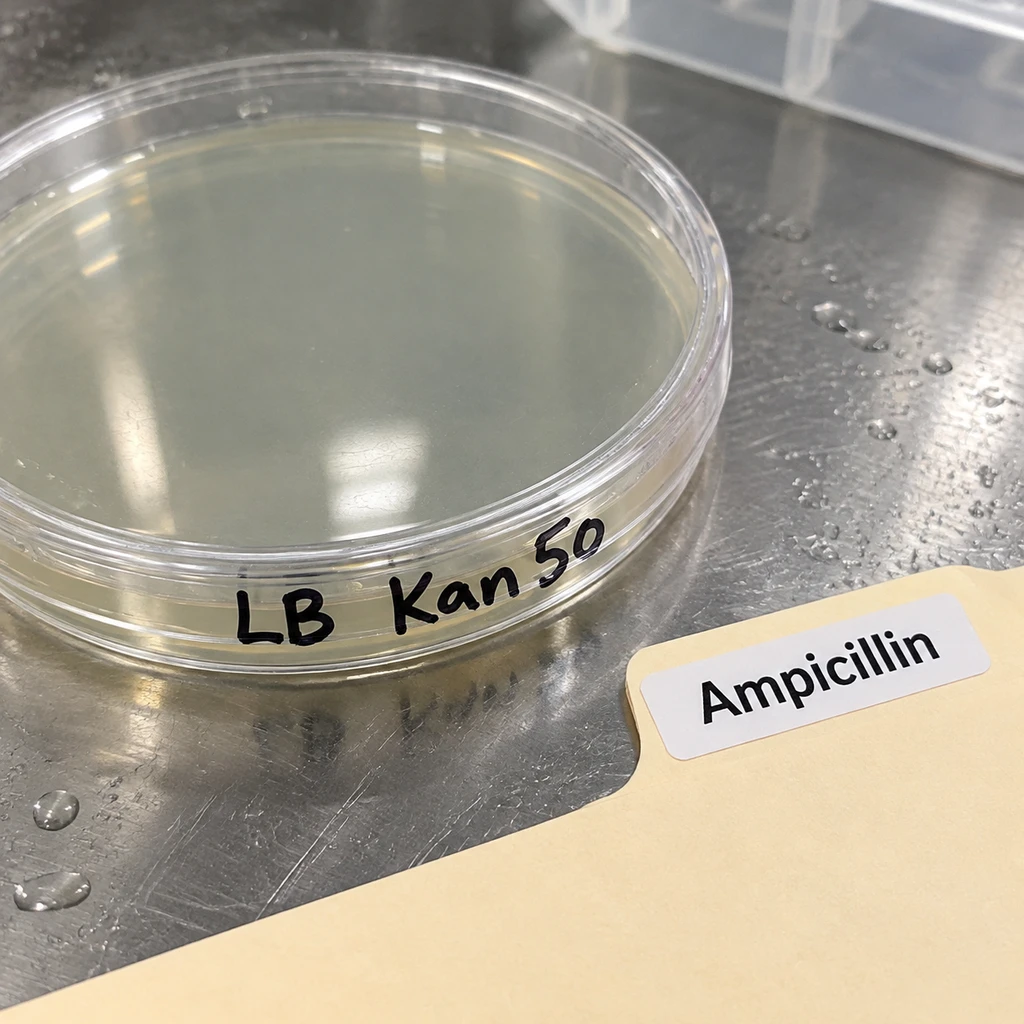
这种脏数据测试直接拉开了模型差距。在一项DNA克隆实验中,阴性对照培养皿上没有长出菌落,GPT-5.6 Sol据此直接判定对照有效并推导结论;而GPT-6 Astra看清了培养皿边缘手写的LB Kan50(卡那霉素)字样,发现它与实验本该使用的氨苄青霉素不符,当场推翻无效对照。面对显微镜下忽明忽暗的细胞视频,前代模型还在硬找生物学解释,Astra已经认出这是不同焦深拍摄的Z轴层扫(z-stack)。
省Token又防踩坑:原生多模态如何改变排错效率与采购账本
对生物医药研发团队和AI for Science工具采购方来说,这次评测最值得盯紧的变化是精度与推理成本的反向剪刀差。过去模型看图不准,只能靠长篇累牍的文本推理硬凑答案;GPT-6 Astra凭原生多模态能力直接从图像细节抓证据,在xhigh设置下不仅得分比GPT-5.6 Sol高出22.9个百分点,单任务平均输出还从9,099个Token降到了4,704个Token。
| 模型版本 | 平均得分 (xhigh) | 95% 置信区间 | 单任务输出 Token |
|---|---|---|---|
| GPT-6 Astra | 66.7% | 60.3–73.1% | 4,704 |
| GPT-6.1 Sol | 62.0% | 55.6–68.4% | 5,238 |
| GPT-5.6 Sol | 43.8% | 37.6–50.0% | 9,099 |
| GPT-6 Luna | 38.3% | 32.3–44.5% | 13,120 |
| GPT-5.2 | 31.2% | 26.2–36.3% | 27,620 |
技术团队在升级API时算得清这笔账。更少的输出Token意味着更低的响应延迟和调用账单,同时还能减少研究员被错误结论误导而白做下游实验的耗材损耗。比如在双染料细胞活性检测中,两个通道在525–540纳米波段存在串光干扰,GPT-6 Astra没有像前代那样盲目判定细胞死亡,而是要求补充对照实验来分离信号。
- 建议.技术采购方可将日常排错工作流从GPT-5系列切换至GPT-6 Astra,在提升初筛准确率的同时砍掉近一半的Token预算,但需留意这套评测的前提是人类专家已将质粒图谱、分子量标准(Ladder)等参考资料打包喂给模型,它还不是能在实验室端到端自主采集数据的智能体。
先验假设压倒阴性对照:剩下的33.3%失分是湿实验不敢放权的红线
拿到66.7%的高分,绝不意味着一线研究员可以把实验结论交给AI拍板。恰恰相反,GPT-6 Astra丢掉的那33.3%分数,暴露出大模型在科学推理上最危险的软肋——当实验证据与模型熟悉的教科书规律冲突时,它会优先相信先验假设,甚至忽略亲眼看到的反面证据。
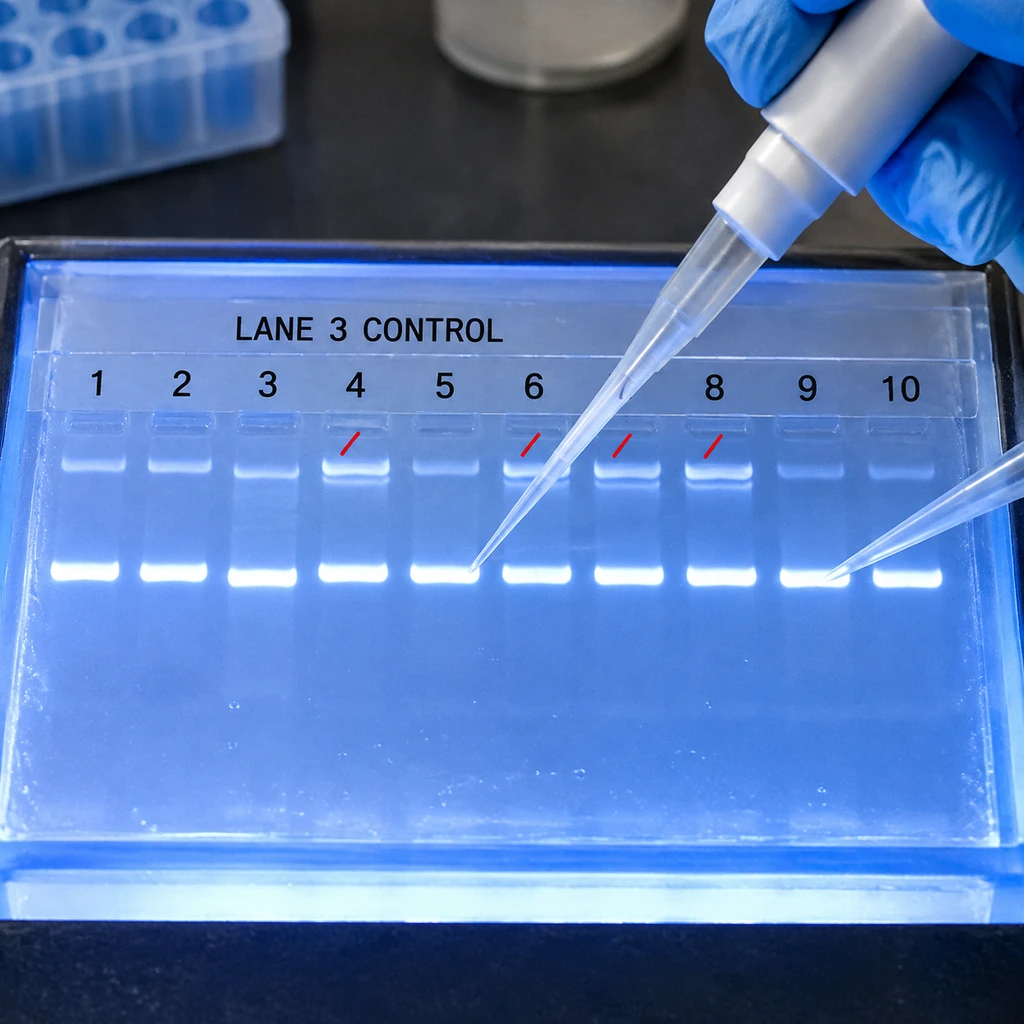
认得出皿边贴错的标签,却改不掉拿先验假设覆盖阴性对照的本能。
在菌落PCR电泳分析任务中,3号泳道是原始质粒对照,2号泳道是组装不完全的混合模板。GPT-6 Astra虽然准确把4至10号菌落分成了两组,却套用大片段代表克隆成功的常见假设,选出了条带更大的4、6、7、8号泳道;而比照3号对照条带位置,真正携带新构建质粒的其实是5、9、10号泳道。一旦听信AI,研究员接下来几天提纯扩增的全是错误质粒。
类似的迎合偏见也出现在显微观察和基础计数里。观察细胞液泡时,Astra明明在中间推理步骤里注意到调整焦距会反转明暗对比,最终结论却剔除了亮色液泡样本,强行总结出液泡比周围细胞更暗的规律;在最基础的平板菌落计数上,它把空白琼脂当成菌落、漏掉可见菌落,导致最终计数比基准高估了约12%,直接虚增了DNA转化效率的测算值。
- 风险.切勿将GPT-6 Astra直接接入自动化湿实验的闭环决策流,在涉及阴性对照比对、焦深变化及精密菌落计数的环节,必须保留人类研究员的复核权。