客户数据平台 Hightouch 于 2026 年 11 月 4 日发布了一份大模型充当数据质检裁判的实测报告。工程团队引入两款专门返回 0 到 1 概率分数的决策模型——TypeSafe AI 的 Jev 与 OpenAI 的 GPT-6 Luna,搭配前沿模型 Claude Opus 5.5,用来抓出企业客户数据库里的过度合并错误(即把多个真实人物错绑成同一个身份档案)。测试结果显示,Jev 搭配 Opus 的级联方案在简单数据集上拿到了 98.8% 的准确率,把每千个身份的审计成本从单用 Opus 的 3.86 美元压到了 0.88 美元。
人工抽检这类脏数据每小时只能看约 50 个身份,要把罕见错误率的统计误差压到正负 1% 以内,至少得抽检 1000 个以上样本,往往拖上几个月。决策模型每审一个身份只要 0.15 到 0.17 秒,每千个身份成本仅 0.05 到 0.10 美元,比前沿模型便宜最高达 90 倍、快 10 倍以上。但在决定企业该掏钱买哪个小模型做初筛时,Hightouch 的测试撞上了一个反直觉的结果。
| 模型或级联方案 | 简单基准准确率 | 简单基准成本/千个 | 高难度基准准确率 | 高难度基准成本/千个 | 单次响应耗时 |
|---|---|---|---|---|---|
| Claude Opus 5.5 | 99.0% | $3.86 | 95.1% | $5.39 | 2.20 s |
| GPT-6 Luna (Decisions API) | 97.3% | $0.10 | 约 89% | $0.10 | 0.17 s |
| Jev | 95.7% | $0.05 | 89.1% | $0.06 | 0.15 s |
| Jev → Opus 混合路由 | 98.8% | $0.88 | 95.3% | $2.94 | 0.63 s |
单打独斗更强的 GPT-6 Luna,为什么在混合架构里输给了 Jev
只看开箱即用的单模型跑分,GPT-6 Luna 在简单基准上拿下了 97.3% 的准确率(70% 阈值),明显压过 Jev 的 95.7%(60% 阈值)。但一旦把它们放进小模型初筛、疑难样本交由 Claude Opus 5.5 兜底的流水线里,开局落后的 Jev 反而成了更好的守门员。
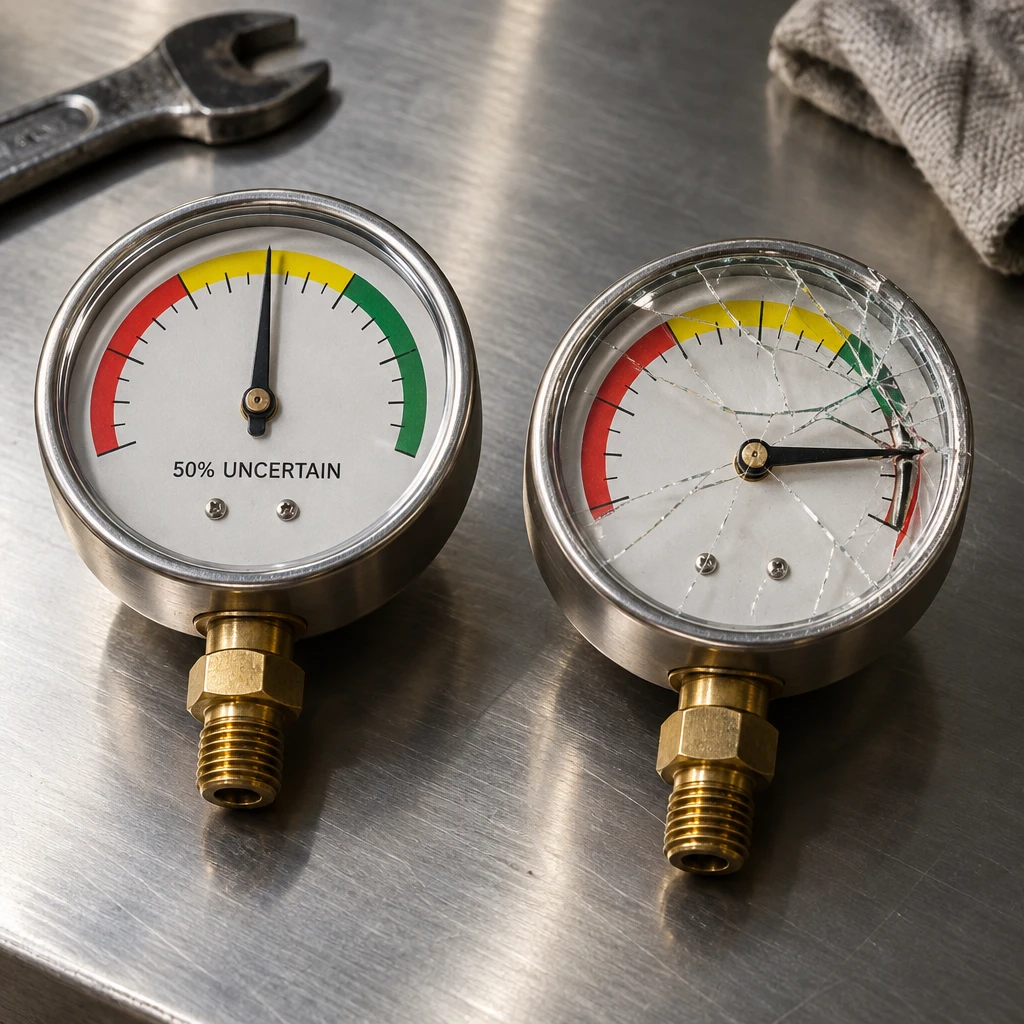
症结出在模型的置信度校准上。一个适合做初筛的模型,不仅要在答对时有把握,更必须在拿不准时诚实给出居中的概率。Jev 犯错的案例大多集中在 50% 置信度附近;而 GPT-6 Luna 哪怕判断错了,也经常给出 90% 到 100% 的极高确信度,在双胞胎、同名父子等高难度测试集上尤其盲目自信。
级联系统里,小模型知道自己不知道,比单纯跑分高更值钱。
这并非偶发现象。独立开发者在另一项 32 并发的商品与书目实体匹配测试中同样发现,Jev 1.13(吞吐量 26.9 对/秒)的概率输出接近良好校准,而通过 Decisions API 调用的 Luna(26.6 对/秒)在中间概率区间系统性地高估了匹配概率。另外在计费结构上,TypeSafe AI 于 2026 年 10 月发布的 Jev 1.14 定价为每百万输入 token 0.042 美元且输出免费,也比按输入 0.10 美元、输出 0.50 美元计费的标准生成式 Luna 更贴合高频打分场景。
正因为 Jev 把拿不准的错题留在了中间地带,Hightouch 只要把 Jev 置信度在 30% 到 90% 之间的样本(简单基准中占 22%)挑出来转给 Claude Opus 5.5 复核,就能把准确率推到 98.8%。反观 Luna,因为错得太自信,系统即使拦截 10% 到 90% 置信度的样本送交 Opus,也只能筛出 6% 的流量,大量高置信度错题直接漏网,混合准确率停在 98.5%。
4 倍省钱效应的缩水:难例击穿路由与真实生产环境的三个盲区
Hightouch 在标题里主打成本降低 4 倍以上,但拆开报告底部的测试明细就会发现,这个账单极其依赖数据干净程度。
4.4 倍的成本降幅(从 3.86 美元降至 0.88 美元)只发生在容易分辨的简单基准上。当测试切换到专门包含关键字段拼写错误、双胞胎、同住同名亲属的高难度基准时,Jev 和 Luna 的单模型准确率双双跌到 89% 左右,足足落后 Claude Opus 5.5(95.1%)约 6 个百分点。更麻烦的是,Jev 在难例上的不确定样本大幅膨胀,导致大量请求穿透初筛涌向昂贵的 Opus。混合方案的准确率虽然保住了 95.3%,但每千个身份的成本飙升到 2.94 美元——对比单用 Opus 的 5.39 美元,成本降幅缩水至 1.8 倍。
对于打算照搬这套架构的数据工程和客户数据平台(CDP)团队来说,把实验室跑分搬进真实生产环境前,还有三个绕不开的工程限制。
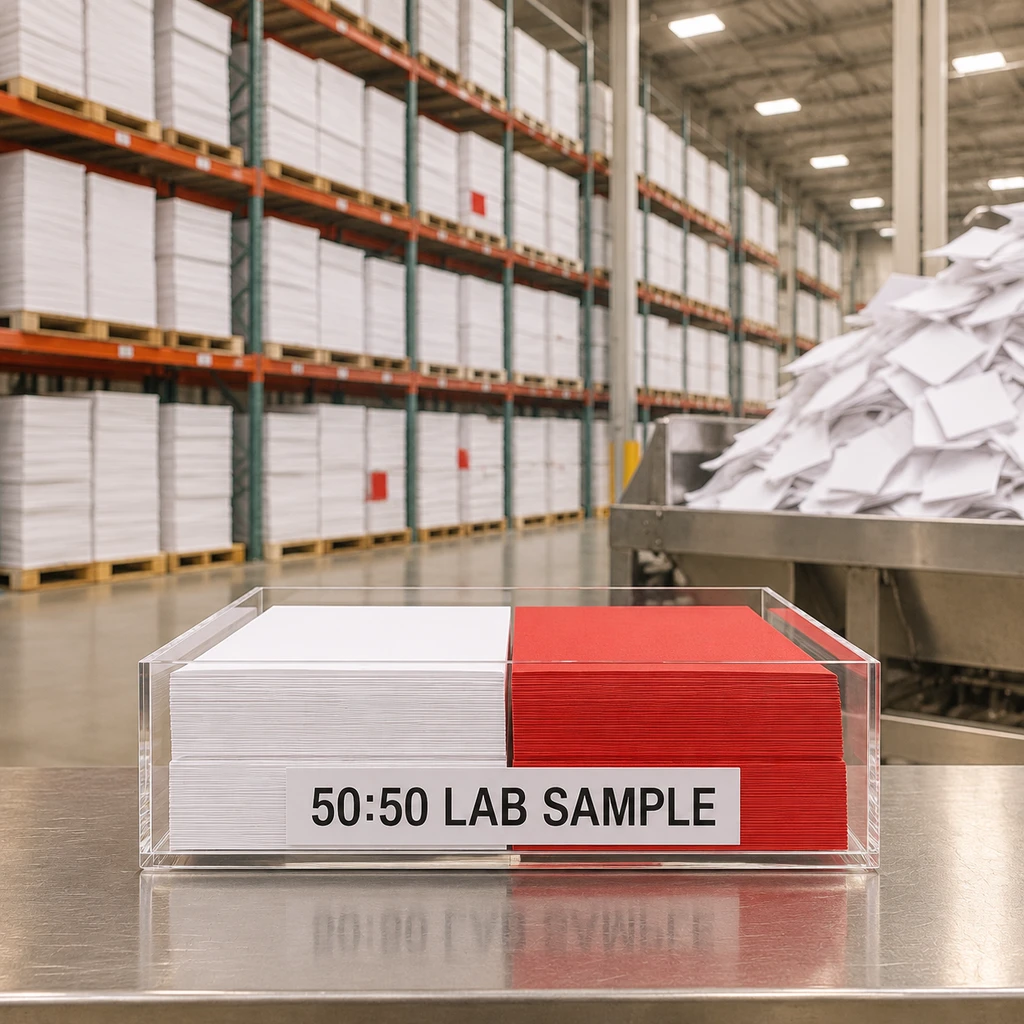
首先,实验使用的是华盛顿大学工具 pseudopeople 生成的 1000 个合成身份,且将正常档案与过度合并档案按 50 比 50 对半切分。但正如 Hightouch 自己在文中所说,健康生产图谱里的过度合并是极低概率的罕见事件。在正负样本极度失衡的真实库里,哪怕模型只有微小的假阳性率(例如 Jev 单独使用时的 22 个假阳性),放进十万级基数里也会捞出成百上千条误报,彻底改变送交大模型二审的流量比例。此外,Hightouch 并未披露 30% 到 90% 这组路由阈值是否在独立的留出集上调优得出,直接套用存在阈值过拟合风险。
更关键的盲区在于评估维度残缺。只靠大模型检查合并后的单个档案袋里混进了几个自然人,只能抓出过度合并,却对身份解析的另一半死穴——合并不足(即同一个自然人的交易记录被散落在多个孤立档案里)完全失明。
- 风险.在真实客户数据库中直接硬编码 30%–90% 的路由阈值,极易因罕见错误分布偏移和脏数据难例激增,导致向昂贵模型转发的账单失控。
对于企业数据团队,眼下最稳妥的落地动作不是全量替换现有规则,而是先在人工标注的真实客户留出集上重测 Jev 1.14 与 GPT-6 Luna 的校准曲线;同时还得盯紧 OpenAI 后续是否会修复 Decisions API 在中间概率区间的盲目自信问题,以及行业如何补齐对漏连错误的低成本审计方案。