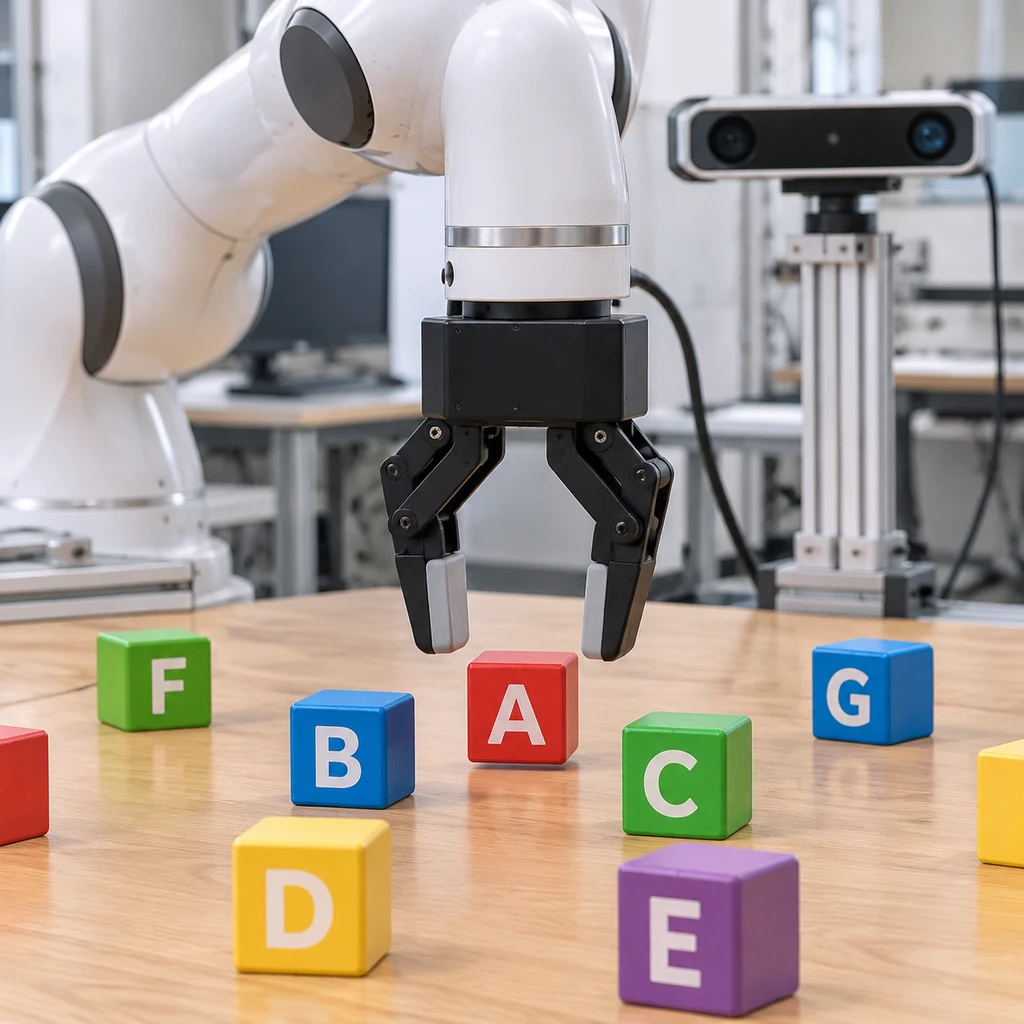
当整个具身智能圈都在比赛让机器人叠衣服、进厨房做百种家务时,AllenAI(Ai2)在 2026 年 11 月 6 日端出了一个反潮流的新框架 FoundationWorlds,并在 Hugging Face 和 GitHub 开源了首个环境 ToyBlocks。它把场景缩减到极致,只有一张桌子、一条机械臂和几块印着字母图案的积木。这套看似倒退的极简设计,意外成了照出通用机器人动作模型真实短板的一面镜子。
1596 小时免遥操作合成管线
ToyBlocks 延续了 MolmoAct 2、MolmoBot 和 MolmoSpaces 的开源路线,目标是在仿真里造一个像生物培养皿一样的受控环境。过去采集机器人数据得靠人工遥操作,慢且贵。ToyBlocks 直接在 NVIDIA Isaac Sim 和 Isaac Lab 底层上搭了一套全自动流水线,用 PDDL 规范定义任务,把符号规划、批处理技能与 cuRobo 运动规划串在一起,单张 GPU 并行跑出最高 24 倍实时速度。
这套管线聪明地把物理执行与渲染解耦,先利用仿真器里的特权信息记录运动轨迹,再重放姿态去批量换光照、材质、相机视角和积木外观,甚至支持把策略失败的状态转化成新的专家演示。
靠着这套引擎,Ai2 放出了 LeRobot v3 格式(25 Hz)的庞大数据集,硬件设定为 Franka FR3 机械臂配 Robotiq 2F-85 夹爪,覆盖 3,600 个互不重叠的 PDDL 问题。数据卡显示里头共有 83,496 个成功回合(训练集 77,496,验证集 6,000),总计 143,676,425 帧、1,596.4 个机器人小时(训练集 1,484.5 小时,验证集 112.0 小时)。
随数据一同开源的是上下解耦的两套模型,外加支持通过 MCP 协议接入 Claude Opus 5.5 等前沿大模型直接用网页自然语言指挥机械臂:
- 高层大脑 Molmo2-4B-tb.约 4.5B 参数,吃一张 640×360 前置相机图和目标文本,训练 6,000 步(batch size 256,掺了 25% 辅助指向数据),负责选技能并用坐标点出目标积木。
- 底层小脑 ManiFlow-tb.322.5M 参数的流匹配策略,配 12 层 DiTX 动作头,输入两个 224×224 视图、机械臂状态、文本和目标热力图,预测 50 步、每次执行 25 步动作块。
大脑看懂了,小脑手还在抖
我最买账的,是 ToyBlocks 把高层推理和底层执行拆开验伤的设计。评估分 Easy(字符正立可见)、Medium(需重新定向)、Hard(字符朝下隐藏,得先翻找再拼写)三档,交叉测试熟悉(seen)与未见(unseen)积木,每组跑 200 个回合;碰歪非目标积木超过 2 厘米或转过 15 度,直接算碰撞失败。
一跑分,视觉语言动作模型(VLA)的底裤就掉了一半。在空间泛化测试里,ManiFlow、π0.5 和 MolmoAct 2 这些经过大规模预训练的明星动作模型,面对训练区外的摆放位置或未见过的堆叠高度,初始表现普遍拉胯。把拼写任务的闭环成绩列出来,落差更刺眼:
| 任务难度与积木条件 | Molmo2 + 传统运动规划器 | Molmo2 + ManiFlow 学习策略 |
|---|---|---|
| Easy(熟悉 / 未见积木) | 97.5% / 81.0% | 55.5% / 44.5% |
| Medium(熟悉 / 未见积木) | 53.5% / 36.5% | 35.5% / 12.5% |
| Hard(熟悉 / 未见积木) | 31.5% / 14.5% | 17.0% / 10.0% |
同一颗 Molmo2 大脑,底下接传统运动规划器时,简单任务能拿 97.5% 的成功率;一旦换成端到端学习的 ManiFlow,成功率直接腰斩到 55.5%,到了最难的未见积木搜索拼写,更是跌剩 10.0%。哪怕直接给 ManiFlow 喂全知视角的 Oracle 高层正确规划,它在 128 个保留测试回合里跑 4 遍,成功率也卡在 54%–59% 上不去。
具身智能眼下卡脖子的真病灶在小脑,大模型看懂了积木,手指却还不听使唤。
在架设前置与腕部 ZED 相机的真机零样本迁移(Sim-to-Real)里,ManiFlow 单一原子技能在仿真和真机上分别拿到了 80.0% 和 81.1% 的成功率;但连成 Molmo2+ManiFlow 完整拼写长链条后,仿真成绩是 55.5%(111/200),真机上挑最简单的已见积木和正立朝向测了 30 把,成功 15 把,刚好 50.0%。
培养皿里的超时玄学与口径打架
但如果只看宣传博文,你会以为 Ai2 造出了一个指哪打哪、精准复现的完美实验室。翻进模型卡、数据卡和底层文档,工程现实的毛边全露出来了。
十八世纪化学家拉瓦锡靠密闭钟罩和天平把炼金术变成定量化学,前提是天平自己不能乱晃。ToyBlocks 想当机器人的密闭培养皿,却被 GPU 物理引擎的非确定性接触仿真摆了一道。文档坦白,受共享物理场景和 batch 构成影响,哪怕锁死随机种子也无法复现一模一样的轨迹。ManiFlow 对同一批 128 个回合连测 4 次,两两之间只有 82–97 个回合结果一致。
更要命的是超时参数。如果按默认的 30 秒超时去跑,那 128 个任务只能过 26–28 个;官方报告里体面的跑分,全靠把参数 --expert-timeout-scale 拉到 3.0(也就是放宽到 194 秒超时上限)才撑起来。
合成管线的洁癖还埋下了幸存者偏差。因为数据集只保留成功演示,困难初始状态的保留率只有 70%–80%(简单开局高达 97%),还有 36.5% 的回合开头带着 1–4 帧 init 标签。把失败重试一刀切掉,意味着模型在单臂三积木的温室里根本学不会抓空或掉积木后怎么补救,仿真也没给相机加上真实噪点、运动模糊和镜头畸变。
连官方自己的账本都没完全对齐。发布博文写生成了 85,336 个长视野演示,数据卡表格加起来却是 83,496 个;博文说真机拼写测了 30 次成功 50.0%,Molmo2 模型卡里又写成测了 10 次成功 60%。此外,主打用强化学习(RL)训练推和翻转技能,但首发开源包里并没塞进完整集成的 RL 训练代码,GitHub 上的技术报告也还挂着 coming soon。
- 风险.外部算法团队拿 ToyBlocks 刷榜对比时,若未严格对齐 194 秒超时倍率与 2 厘米碰撞惩罚,跑分高低将沦为参数设置游戏。
窄场景深挖是对盲目炼丹的纠偏
挑出这些毛刺,并不妨碍我认为 ToyBlocks 走对了一条硬路。
过去两年,RoboCasa 卷家庭场景广度,ManiSkill 卷多构型速度,LIBERO 盯着终身学习,RLBench 塞进百种手作任务,CALVIN 考长序列语言指令。大家都在把盘子铺大,结果模型一挂,谁也说不清是没看清、没想通还是没抓稳。ToyBlocks 退回桌面三块积木,用可随时替换的 Oracle 模块把规划和控制拆开过秤,逼着行业直面那个 10.0% 的残酷数字。
对做 VLA 的研究员来说,近 1,600 小时的干净数据和一个能精准定位病灶的沙盒已经到手;对工业界团队来说,PDDL 加物理渲染分离刷数据的工程路子值得抄作业,但零纠错样本和真机小样本测试也提醒大家别指望纯仿真合成能一步登天。接下来就看两件事,Ai2 什么时候把欠着的 RL 训练管线和正式论文补齐,以及社区在不同显卡上复现这套桌面培养皿时,能不能摁住物理引擎的脾气。