Thinking Machines 在 2026 年 11 月 5 日发布了第二代模型 Inkling 2 Small,采用总参数 594B、激活参数 17B 的稀疏 MoE 架构,支持图像输入与可变推理力度。纸面单价看着很友好,输入 $0.30/百万 tokens、输出 $1.00/百万 tokens,且在 SWEBench Pro v2 (Hard) 拿到 86.3% 的高分。但结合 Artificial Analysis (v5.0.1) 的实测账单看,它跑完单次基准任务的实际综合成本高达 $1.18,平均耗时 20.8 分钟,比同台竞技的 DeepSeek V4.1 Flash 贵了近一倍、慢了 7 分钟以上。
如果你正在为编码 Agent 或自动化研究挑选主力模型,先收起对“17B 激活参数”的便宜预期。Inkling 2 Small 目前仅以闭源权重托管在 Tinker 平台供采样和微调,官方承诺的 Apache 2.0 完整开源权重还得等“下周”外部安全与红队测试走完。在这之前,它最真实的定位是一个靠海量推理 token 换取高难任务突破的重型智能体模型。
低单价是怎么跑出高账单的
大模型厂商现在很喜欢用极低的百万 token 挂牌价招揽开发者,但 Agent 时代的真实成本从来不取决于单价,而取决于模型为了憋出一个正确答案要废多少话。
把 Inkling 2 Small 和当前主流竞品放到 Artificial Analysis (v5.0.1) 的同一套标尺下,账面反差会非常扎眼:
| 模型名称 | 智力指数 | 输入/输出单价 (每百万 tokens) | 输出速度与首字延迟 | 单任务耗时与真实成本 |
|---|---|---|---|---|
| Inkling 2 Small | 31 分 | $0.30 / $1.00 | 120 tokens/s · 35.70 秒 | 20.8 分钟 · $1.18 |
| DeepSeek V4.1 Flash 1017 (Max) | 33 分 | $0.30 / $1.20 | 172 tokens/s · 54.04 秒 | 13.5 分钟 · $0.60 |
| Kimi K3.1 Pro | 46 分 | $2.00 / $10.00 | 34 tokens/s · 169.32 秒 | 35.9 分钟 · $3.68 |
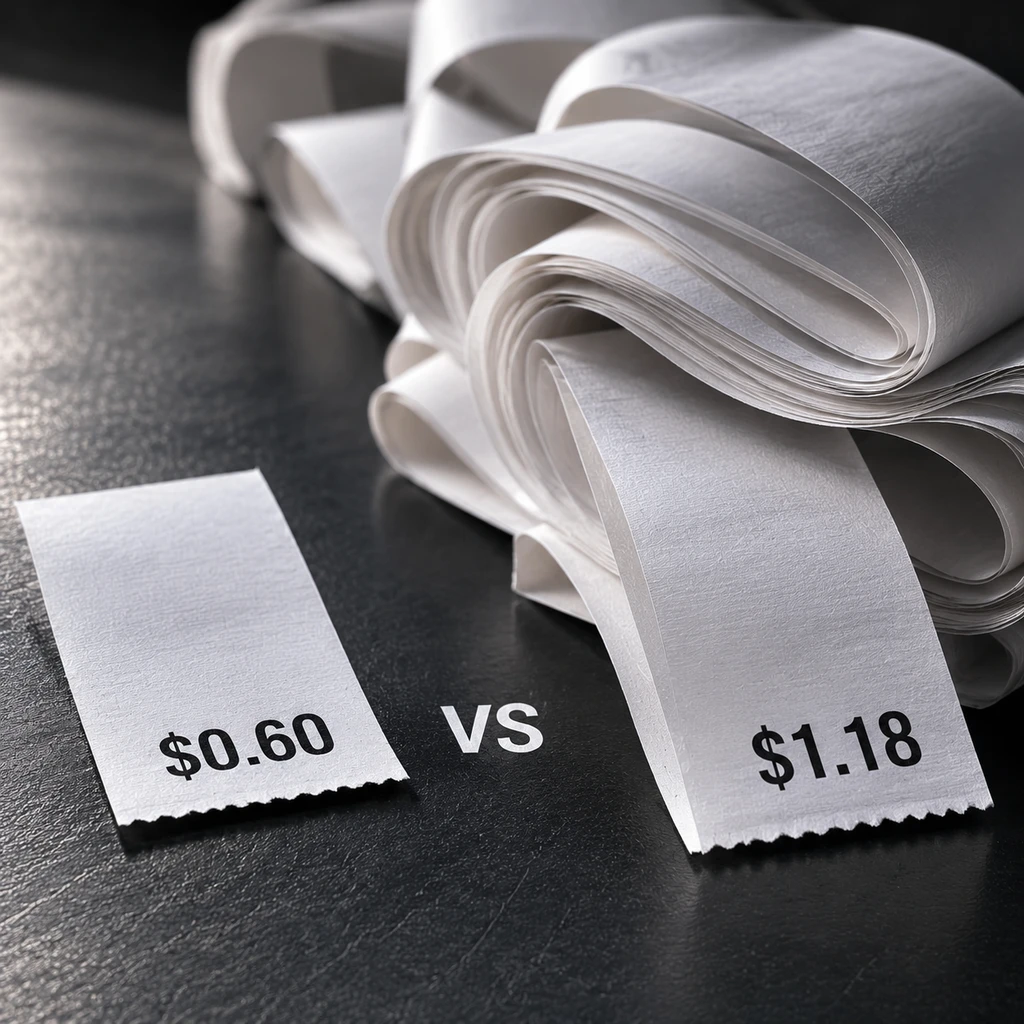
DeepSeek V4.1 Flash 的输出单价($1.20)明明比 Inkling 2 Small($1.00)贵了 20%,智力指数还高出 2 分(33 分 vs 31 分),但跑完单个基准任务的账单只有 $0.60,恰好是 Inkling 2 Small 的一半。原因在于长轨迹推理中的 token 消耗量与缓存效率差异。
单价只是鱼饵,轨迹长度才是账单。
再看官方发布帖里的另一处障眼法。Thinking Machines 在对比表格里拿出来陪跑的是 Kimi K3,但外部平台显示旧版 Kimi K3 (Max) 已被标记为弃用(挂牌价还停留在 $3/$15),旧版 44 分的评分体系也无法与新版 v5.0.1 直接换算;真正代表月之暗面当前最高水准的是拿到 46 分的 Kimi K3.1 Pro。
更重要的是,Inkling 2 Small 在编码榜单上拿到的那些“全场第二”——比如 FrontierCode v2.0 的 25.4%、DeepSWE v1.1 的 72.1% 以及 SWEBench Pro v2 (Hard) 的 86.3%——全部建立在极其奢侈的测试条件之上。官方把推理力度(effort)拉到了 0.99 的极限值,温度设为 1.0,并给足了最高 1M-token 的最大轨迹预算。
《韩非子》里讲“买椟还珠”,现在的 API 采购则是“看秤忘斤”——盯着每百万 token 便宜两毛钱,却忽略了模型在长周期循环里反复试错、上下文压缩与自我验证吞掉的庞大基数。对于高频调用编码 Agent 的团队,如果不限制轨迹上限,月底账单会给你上一课。
- 提醒.若直接按官方 0.99 推理力度和 1M-token 预算在生产环境跑复杂工程,单次任务成本与 20 分钟级的等待延迟会迅速击穿常规 SaaS 应用的毛利边界。
拿钱砸出来的长周期自研能力,到底值在哪
既然算经济账被 DeepSeek V4.1 Flash 压了一头,Inkling 2 Small 为什么还值得硬核工程团队盯紧?答案在于它训练机制的改弦更张,以及在底层算子优化上的长周期耐力。
过去训代码模型,主流做法是看单元测试过没过(ORM)。这种结果导向很容易养出“面向测试用例编程”的投机模型,把代码改得一团糟只要绿灯亮就行。Thinking Machines 这次在数十万个长周期编码任务里,引入了过程级的 Agentic RL 评分器——不仅看代码能不能跑通,还要用智能体裁判去审视模型拆解问题、修改文件和主动验证的步骤合不合理。
这种“管结果也管姿势”的强化学习,直接反映在两类极难的自主研究(Autoresearch)任务上:
- PMPP-Hard GPU 内核优化给模型 69 个底层算子优化任务、4 次独立尝试和 10 小时预算。Inkling 2 Small 的 AUC 达到 494.27(平均解决 54.25/69,Pass@4 达到 64/69),紧咬 DeepSeek V4.1 Flash(497.36)和 Claude Opus 5.5(499.65),甚至直接拿公开的 TileLang 内核去给 DeepSeek-V3.2 的稀疏注意力机制做前向与反向训练加速。
- 端到端自主后训练在 Proximal 构建的内部基准中,给它 12 小时和 500 美元预算去训练一个预测电网负荷与天气的时间序列模型(基于 Qwen3.5-4B)。它自己写评估器、洗数据、试 SFT 和 RL 配方、边跑边修 bug,干了 4.5 小时、花掉 426 美元 Tinker 算力后,把基础模型的预测得分翻了一倍以上。
此外,它挂载了一个基于 Perception Encoder 的 292M 参数视觉编码器(20×20 像素块加 2×2 空间池化),把视觉反馈塞进了编码循环里。模型写完 Three.js 城市模拟器或网页前端后,能自己“看一眼”渲染画面对不对,再动手改代码;在 DesignArena 网页榜单上,它已经成为准开源模型里的第一名,甚至在 20 次盲品红酒照片测试里靠观察酒液挂杯和边缘色泽猜对了 19 次。
潜行测试的真相与“下周开源”的缓冲期
为了证明模型不只是应试机器,官方特意提到曾用代号 Fledge-Alpha 在 OpenCode 社区做过真实世界测试。但如果顺着时间线去翻外部记录,你会发现“社区口碑背书”和“最终可复现性能”之间还隔着一层纱。
独立开发者 Fellipe Soares 曾在 2026 年 10 月 2 日至 4 日用 OpenCode 1.18.33 实测过这个神秘的 Fledge-Alpha:当时它在 SWE-bench Verified Mini 上拿到 15/20(75%),Terminal-Bench 2.1 拿到 11/14(约 79%),但在 SciCode 的 20 题子集里只完整做对了 4 道题(步骤完成率 52%)。到了 10 月 8 日,OpenCode 就合并 PR 移除了文档里的 fledge-alpha-free。
这里有两个容易被忽略的细节。首先,Fledge-Alpha 只是 10 月初的早期检查点,不等同于 11 月 5 日发布的最终版;其次,当时的独立评测虽然公开了随机种子(20261002)和 Harbor 0.23.0 工具链,但并没有放出完整的子集清单与原始轨迹包,且测试横跨不同硬件并允许重跑卡死试验。拿一个月前无法完全复现的小样本测试当定心丸,在工程选型上是草率的。
这也解释了为什么大家都在等“下周”的那临门一脚。Thinking Machines 走的是“先在自家 Tinker 平台闭源变现并收集数据,等外部安全与红队测试过关后再放 Apache 2.0 权重”的缓冲路线。
594B 的总参数量意味着哪怕激活参数只有 17B,本地部署的显存容量门槛依然极高,普通开发者根本跑不起来;但对有集群的算力团队和企业来说,一旦 Apache 2.0 权重如期落地,他们就能绕开官方平台 $1.18/任务的账单,自己用量化和推理引擎去压榨这 17B 激活参数的低延迟潜力。
不用急着在 Tinker 上为高昂的 1M-token 轨迹买单。真正决定 Inkling 2 Small 行业身位的变量,是 11 月中旬完整权重放出后,社区在常规 token 预算和中等推理力度下,究竟能复现出多少它吹嘘的编码与算子优化功力。