AMD 已把部分由 OpenAI 模型提出的电路改动放进送制造的设计。OpenAI 称,双方用不到五个月,在 AMD 工程师已打磨多年的旗舰 GPU IP 上,取得最高约 14% 的块级 PPA 改善。我更看重 AMD 愿意采用其中一部分。能进制造版本,说明模型已经找到了工程团队愿意为之投入验证和集成人力的改法。峰值能否在硅片上兑现,还得等实测。
The Decoder 对这笔成绩的报道沿用 OpenAI 的披露。同期 Anthropic 的路演材料给了 AMD 另一组数字。Anthropic 称,模型约用三天就在 MI355X 上跑通了推理的预填充阶段。前一件事关系到芯片设计团队能多试多少种电路,后一件事关系到算力采购团队能以多低的成本把另一种卡纳入评估。
14% 要看约束,送制造要等回片
模型改写的是 SystemVerilog RTL,也就是描述硬件行为的代码。相同的功能换一种写法,综合工具可能生成不同的电路。团队用 Synopsys 工具检查功能是否等价,再评估功耗、性能和面积,也就是 PPA。
PPA 没有统一的总分。固定频率测省电幅度,和固定功耗测频率上限,算的是两笔账。OpenAI 没有公开具体 GPU、工艺节点、完整的模块范围,也没给出 14% 对应的分项指标和约束。到了真实负载里,整卡还可能卡在显存带宽或散热上,局部电路的收益能传导多少,要看瓶颈在哪。
部分 GPU 改动已经随设计送制造,另一些写入了未来版本的生产设计文件。OpenAI 还披露,AMD 下一代旗舰 CPU 的关键模块取得个位数百分比的 PPA 提升。GPU 项目的详细签核数据和回片实测仍未公开。
OpenAI 自研的推理芯片 Jalapeño 已经走到了硅片启动验证。按团队估算,模型提出的流水线调整和电路复用,让向量单元和矩阵单元的标准单元面积分别减少约 13% 和 10%。这两个数字有明确的面积口径,范围也只到对应单元。
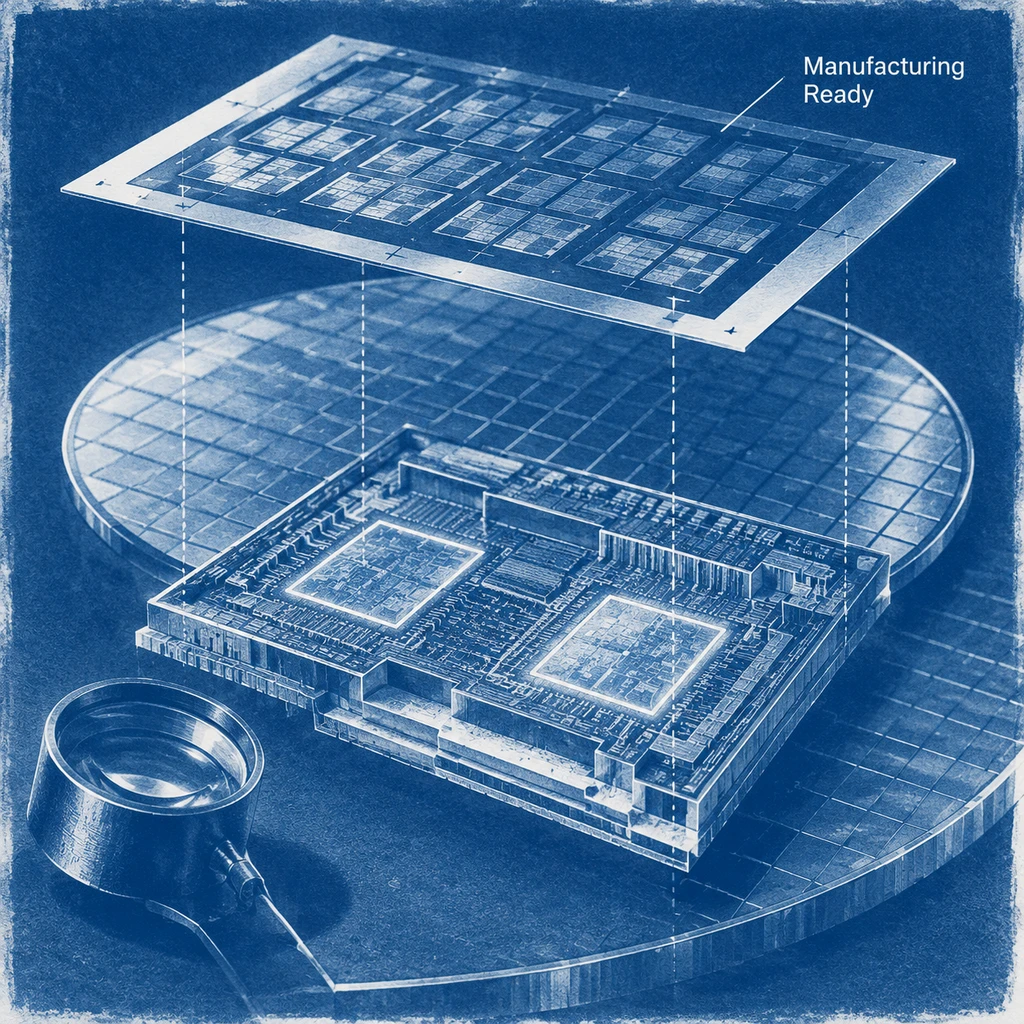
<svg viewBox='0 0 680 284' width='100%' height='284' role='img' aria-label='三个项目的验证阶段'><rect x='1' y='1' width='678' height='282' rx='8' fill='#fbf9f4' stroke='#e2dccf'/><text x='30' y='37' fill='#b25a3a' font-size='20' font-weight='700'>三个项目验到了哪一步</text><line x1='30' y1='52' x2='650' y2='52' stroke='#e2dccf'/>
<rect x='30' y='72' width='620' height='52' rx='5' fill='#fbf9f4' stroke='#e2dccf'/><rect x='30' y='72' width='5' height='52' fill='#b25a3a'/><text x='52' y='104' fill='#2c2822' font-size='17' font-weight='700'>Jalapeño</text><text x='260' y='104' fill='#2c2822' font-size='17'>硅片启动验证</text>
<rect x='30' y='137' width='620' height='52' rx='5' fill='#fbf9f4' stroke='#e2dccf'/><rect x='30' y='137' width='5' height='52' fill='#b25a3a'/><text x='52' y='169' fill='#2c2822' font-size='17' font-weight='700'>AMD设计</text><text x='260' y='169' fill='#2c2822' font-size='17'>部分改动送制造</text>
<rect x='30' y='202' width='620' height='52' rx='5' fill='#fbf9f4' stroke='#e2dccf'/><rect x='30' y='202' width='5' height='52' fill='#b25a3a'/><text x='52' y='234' fill='#2c2822' font-size='17' font-weight='700'>RISC-V</text><text x='260' y='234' fill='#2c2822' font-size='17'>仿真与频率估算</text></svg>
三天跑通预填充,采购多了一个选项
按 Anthropic 的说法,Mythos Preview 编写或移植了近乎全部所需算子,约三天让一个模型在 AMD MI355X 上以可用性能处理输入提示词。这就是预填充。六至十二个月是 Anthropic 对传统做法的历史估计,材料没有给出同任务的工期对照,也没有给出逐步生成输出时的解码吞吐量,或同口径的 NVIDIA 测试。
我更看重这三天降低了多少试卡成本。过去一套推理软件要是移植起来太贵,采购团队可能连报价都懒得细谈。现在能更快跑起来,就能拿自己的负载做评估。要把试卡变成订单,还得在同样的负载和延迟目标下,把解码、多机扩展和长期运维算进去。NVIDIA 要面对的竞争,先从客户更容易测另一种卡开始。
不到五个月,工程师究竟省了多少工时
OpenAI 把 AMD 项目的进度折算成约一年的工程量。公开材料没有同任务、同资源的对照,也没给出工程师投入和迭代次数。五个月是项目经历的时间。要算省了多少人工,还得知道多少候选通过等价检查,有多少能在布局布线后保住收益,以及被淘汰的方案占了多少工具时间。
开源 RISC-V 测试正好说明为什么要看通过率。在相同的约 112,000 token 预算下,GPT-6.2 Astra 在 PicoRV32 的 RTL 优化任务中,平均分约为 GPT-6 Astra 的两倍。仿真失败或面积超过原核心 16 倍的候选会记零分,其余候选按测试负载的每时钟指令数和工具估算频率计分。平均分可以靠更多方案通过校验拉高,也可以靠通过的方案跑得更快。这个差别会直接影响团队接手后还要审多少代码、跑多少轮工具。
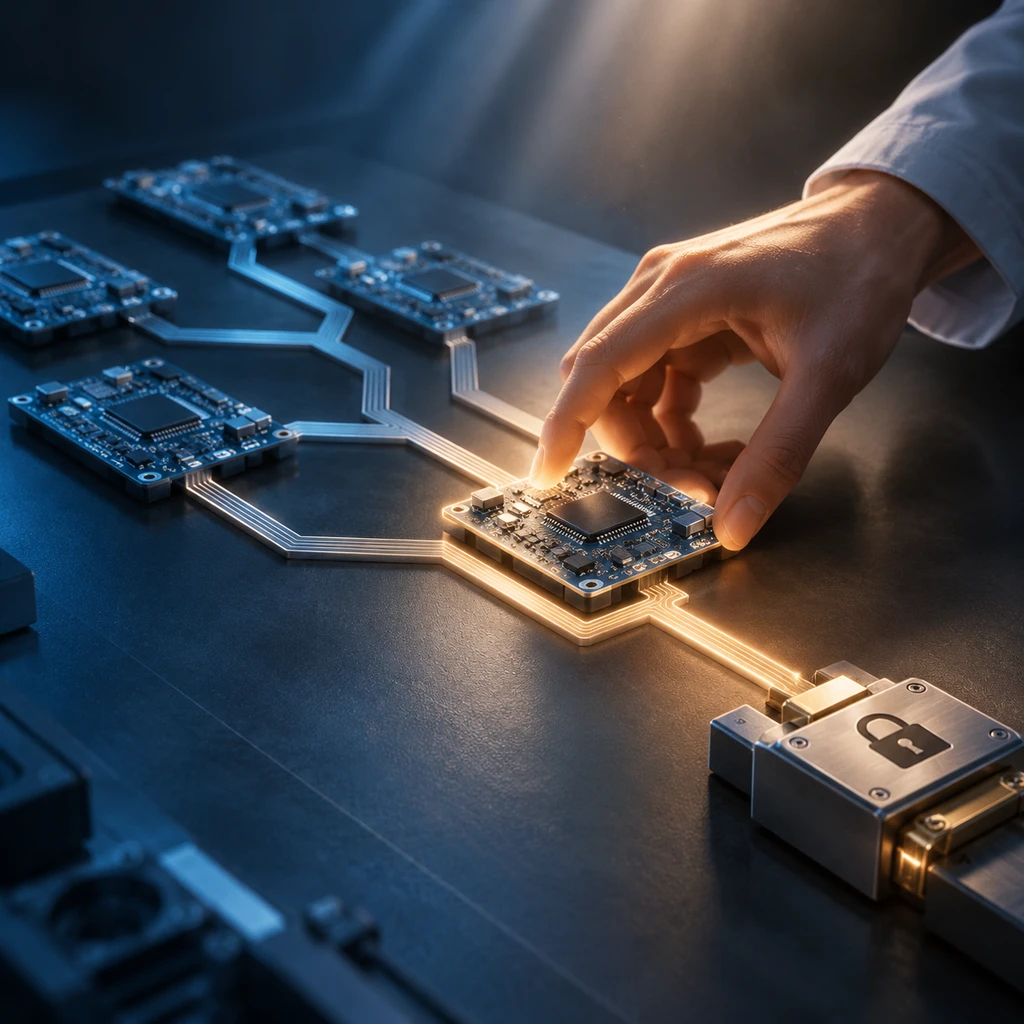
<svg viewBox='0 0 680 190' width='100%' height='190' role='img' aria-label='模型提案、EDA筛选和工程师签核流程'><rect x='1' y='1' width='678' height='188' rx='8' fill='#fbf9f4' stroke='#e2dccf'/><text x='30' y='37' fill='#b25a3a' font-size='20' font-weight='700'>候选方案如何进入生产设计</text><line x1='30' y1='52' x2='650' y2='52' stroke='#e2dccf'/>
<rect x='30' y='76' width='180' height='82' rx='5' fill='#fbf9f4' stroke='#e2dccf'/><rect x='250' y='76' width='180' height='82' rx='5' fill='#fbf9f4' stroke='#e2dccf'/><rect x='470' y='76' width='180' height='82' rx='5' fill='#fbf9f4' stroke='#b25a3a'/>
<line x1='218' y1='117' x2='236' y2='117' stroke='#7a7266'/><polygon points='236,112 244,117 236,122' fill='#7a7266'/><line x1='438' y1='117' x2='456' y2='117' stroke='#7a7266'/><polygon points='456,112 464,117 456,122' fill='#7a7266'/>
<text x='120' y='110' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>模型提出改法</text><text x='120' y='134' text-anchor='middle' fill='#7a7266' font-size='13'>探索电路方案</text><text x='340' y='110' text-anchor='middle' fill='#2c2822' font-size='17' font-weight='700'>EDA工具筛选</text><text x='340' y='134' text-anchor='middle' fill='#7a7266' font-size='13'>校验功能与指标</text><text x='560' y='110' text-anchor='middle' fill='#b25a3a' font-size='17' font-weight='700'>工程师签核</text><text x='560' y='134' text-anchor='middle' fill='#7a7266' font-size='13'>决定是否采用</text></svg>
逻辑综合普及后,工程师可以少画很多门电路,仍要检查生成的电路能否满足时序。现在自动化又往前挪了一步,连 RTL 的写法也可以交给模型批量尝试。OpenAI 和 Synopsys 计划用 GPT-Synopsys 把工具调用和结果解读接进这一步。它值不值预算,取决于模型能不能更早筛掉会在后段返工的方案,而非单纯增加提交量。
AMD 回片后,同约束下的分项 PPA 和代表性负载实测,可以检验那笔局部收益。设计负责人还需要一张普通模块的工时表,把筛选、集成、跑工具、返工和签核都计进去。能送制造,已经值得给模型下一批模块试。能把交付日期往前挪,才值得改排期。