2026 年 11 月 18 日,Google 发布 Gemini 4 Neon,主打反复出现的复杂工程、知识工作和科研任务。同一项 SWE-sweep 代码评测,Neon 搭配 Google 自家的 Antigravity 拿到 39.0%,放进共享的 mini-SWE 框架只得 12.8%。同一个模型,两套配置,差了 26.2 个百分点。
Google 的发布资料给这组分差补上了两条细节。Antigravity 的 Orchestrator 模式可以让 Neon 做规划、由 Hydrogen 做实现。Antigravity 文档则给 Neon 标了 512K token 的上下文上限,低于 API 的 100 万 token。Neon 已开始向 Gemini API 付费层、Gemini for business、Antigravity 和 Gemini 应用的 Pro、Ultra 用户开放。API 每百万 token 的普通输入、缓存输入和输出分别收 3 美元、0.15 美元和 15 美元。
39.0% 能支持试用整套工具
Antigravity 可以编排并行的 Hydrogen 子代理,符合条件的计划还提供四档思考级别,默认 High。代理框架也会改变工具调用和上下文管理。两组跑分没有逐项控制这些变量,目前还看不出分工、并行和推理设置各贡献了多少。
<svg viewBox='0 0 560 252' width='100%' height='252' role='img' aria-label='同一模型在两套代码代理框架中的评测成绩'>
<rect x='1' y='1' width='558' height='250' rx='12' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='41' font-size='20' font-weight='700' fill='#b25a3a'>同模型,两种成绩</text>
<line x1='28' y1='57' x2='532' y2='57' stroke='#e2dccf' stroke-width='1'/>
<rect x='28' y='78' width='242' height='109' rx='8' fill='#f6eee7' stroke='#e2dccf'/>
<rect x='290' y='78' width='242' height='109' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='149' y='110' text-anchor='middle' font-size='14' fill='#2c2822'>谷歌自有框架</text>
<text x='411' y='110' text-anchor='middle' font-size='14' fill='#2c2822'>共享代理框架</text>
<text x='149' y='159' text-anchor='middle' font-size='38' font-weight='700' fill='#b25a3a'>39.0%</text>
<text x='411' y='159' text-anchor='middle' font-size='38' font-weight='700' fill='#2c2822'>12.8%</text>
<text x='28' y='221' font-size='13' fill='#7a7266'>同项代码评测</text>
<text x='532' y='221' text-anchor='end' font-size='13' fill='#7a7266'>差距尚未归因</text>
</svg>
Google 发布时引用的 Artificial Analysis Coding Agent Index 把 Neon 列为第一,Arena 后续的独立代码代理榜单快照把它列为第五。两张榜缺少共同基准,无法据此判断 Neon 的表现是否下滑。已经有代码代理的团队,真正缺的那组跑分得在自己的框架里补出来。mini-SWE 至少提醒你,工具一换,结果可以差很远。
大仓库得按实际入口试跑
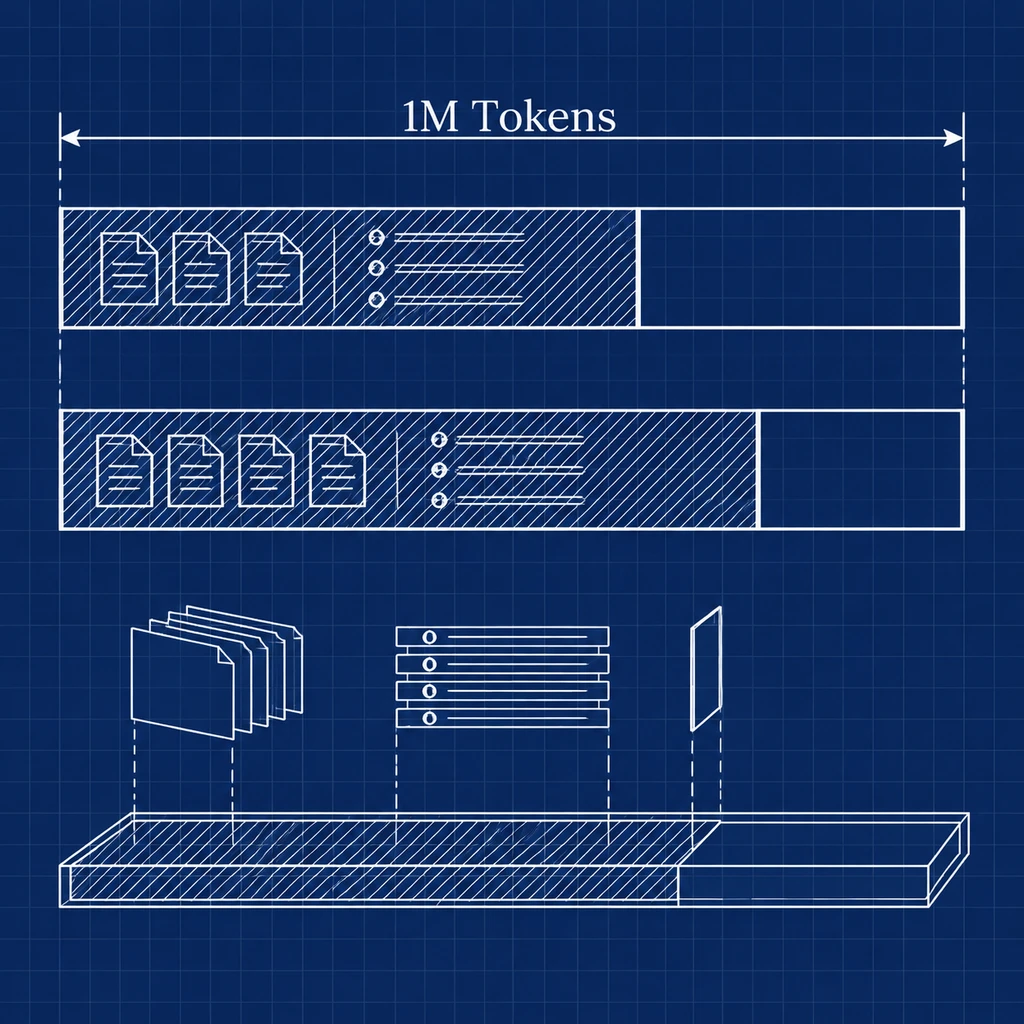
API 的 100 万 token 由输入和输出共用。DeepMind 模型卡还把默认同步输出单独限制在 64K token。后台长解码模式可以输出更多,但仍受总窗口约束。到了 Antigravity,团队要按文档列出的 512K 上限试跑,看看拆开仓库和设计文档之后,代理还能不能找到跨文件依赖。
Neon 的价格确实有竞争力。Vals Index v2.2 里,Neon 平均每项任务花 7.40 美元,Claude Fable 5.2 花 17.94 美元,Neon 只低 0.44 个百分点。但缓存折扣只覆盖重复输入。碰上反复改写、重跑或需要人把拆开的材料重新拼起来的工单,输出费和工时照付。我更愿意拿这组价格做试点预算,等同一批任务验收完再估全年能省多少。
复核和权限决定省下多少工
Google 称 Neon 在 Antigravity 内部测试中的幻觉率创下新低,没公布具体比例。按 Artificial Analysis 的 AA-Omniscience v1.1 数据推算,Neon 在 xhigh 档为 14.4%,High 档为 13.9%。这两个数字的分母是未完全答对的回答,部分正确和拒答都算在内。企业要估财税报告或跨表分析的复核工时,还得数自己的材料里有几处事实需要改。
权限也是评测配置的一部分。Gray Swan 的间接提示注入评测录得 0.0% 攻击成功率,对应的是开启防护并使用 xhigh 档的配置。团队要让代理读取内部文件或执行代码,试点就得用准备上线的权限和防护设置,否则记录下来的人工接管次数很难用于排班。
我会拿同一批旧工单跑两轮。第一轮保留现有工具和权限,只换 Neon。第二轮用准备部署的 Antigravity,按同一套标准验收。两轮都记失败后能否续跑、人工改了几处、复核花了多久。要是只有第二轮省工,采购就有了一道具体的门槛:把每月省下的验收工时折成钱,看能不能覆盖订阅、迁移和权限审批。