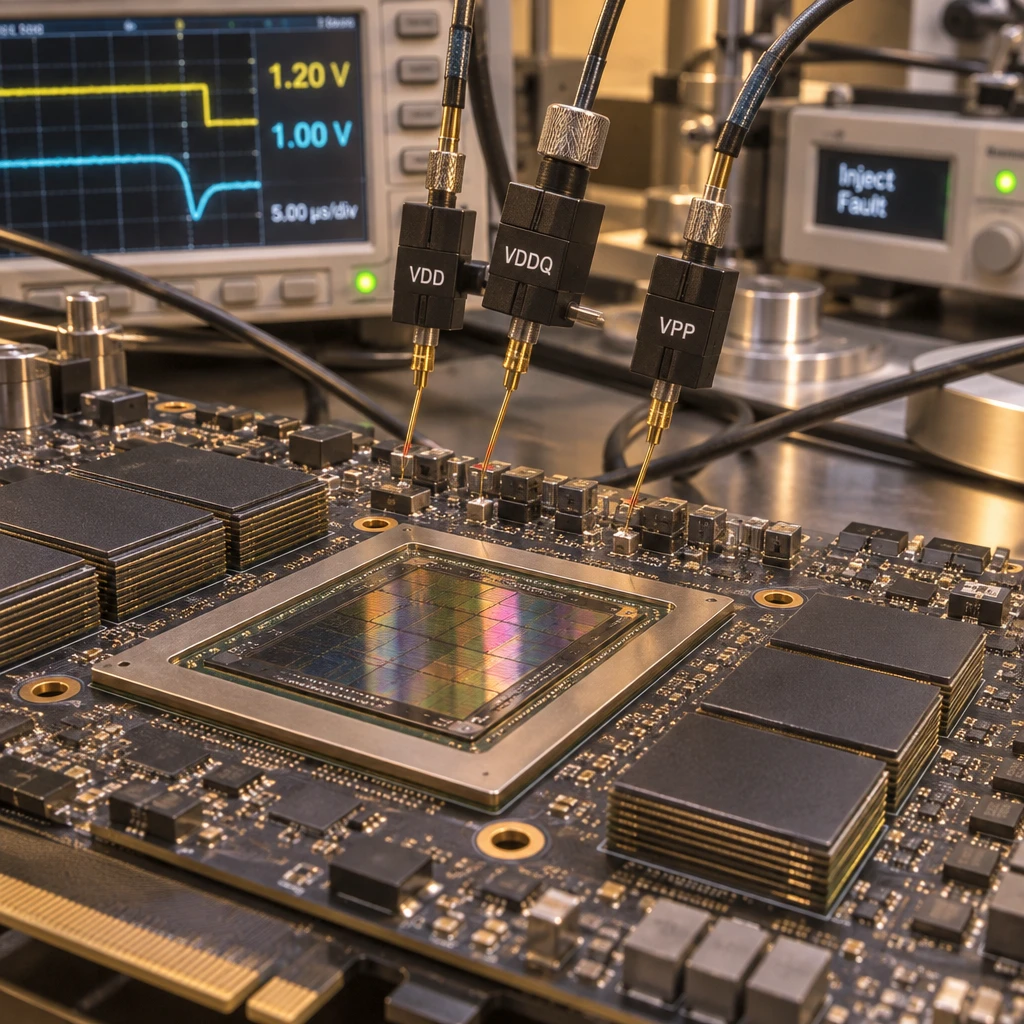
一张在加密货币退潮后遗留的 NVIDIA CMP 170HX 8GB 矿卡,通过物理层面的电压故障注入(VFI),被硬生生改造成了识别出 81,920 MiB 显存的等效 A100-80G 计算卡。安全研究员利用 GA100 芯片底层熔丝控制器的设计逻辑,烧断特定物理熔丝(eFuse),不仅解锁了被屏蔽的显存、PCIe Gen4、NVLink、MIG(多实例 GPU)及 NVJPG/NVDEC 编解码单元,还开启了多达 124 个流式多处理器(SM),使其 OpenCL FP16 算力达到零售版 A100 的 1.18 倍。这并非普通玩家刷写 BIOS 的软件戏法,而是首次从硅片硬件底层刺穿了 NVIDIA 维持高溢价产品线分级的商业防线;但对盯着二手算力市场的买家来说,盲目跟风囤卡极易掉进显存容量盲盒与核心良率隐患的双重陷阱。
越烧熔丝权限越大,电压毛刺刺穿 GA100 芯片分级刀法
半导体行业长期奉行同一晶圆生产、后期熔丝屏蔽的商业策略。NVIDIA 旗舰数据中心芯片 GA100 衍生出了近 20 个不同规格的产品,上至数万美元的 A100,下至专供以太坊挖矿的 CMP 170HX,本质上都是同一块硅片在出厂前通过电子熔丝(eFuse)进行良率管理与功能阉割的产物。
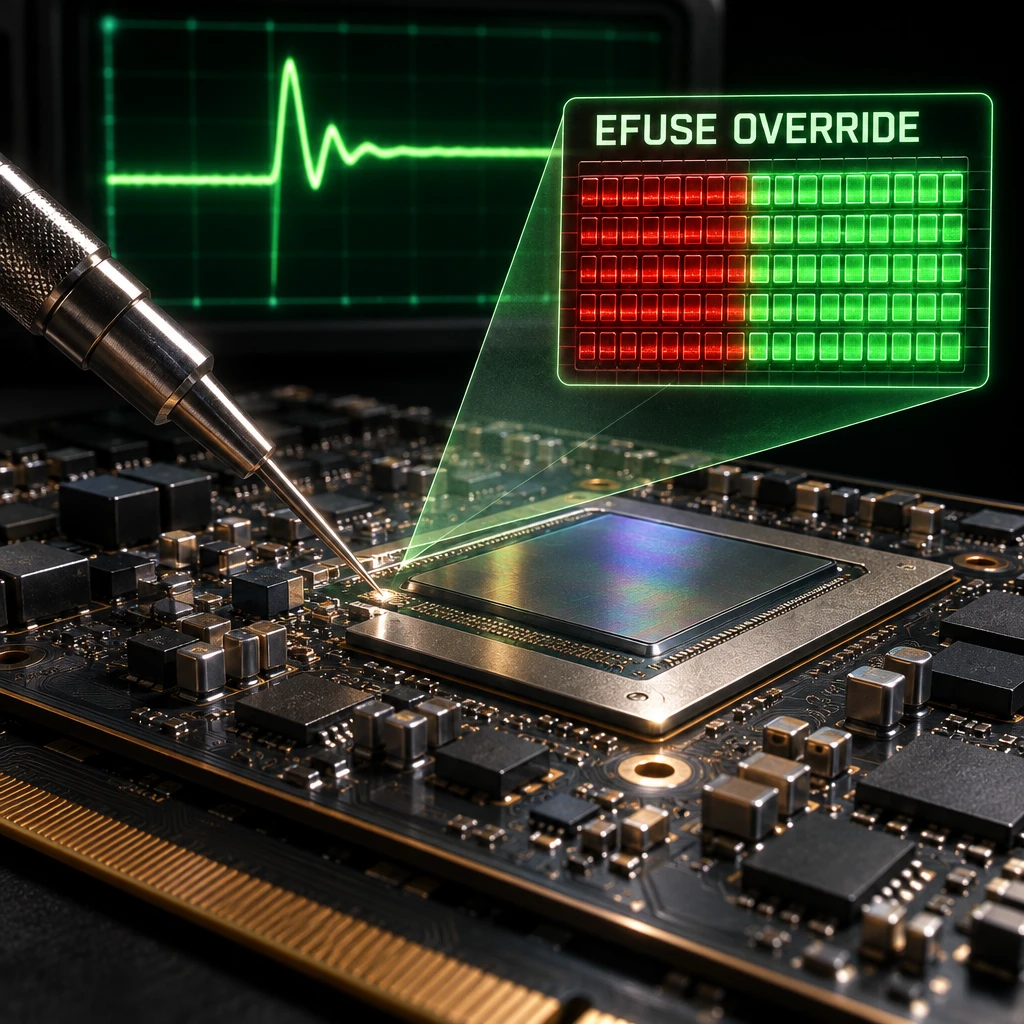
按照硬件安全领域的常识,物理熔丝一旦烧断(状态由 0 变为 1)便不可逆转,因此每一次熔断操作都应当单向收紧权限。然而 GA100 芯片内置的 16,384 个 eFuse(分为 512 行,每行 32 位)却打破了这一铁律。
为了避免工程师在测试样品时因误烧常规熔丝而报废昂贵的芯片,NVIDIA 在第 222 至 487 行设计了一套独特的无熔丝覆盖机制(Fuseless fuses)。这套机制如同一串可追加写入的脚本链,芯片启动时会按顺序回放记录;如果后写入的熔丝记录与早期记录指向同一个功能块,后写入的数据将直接覆盖旧有设置。
这种覆盖机制埋下了逆向提权的隐患。只要攻击者利用电压故障注入(VFI)在芯片读取第 0 行和第 1 行控制熔丝时制造瞬间电压毛刺,就能绕过禁止二次烧写的硬件保护锁,在空白行中烧入将各项禁用标志(_DISABLE)清零的新指令,从而把被原厂封印的硬件模块重新唤醒。
把不可逆的物理熔丝设计成可覆盖的脚本,等于给硬件锁留了后门。
研究员已在发布前将该漏洞提交给 NVIDIA 产品安全团队并开源了部分工具代码(ga100vfi),目前 NVIDIA 官方尚未对此发表公开声明或安全评估。
算力反超 1.18 倍背后的口径差异与硅片盲盒
在开源的测试数据中,最抓人眼球的是这台硬改矿卡在 OpenCL 基准测试下跑出了 85.858 TFLOP/s 的 FP16 FMA 吞吐量,达到了零售版 A100(72.488 TFLOP/s)的 1.18 倍,且实测合并写入显存带宽高达 2,137.93 GB/s(作为参照,官方 A100 80GB PCIe 版与 SXM 版的标准显存带宽分别为 1,935 GB/s 与 2,039 GB/s,功耗上限分别为 300W 与 400W)。
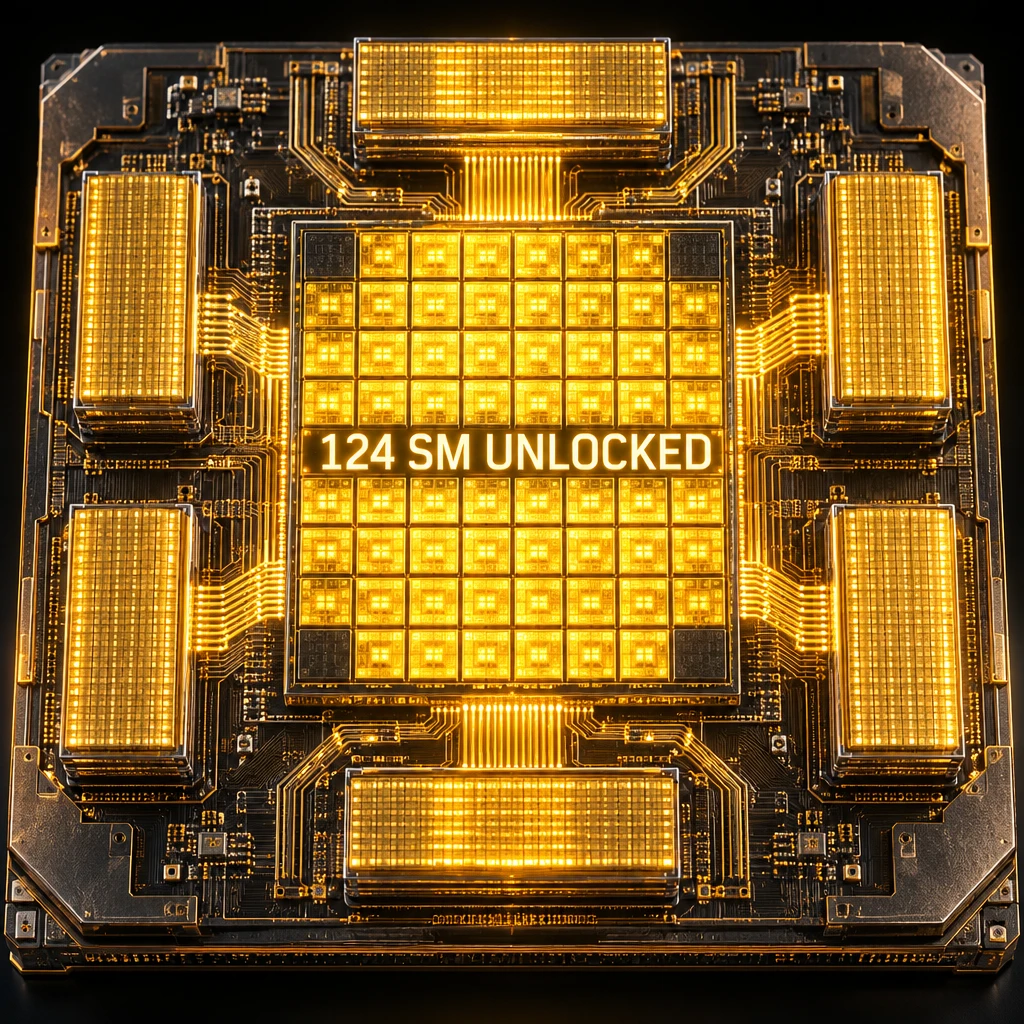
这一反常超越源于晶圆良率的刀法差异。完整的 GA100 核心物理上拥有 128 个 SM(含 8,192 个 FP32 核心、512 个 Tensor Core)、6,144-bit 显存位宽及 6 个 HBM 堆栈接口;为了保住整体良率,所有零售版 A100 均被保守地统一锁定在 108 个 SM(6,912 个 FP32 核心、432 个 Tensor Core)和 5 个 HBM 堆栈。而研究员将手头这张 CMP 170HX 强行开启到了 124 个 SM(7,936 个核心),远超原厂矿卡默认的 70 个 SM(4,480 个 FP32 核心、280 个 Tensor Core),也突破了此前社区单纯靠软件/固件修改最高只能解锁到 74 个 SM 的上限。
| 硬件版本 | 启用 SM 数量 | 可用显存容量 | PCIe 与互联状态 |
|---|---|---|---|
| 原厂 CMP 170HX 8GB | 70 SM | 8 GB | PCIe Gen1 / 无 NVLink |
| 社区软件解锁版 | 70-74 SM | 32 GB 或 64 GB | PCIe Gen2 / 无 NVLink |
| VFI 硬改解锁版(测试卡) | 120-126 SM(实测 124) | 64-80 GB(实测 80 GB) | PCIe Gen4 / 支持 NVLink |
| 零售版 A100 80GB | 108 SM | 80 GB | PCIe Gen4 / 支持 NVLink |
但若因此认为廉价矿卡已经能超越甚至完美平替 A100,就落入了测试口径的障眼法。原文展示的 85.858 TFLOP/s 仅代表 OpenCL 下的常规半精度浮点(FP16 FMA)运算能力;而在现代大模型训练与推理真正依赖的 FP16 Tensor Core 密集算力上,零售版 A100 80GB 的官方峰值高达 312 TFLOPS。在社区此前的密集型 FP16 Tensor 微基准测试中,原厂受限的 CMP 170HX 算力被压制在约 6.3 TFLOPS,通过软件解除功耗与频率限制后可恢复至约 193 TFLOPS(70 个 SM 在 1,410 MHz 下的理论峰值为 202.1 TFLOPS,74 个 SM 为 213.7 TFLOPS)。此次 VFI 硬改方案尚未公布任何 Tensor Core 实测数据。
更现实的阻碍在于二手矿卡的物理硬件盲盒。原文作者乐观地估计 8GB 版与 10GB 版 CMP 170HX 板上分别封装了约 80GB 和 40GB 的 HBM 显存,但硬件社区大量拆解与实测证实,许多流向市场的 8GB 版 CMP 170HX 物理上仅激活了 4 个 HBM 堆栈(4,096-bit 位宽):其中双 Rank 版本最高只能解锁出 64GB 显存,单 Rank 版本更是停留在 32GB。
算力黑市的蠢动与芯片巨头的硬件攻防战
这项研究的公开,直接拨动了二手算力改造产业链与本地大模型(LocalLLM)极客群体的神经。在 AI 算力依然紧俏的当下,如果能用极低成本将废弃矿卡改造为具备 80GB 大显存、超 2,100 GB/s 带宽且支持 NVLink 互联的计算卡,华强北等硬件改造市场势必会迎来新一轮针对 CMP 170HX 的扫货与炒作。
然而对于真正需要跑长周期训练或部署本地推理的草根买家而言,现在掏钱接盘无异于一场高风险赌博。截至目前,社区尚无任何针对该电压毛刺熔断 eFuse 方法的第三方独立复现验证,全部结论仅停留在这份单方报告中。
- 风险.强行开启被 NVIDIA 出厂屏蔽的 120 个以上 SM 单元,等于把原本因体质瑕疵或未通过严苛测试而被废弃的边缘电路重新接入计算阵列,在大模型高负载下极易引发计算静默错误(SDC)或系统崩溃。
从更宏观的行业视角看,这次破解撕开了芯片巨头高利润商业模式的一道口子。无论是 GA100 还是后续的 Hopper、Blackwell 架构,芯片厂商都极度依赖底层 eFuse 与片上安全协处理器来维持消费级、专业级与数据中心级产品之间数倍乃至数十倍的溢价鸿沟。当物理故障注入攻击证明“单靠烧熔丝锁功能”可以被逆向覆盖,NVIDIA 硬件安全团队在后续芯片架构中必然要彻底重构熔丝控制器的状态机逻辑,把硬件级权限锁死在真正不可逆的物理单行道上。