Anthropic 的旗舰安全项目 Project Glasswing 运行满 7 个月,交出了一份极其拧巴的账单。截至 11 月 2 日,官方披露账本攒下了 37,966 项候选发现,但安全机构 VulnCheck 追踪到的已修复漏洞只有 217 项。算力把挖漏洞推成了工业流水线,而人类安全团队的核验产能已经彻底堵死。
看近两个月的增量,这种失衡更刺眼。从 9 月 8 日到 11 月 2 日,Anthropic 账本新入库 11,813 项发现,同期新增修复却只有区区 15 项;反倒是重复报告从 2 项暴增到 1,600 多项,撤回报告也升至 419 项。更魔幻的是,在撤回与重复加起来超过 2,000 项的背景下,Anthropic 账本宣称的真阳性率反而从 5 月上线时的 90.8% 涨到了 94.2%。
| 统计维度 | 9月8日数据 | 11月2日数据 | 两个月变化 |
|---|---|---|---|
| 候选发现总数 | 26,153 | 37,966 | +11,813 |
| 哈希账本公开数 | 2,736 | 7,349 | +4,613 |
| 账本标记已修复 | 202 | 217 | +15 |
| 撤回报告数 | 245 | 419 | +174 |
| 重复报告数 | 2 | 1,670 | +1,668 |
| 官方宣称真阳性率 | 91.4% | 94.2% | +2.8个百分点 |
3.8 万个发现的文字游戏与漏斗堰塞湖
单看 VulnCheck 的追踪报告,很容易得出 Anthropic 用垃圾报告刷数据的结论。今年全球共发布了 93,450 个 CVE 编号,归因于 Anthropic 的只有 442 个,占比约 0.5%,其中真正被黑客在野利用的更是只有 2 个(CVE-2026-61500 和 CVE-2026-26980)。但要把这笔账算清楚,得先拆开双方统计口径的错位。
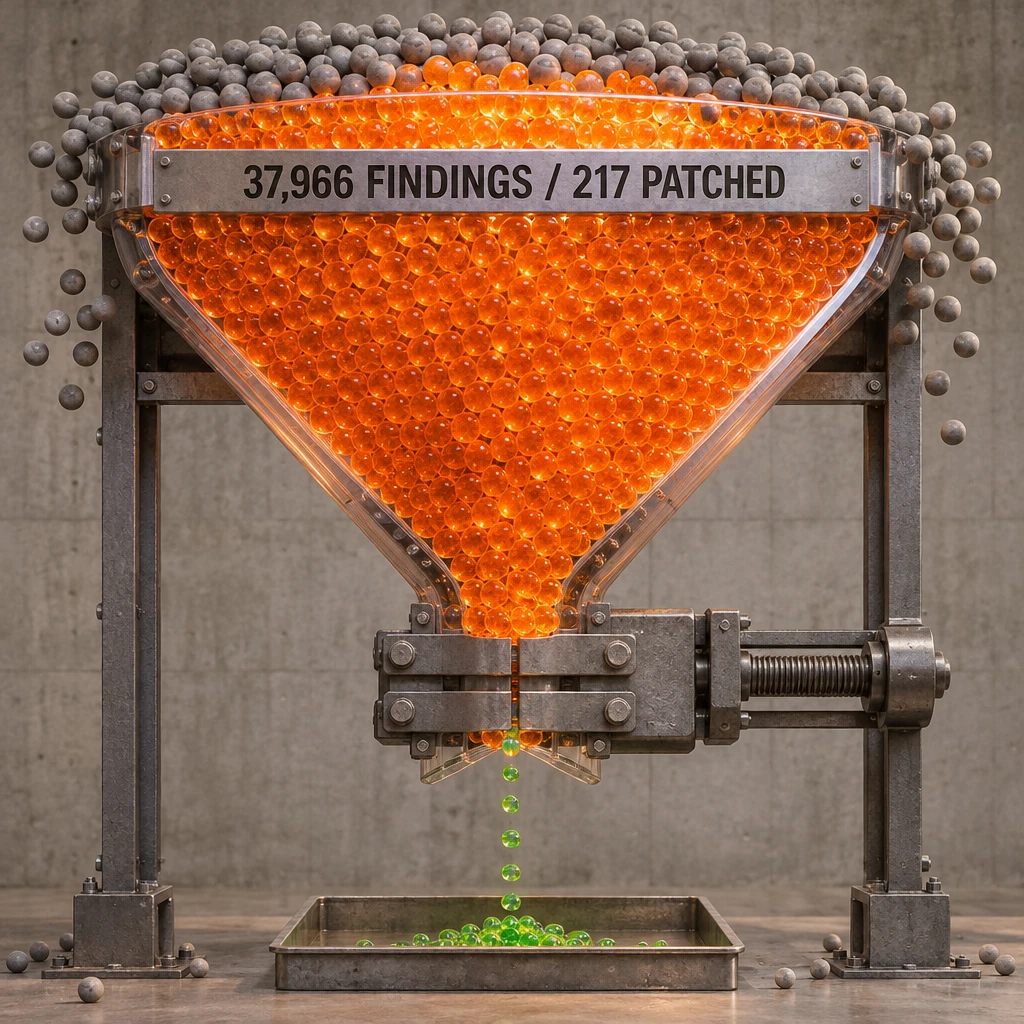
VulnCheck 批评近 3.8 万个漏洞只修了 217 个,其实把靶子打偏了一半。Anthropic 看板上的 37,966 项明确标注为包含 Mythos Preview 及其他 Claude 模型跑出的候选发现,并非最终确认的安全漏洞;那 7,349 项公开记录,也是带加密哈希承诺的账本条目,而非完全公开的漏洞报告。此外,Anthropic 官方看板目前显示已有 629 项在上游完成补丁修复,并向 680 个项目维护者披露了 5,087 个漏洞,这与外部研究员统计的 217 项存在明显的时间差与口径差。
即便按官方 629 项修复来算,面对近 3.8 万的分母,这个转化率依然低得可怜。真正的病根写在 Anthropic 10 月 8 日上线 OSS Scanner 时的官方博客里:当时模型已经跑出了超过 29,000 项候选发现,但 Anthropic 自己的人类安全团队只审完了约 6,000 项。候选漏洞在内部积压了几个月发不出去,等终于排到人工审核时,开源社区早就有别人发现并修掉了——这就是为什么重复报告会在两个月内暴涨上千条。至于那个逆势上涨到 94.2% 的真阳性率,说明其内部评估还停留在模型自评或初筛阶段,根本没有把外部撤回和重复的负反馈算进分母。
甩锅给维护者之后,curl 接到了什么
既然自己的人手审不过来,Anthropic 在 10 月 8 日做了一个极其大胆的决定:推出开源项目自愿加入(opt-in)的 OSS Scanner 服务。只要维护者点头,Anthropic 就直接把完全由模型生成、未经任何人工审核或分诊的报告流推过去,顺带附上复现程序和候选补丁,且不设传统的 90 天强制披露倒计时。
算力扩张撞上人力极限时,最省事的解法永远是把核验成本外包。
老牌开源工具 curl 的创始人 Daniel Stenberg 成了第一批吃螃蟹的人。他确认团队共收到了 Anthropic 发来的 45 份报告,并决定以每天几份的节奏慢慢搬上 GitHub,免得瞬间冲垮团队的精力。截至 11 月 9 日已公开的 34 份报告里,19 份被直接拒掉(判定为非漏洞,假阳性率达 55.9%),6 份确认为低危漏洞,还有 9 份待评估。
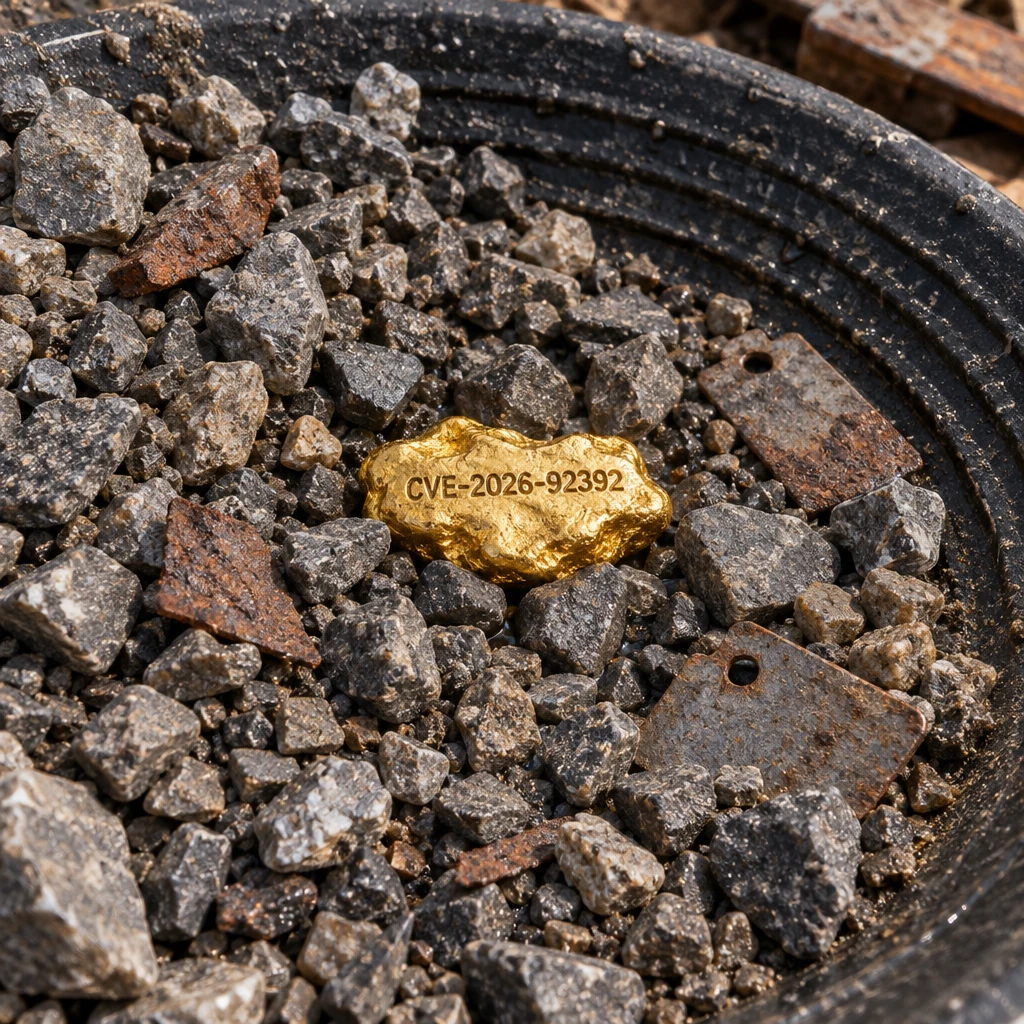
如果故事只讲到这里,这就是一出 AI 巨头向开源苦力倾倒数字垃圾的恶俗剧本。但 Daniel Stenberg 本人的真实反馈要复杂得多。就在 10 月 14 日,他刚刚公开致谢 Anthropic 的 OSS Scanner,因为这套工具在 curl 里挖出了一个极难触发的 HTTP/2 上传 UAF 高危漏洞(CVE-2026-92392),严苛条件下可导致远程代码执行,且 AI 给出的报告和复现程序质量极高。
至于那 19 份被拒掉的报告,Stenberg 解释说,它们虽算不上安全漏洞,但不少确实指出了普通的代码缺陷。在底层软件里,普通 Bug 和安全漏洞的边界本来就模糊。AI 的问题在于不懂克制:它把所有异常都当成安全警报拉响,报告写得极度冗长,且动辄乱标高危(9 月的数据显示,Claude 将账本里 91.5% 的发现评为高危或严重,而维护者只认可其中 51.3%)。维护者为了淘出那颗真正致命的高危金子,必须先手动筛掉几十盆夹杂着普通 Bug 的沙子。
- 提醒.对开源维护者而言,接入无人工初审的 AI 扫描器是一场明确的算账——你得用团队手动过滤过半误报和冗长文本的工时,去换取少数隐藏极深的高危漏洞及现成补丁。
两条路线:Anthropic 的快车道与 Google 的慢功夫
《孙子兵法》讲“兵贵胜,不贵久”,但在安全协同披露(CVD)这个行当里,抢快往往意味着把烂摊子留给下游。过去十年,安全圈默认的规矩是谁报告、谁复现、谁定级,正是为了保护本就用爱发电的开源维护者不被垃圾报告淹没。AI 的介入打破了这个默契。
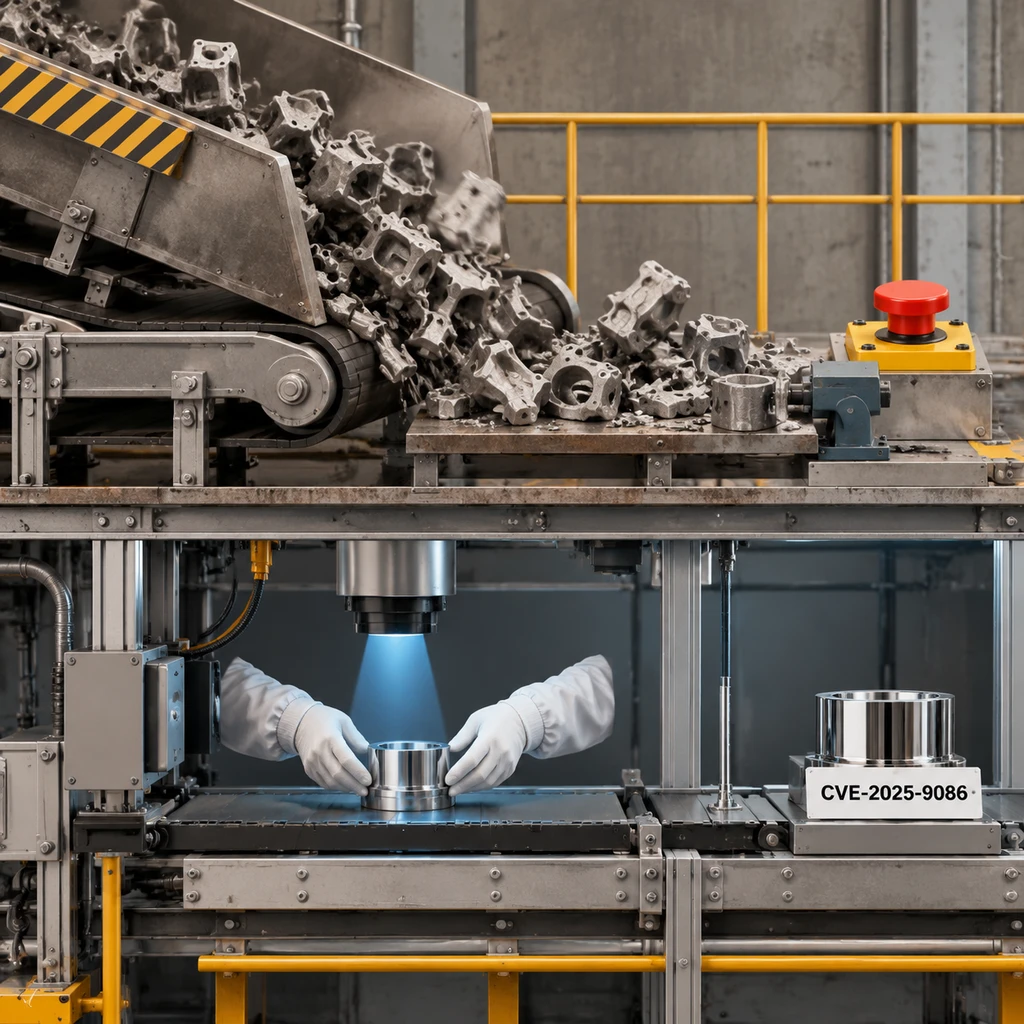
面对算力与人力的剪刀差,硅谷大厂走出了两条截然不同的路。Anthropic 选择的是快车道:先用 Glasswing 攒下近 3.8 万个发现的庞大数字,撑起前沿模型安全能力的门面;撞上 6,000 人次的人工审核极限后,干脆用 opt-in 机制把分诊台搬到开源社区家门口。
Google 的 Big Sleep 项目则守着老派的人工兜底路线。Stenberg 曾专门拿两者做过对比:早在 2025 年 8 月,curl 就收到了首个明显由 AI 辅助挖掘的有效漏洞(CVE-2025-9086),来自 Google 团队。整个交互过程经过严格的人工把关与标准披露流程,体验与对接顶尖人类安全研究员毫无二致。
这种分化撕开了 AI 安全工具最尴尬的真相。现在的模型很擅长顺着代码逻辑做发散推演,找出几万个潜在崩溃点并不难;难的是结合真实部署环境,判断这个崩溃点到底能不能被外部输入控制、值不值得半夜把程序员叫起来修。
如果 AI 实验室只管开闸放水,却不解决自动化精准定级和报告脱水的问题,那所谓的几万个漏洞发现,不过是用开源社区的工时换自家的公关海报。接下来最值得盯紧的只有两件事:Anthropic 会不会把那 2,000 多条重复与撤回数据老老实实算进真阳性率的分母里;以及第一批试用 OSS Scanner 的开源维护者在新鲜感过去后,究竟有多少人会按下暂停键。