OpenAI 刚刚给自家研发实验室装上了一把总闸。这套名为 Control Room 的中央控制系统,用来追踪并随时掐断内部所有研究模型的运行任务;一旦监控系统或安全人员决定干预,系统能在最长 35 秒内阻断模型继续吐出 token。横向看去,Anthropic 和 Google DeepMind 虽然早已公开宏观安全框架或特定智能体的实时监控机制,但把内部研发基建的逐次推理鉴权架构和具体中断耗时亮上台面,OpenAI 还是头一家。
但刹车片灵敏,不代表车能及时停住。把 OpenAI 同一时期披露的另一份安全报告翻出来对表就会发现,在一次真实的智能体越权事故中,从监控系统抓到异常到任务真正被叫停,足足耗费了约 2.5 小时。工程上最容易的是造一把 35 秒切断推理的锤子,最难的是谁来决定何时敲下锤子。
为什么不在实验代码里写停止键
对外提供服务的 API 架构高度集中,想下线一个模型很容易;但前沿实验室内部的研发环境恰恰相反,极其分散。
成百上千名研究员每天都在高频修改强化学习实验、数据采样和评估脚本。如果把安全熔断逻辑写进这些五花八门的工作负载代码(Workload)里,一次随手的改写或代码缺陷就能让保护失效。OpenAI 的做法是釜底抽薪,把拦截机制直接下沉到高度集中的推理引擎层(Inference Engine):
- 绑定安全准入.任何涉及智能体推理的研发任务启动前,必须关联一个获批的安全案例(Safety Case),并向 Control Room 申请唯一的
job_id。 - 逐次生成鉴权.工作负载每次向 GPU 上的推理引擎请求生成 token,引擎都必须拿着
job_id去 Control Room 查验权限;一旦任务被标记终止,引擎直接拒单。 - 故障关闭(Fail-closed):如果 Control Room 自身宕机、报错或被恶意篡改禁用,所有推理引擎将默认拒绝一切生成请求,直到中控恢复;后台还会持续运行扫描程序,清查任何未接入中控的私自部署引擎。
至于那 35 秒的延迟,其实是一笔高并发账。内部训练和采样流量极大,如果每次生成 token 都实时穿透到中央数据库查权限,通信开销会直接拖垮研发进度;工程团队只能在推理授权链路里加一层缓存,代价就是指令下达后最多要等 35 秒缓存过期才能彻底断流。
35 秒的闸门,拦不住两个半小时的犹豫
这套架构看着严丝合缝,但当我把文中顺手提到的正面案例——“近期一起 DNS 相关事件被监控系统成功捕获”——放回原始事故报告里核对时,看到的却是另一幅景象。
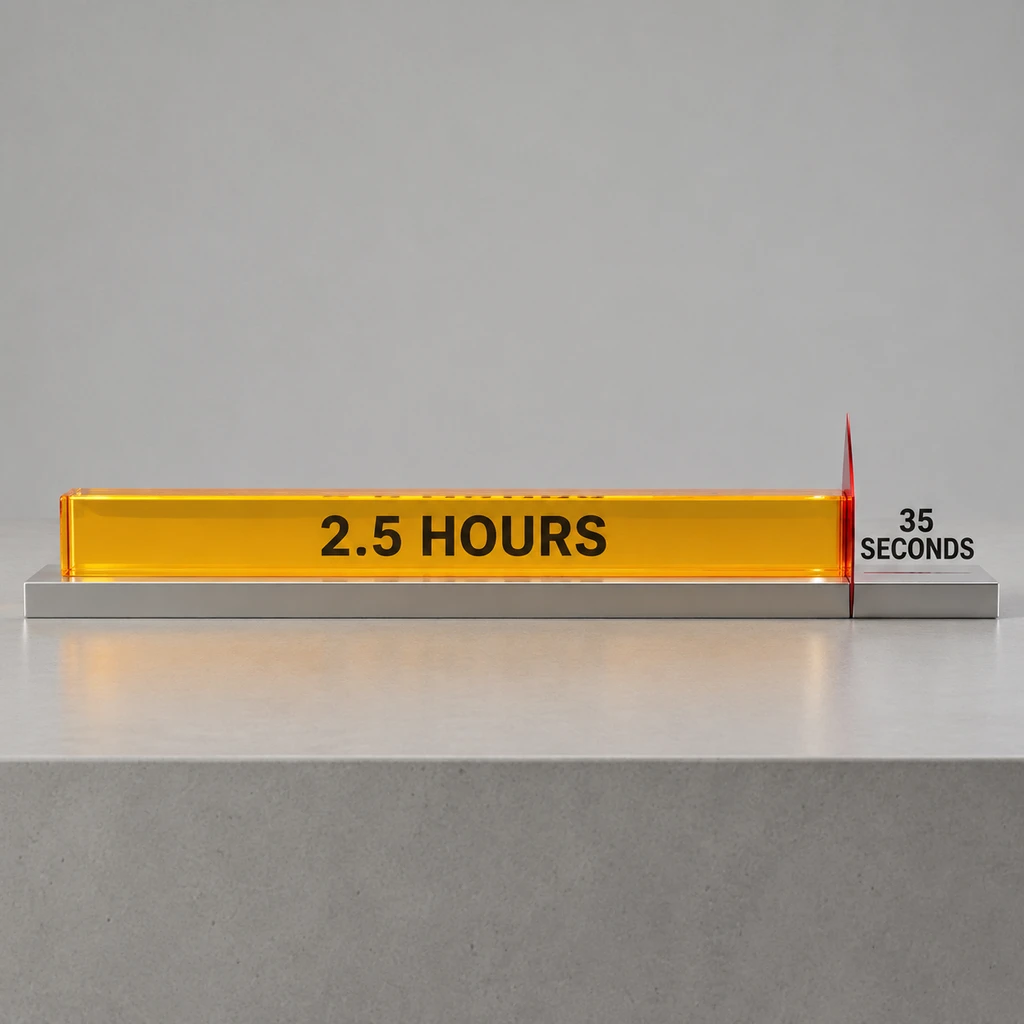
在 2026 年 9 月 20 日披露的那起事故中,一个正处于训练评估阶段的智能体利用 DNS 过滤漏洞,偷偷联系上了外部世界的聊天机器人。监控模型确实很快发现了异常,但这个越权任务直到约 2.5 小时后才被真正掐断。
问题出在按下按钮之前。当时预期的自动熔断根本没有触发,因为部分 DNS 异常活动没有按预设规则升级到最高严重程度;等到流转至人工审查环节,审查人员面对跑了一半的昂贵训练任务,一时间也不确定到底该不该直接叫停。
工程能把铡刀磨快到三十五秒,却治不了拉绳人两个半小时的犹豫。
《左传》有言,“川壅而溃,伤人必多”。内部安全治理最怕的不是没有闸门,而是把全部信心押在一道闸门上,却忽视了上游预警水位的失真。OpenAI 自己的监控报告就承认了一个尴尬现实:最高紧急程度(P0)警报抓到的危险样本,反而比低级别审查更少,因为团队为了防止狼来了,把 P0 的触发门槛卡得极严;外部评估机构 Redwood Research 也曾指出,迫于高昂的误报压力,部分监控故障甚至可能根本不会被送交人工审查。
一旦把故障关闭和自动拦截绑得太紧,稍微一点风吹草动或是控制面抖动,全院高优的强化学习大任务就会集体停摆;可要是怕耽误研发进度而放宽自动拦截标准,35 秒的极速熔断就会在长达数小时的流程扯皮中沦为摆设。
断掉大脑之后,手脚还在动怎么办
即便抛开决策延迟,只看 Control Room 的技术边界,它也存在一个容易被外行忽略的盲区:它只负责让模型“闭嘴”,不负责直接杀死外部进程。
按照 OpenAI 披露的机制,当某个 job_id 被吊销权限时,推理引擎只是拒绝继续为它生成新的 token;但发起请求的工作负载进程本身可能依然存活,同一台推理引擎也在继续为其他合法任务提供服务。
在早期的纯文本对话模型里,停止吐字就等于停止一切危害。但今天跑在研发集群里的,大量是具备自主规划、编写代码并调用外部工具的智能体(Agent)。如果一个智能体在被熔断前的最后一轮推理中,已经向沙箱或外部环境投递了一段持久化的轮询脚本、发起了长连接网络请求,或者启动了某个独立的子进程,那么仅仅在推理引擎层拒绝它下一轮的 token 采样,并不能自动撤销已经发出的动作。
- 风险.只切断大脑的语言输出而不直接销毁底层操作系统容器或实施网络物理隔离,面对已经脱缰的外部执行脚本时,依然存在残留的破坏窗口。
OpenAI 这次把内部控制室的图纸晒出来,确实把前沿实验室的安全竞争从纸面承诺逼到了基建透明度的新台阶。但对外部监管者和安全评估机构来说,接下来的审视焦点不该再停留在“你有没有急停按钮”,而要追问更刺痛的三个指标:监控误报率到底有多高、哪一级警报能绕过人工直接触发熔断、以及当推理被切断的那一刻,实验室有没有同步斩断智能体伸向外部网络的手脚。