2026年11月12日,Nvidia正式宣布创始人黄仁勋辞去总裁、CEO及董事职务(8-K文件显示于11月11日生效),由CFO Colette Kress接任临时CEO,Harvey C. Jones出任董事长。路透社披露,黄仁勋离职源于承认与一名疑似中国情报人员发生婚外情,美国国会议员随即在11月12日借机施压,要求收紧对华AI芯片出口管制并限制中国企业获取海外算力。这场突发人事震荡把中国自动驾驶行业的算力替代表推到了台前,但拨开公开表态就会发现,中国头部智驾公司的Plan B在车端与云端完全是两本账,国产芯片替代更卡在底层算子迁移的工程成本上。
小马智行(Pony.ai)联合创始人兼CFO王皓俊在Web Summit峰会期间对TechCrunch坦言,中国自动驾驶行业的算力需求远超供给,行业几年前就已开始演练Plan B。小马智行目前采取两步走:一是让工程师用中端算力替代高端资源来抠训练效率,二是转向国产芯片分担AI训练需求;但他同时承认,从成本效益来看,国产替代方案目前还不是最佳选择。
车端绑死Thor与云端试水国产卡的温差
外界容易把智驾芯片国产替代理解成一刀切的硬件替换,但自动驾驶对Nvidia的依赖天然裂变为车端推理和云端训练两层。截至2026年11月15日,美国国会议员的呼声仍停留在立法提议阶段,美国工业和安全局(BIS)尚未修改2026年1月13日对H200、AMD MI325X等芯片设定的逐案审查规则,也没有针对车载芯片出台直接禁令。
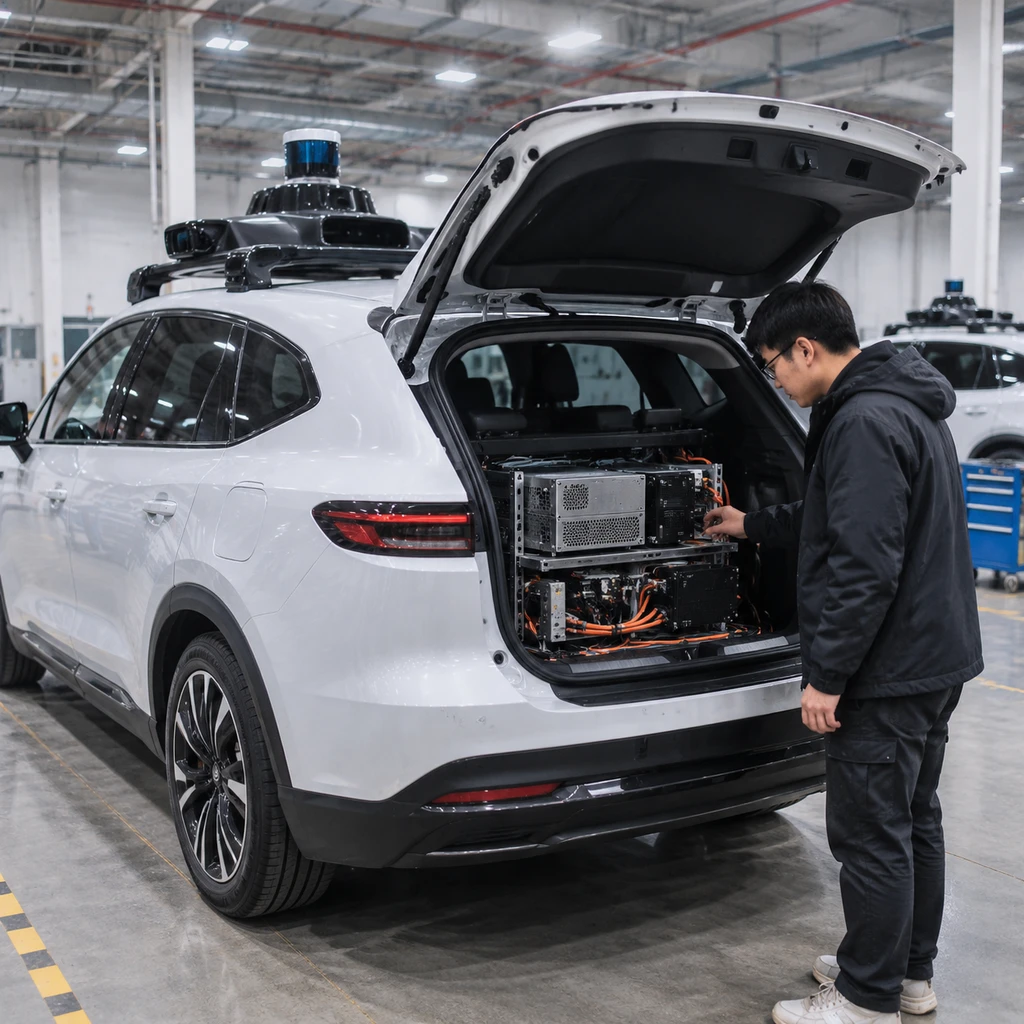
这种监管温差直接反映在企业的真实动作里。小马智行在2026年5月刚刚宣布基于NVIDIA DRIVE Hyperion和DRIVE Thor构建新一代车载计算平台;文远知行(WeRide)2026年5月的公开文件同样显示,其车载端虽已兼容高通骁龙与芯擎星辰芯片,但核心主力依然包含NVIDIA DRIVE处理器。车规级硬件涉及漫长的安全认证与实车路测——美国国家公路交通安全管理局(NHTSA)近期还在调查Waymo一年前因Robotaxi违规超越校车而发起的软件召回——没有任何一家冲刺商业化的Robotaxi公司敢在车端轻易换掉跑通的算力底座。
真正的替代只发生在云端训练机房,且推进得比公开口径更谨慎。小马智行CEO彭军在2025年曾透露训练端主要靠旧代际芯片配合软件优化,而查阅小马智行与文远知行截至目前的公开技术与财务文件,均未证实其核心云端训练集群已成建制迁移至华为昇腾或寒武纪。
拆解性价比痛点:卡在自定义算子上的工程账
王皓俊直言国产训练芯片成本效益不佳,这笔账如果只看硬件采购单价根本算不明白。自动驾驶算法团队衡量算力底座,看的是训练出每一个合格大模型的综合总成本,里头包含了算力折旧、底层迁移工时、收敛失败重跑损耗以及双栈维护代价。
国产芯片与Nvidia的真正代差不在标称算力,而在不同模型架构下的吞吐量分化与算子生态。华为昇腾(Ascend)目前已通过CANN、PyTorch插件torch_npu和DrivingSDK专门适配自动驾驶训练,从其官方公布的8卡Atlas 800T A2实测数据就能看出这种冷热不均:
| 智驾模型架构 | 8卡Atlas 800T A2表现 | 未具名竞品表现 | 新一代8卡Atlas 950 SuperPoD |
|---|---|---|---|
| BEVDet | 70.41 FPS | 35.56 FPS | 未披露同口径数据 |
| BEVFormer | 3.66 FPS (混合精度3.33 FPS) | 3.32 FPS | 11.64 FPS (混合精度) |
| SparseDrive (第一阶段) | 46.3 FPS | 41.0 FPS | 未披露同口径数据 |
| UniAD (第一阶段) | 1.002 FPS | 1.359 FPS | 未披露同口径数据 |
数据很直观,在BEVDet、BEVFormer和SparseDrive这类完成专项优化的模型上,昇腾8卡集群已经能压过竞品,新一代Atlas 950 SuperPoD在BEVFormer上的吞吐量更是拉升到11.64 FPS。但到了结构更复杂的端到端模型UniAD第一阶段,Atlas 800T A2的帧率就掉到了1.002 FPS,反被竞品甩开。
硬件差价只是明面小钱,重写底层CUDA算子才是吞噬利润的无底洞。
造成这种分化的罪魁祸首是自定义CUDA算子。自动驾驶网络里塞满了稀疏计算、可变形注意力机制(deformable-attention)和体素化(voxelization)等非标算子。寒武纪虽然通过Neuware和torch_mlu支持PyTorch并集成了VeOmni,但其技术文档明确承认,部分仅限CUDA的算子必须走降级回退(fallbacks)或跳过路径,且至今缺乏公开受控的自动驾驶训练基准测试。
- 风险.一旦核心算子触发降级回退,不仅训练吞吐量会断崖式下跌,更致命的是模型收敛精度可能出现细微漂移,迫使算法工程师花几个月去重写底层C++算子并重新调参。
对于小马智行、文远知行以及刚刚拿到KDDI领投208亿日元(约1.35亿美元)融资的日本Robotaxi初创公司Newmo、计划到2031年部署超1万辆大众ID. Buzz自动驾驶汽车的May Mobility而言,Robotaxi正处于烧钱换规模的生死关头(同期电动车企Lucid三季度净亏损仍高达8.309亿美元,不得不将沙特PIF的定期贷款额度增至17.5亿美元续命)。在资金与工程人力双重紧绷的当下,让高薪算法团队停下模型迭代去给国产芯片手搓底层算子,是任何一家智驾公司CFO都算不过来的亏本账。接下来最值得盯紧的两个信号,一是美国国会能否借黄仁勋离职事件真正推动BIS收紧海外算力租用与逐案审查红线,二是哪家中国头部智驾公司会率先在公开技术报告中,晒出完全基于昇腾或寒武纪底座从头训练收敛的量产级端到端大模型。