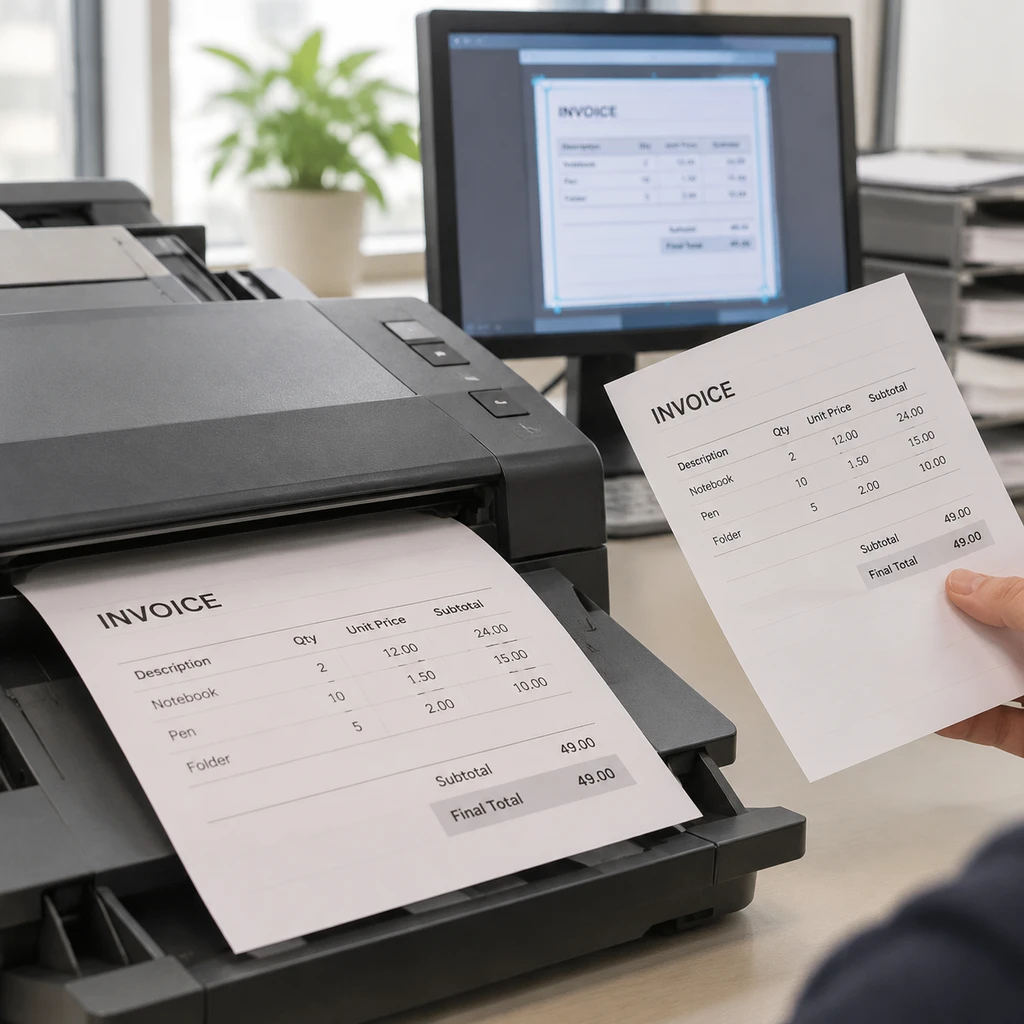
一个字段拿到0.97 的置信分,数字也确实印在原文上,却取自错误的一列。这是 Nutrient 自己给出的例子。它推出的 Data Extraction API 能按你定义的 JSON schema 抽取字段,并附上原文位置和匹配标签,有分数时也会返回置信度。我更看重那个能点回原文的框。做财务自动化,能迅速查清数字从哪来,比多看一眼分数实在。
给 JSON 留一条回原文的路API 能把 PDF、扫描件、图片和 Office 文件转成带位置信息的 JSON 或 Markdown,也能按指定字段抽取。原生电子文档可直接取文本,简单扫描件可走 OCR,复杂版面和退化扫描可用更重的解析模式。Auto 支持逐页路由,同一引擎也有 MCP、agent skill、Mac 应用和 SDK入口。
团队可以在 Studio里配 schema、换样本跑一遍,检查字段值和页面框选,再把配置存成有版本的处理器,由 API 按 ID 调用。每组评估最多放25份已审阅文档,适合比较配置。碰上罕见版式、手写内容或跨页表格,还得另备样本。
##86.2 分测的是整份文档怎么读Nutrient 自建的 WholeDoc Bench 用480份文档、633 页测试了13 个解析器的19 种配置,覆盖30 多种语言。它给文本保真、阅读顺序、结构、表格、条码、图表和页面位置打分。Agentic 拿到 86.2 分,Claude Fable5.1 高投入配置拿到67.1。这个总分衡量的是整文档解析,发票总额取对了多少次,要拿着 schema 单独测。
综合分把单项差异压平了。Agentic 的条码分是100,Claude 是3.6,表格却只差87.1 对84.7。阅读顺序上,GPT-6.1 Sol 中投入配置以94.9 高过 Agentic 的93.7。评测还让前沿模型逐页接收请求,并使用 Nutrient 编写的版面提示词。跨页表格多的团队尤其该按自己的请求方式再跑一遍。
主测试集是私有的。公开的评分代码、配置和10份共28 页的样本,足以检查评分过程,只能复现公开部分。LlamaIndex 的 ParseBench 就排出了另一种顺序,Nutrient DWS Agentic 得76.4,Anthropic Fable5.1 得78.1。另一项 ParseBench-2 给 LlamaParse Agentic Plus 打了90.1。换一套文档和评分方法,榜首就可能换人。
每页成本有两种口径MarkTechPost 的赞助稿给 Agentic解析标了每页1.8 美分。Nutrient 官方定价页列的是每页18 credits,按 Starter 每 credit0.0028 美元的超额费率算,则是每页5.04 美分。后者对应超额用量,前者对应哪个套餐和计费条件,还有待确认。
这两笔都只算解析。采购预算还要加上字段抽取、失败重跑和人工复核。框选要是经常指错列,省下的调用费可能转头就花在翻原件上。
发票能不能自动入账,要过三关纸质账簿对账,找到凭证还得核对科目。今天点一下就能跳回发票,但框住小计,也能给一个抄得很准的错答案。Nutrient 的分数可结合模型输出概率、候选差距、原文支持和格式等信号。匹配标签能帮忙筛出模糊匹配,缺分则表示这个字段没有返回评分。公开资料里还缺少足以证明分数已经校准的证据,也缺少能代表开发者群体的系统性反馈。
微软也说明,Azure Document Intelligence 的部分字段可能缺分,关键流程应拿代表性文档评估,并安排人工复核。选型时,可以用同一批真实文档、同一份 schema 和同一套放行规则,比 Nutrient、Azure以及以 LlamaParse 做解析的方案。分别记字段值和引用的正确率,再按置信度分段数错例,同时记录延迟、复核量和总成本。
我会让 Nutrient进试点,因为回查原件这一步做得具体。至于能不能把发票直接送进账务系统,得看自家单据里,那些拿到高分的总额还有多少来自隔壁一列。