2026年10月28日,MiniMax 开源了名为 MCode Stack 的项目,把内部编码团队日常使用的 15 项 Agent 技能直接放到 GitHub 上。这套技能基于通用的 SKILL.md 格式,不仅能用在自家的 MCode 里,还能直接装进 Anthropic 的 Claude Code 和 OpenAI 的 Codex。但在自家发布的 OctoCodingBench 基准测试中,MiniMax M2.1 面对包含技能和仓库指南的复杂指令时,实例级成功率只有 26.1%,低于 Claude Opus 4.5 的 36.2%。
很多人第一眼会把这次开源当成自家编程工具的引流动作,但翻开 MiniMax-AI/mcode-stack 仓库就会发现,里面连一个正式打包的 Release 版本都没有。它和独立仓库里的客户端本体 minimax-code 完全是两码事。MiniMax 这次开源的不是软件,而是一本写给 AI 看的工程纪律手册,试图解决长会话失控、上下文污染和代码审查走过场这三个行业通病。
拆开 15 项技能:不是写代码,是管教 AI
这套被称为 Ronny’s stack 的 15 项技能,核心任务不是教大模型怎么写语法,而是逼着 Agent 像资深工程师一样守规矩。它把平时藏在老员工脑子里的隐性开发规范,拆成了可执行的模块:什么时候该把任务拆给子 Agent(subagent-split-check)、怎么控制长会话与命令管理、如何做独立的代码审查(independent-review),以及在紧急变更和实验(harness-experiment)里怎么防止把代码库搞崩。
这里有一个外界通稿普遍漏掉的合规细节。虽然仓库默认挂着 MIT 许可证,但其中 6 个以 engineering-* 开头的技能,实际上改编自 Google Engineering Practices。这意味着改编部分仍然受 CC BY 3.0 协议约束,只有作者新增的部分才是 MIT。企业团队如果想直接把这套技能扒下来塞进商业闭源项目分发,不留署名就会踩中许可证雷区。
兼容竞品目录背后的标准卡位
更有意思的是 MiniMax 在跨平台兼容上的算盘。目前主流的三大编程 Agent 都在推 SKILL.md 格式,但各自划了地盘。MiniMax 的 MCode 选择了一条最激进的兼容路线:它不仅读自己的 .minimax/skills/ 目录,还直接扫描 Claude 的 .claude/skills/ 和通用 .agents/skills/ 目录,甚至在文档里手把手教开发者怎么把 MCode Stack 装进 Claude Code 里用。
| 宿主工具 | 支持扫描的技能目录 | 运行时隔离与扩展机制 | 跨平台直接迁移的局限 |
|---|---|---|---|
| MiniMax MCode | .minimax / .claude / .agents | 原生子Agent协调与长会话恢复 | 客户端仍存内存与超时等稳定性瑕疵 |
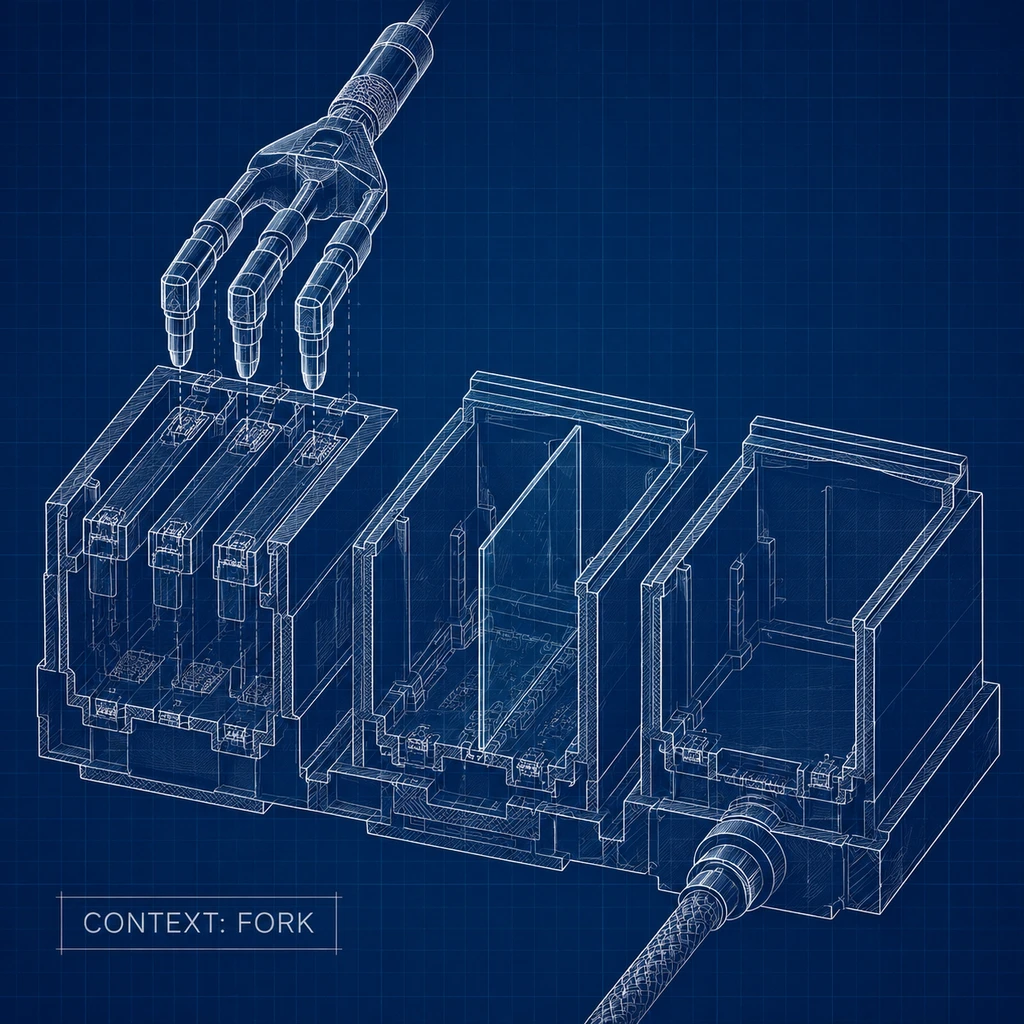
| Claude Code | .claude/skills/ | 支持 context: fork 隔离与 hooks | 强依赖专属 frontmatter 字段控制行为 |
| OpenAI Codex | .agents/skills/ | 依赖 agents/openai.yaml 配置策略 | 工具依赖与策略配置无法靠纯文本通用 |
我更在意的是这种主动给竞品做嫁衣的打法。在桌面客户端生态还没打赢 Anthropic 之前,先把自家的工程方法论变成开发者在 Claude Code 里的顺手插件,是用工作流标准反向渗透对手的腹地。
但跨平台复用远没有宣传的那么丝滑。SKILL.md 只是一层薄薄的 Markdown 文本,真正的重头戏全在宿主软件的运行时控制里。Claude Code 可以靠 context: fork 启动一个上下文完全隔离的子 Agent 来做独立审查,而 OpenAI Codex 依赖额外的 openai.yaml 来声明工具依赖。你把同一个技能文件直接拷过去,没有底层运行时的隔离配合,Agent 照样会在同一个被污染的上下文里自己审自己。
菜谱写得再好,模型只听进去四分之一
把工程规范写成几十个 Markdown 文件很容易,但残酷的行业现实是,现在的底层模型根本背不下这么多规矩。
提示词写得像法典,大模型读起来像废纸。
这恰恰戳破了开源即提效的幻觉。截至2026年10月28日,没有任何受控实验证明单靠加载 MCode Stack 就能带来可量化的生产力提升。相反,副作用已经先暴露了:
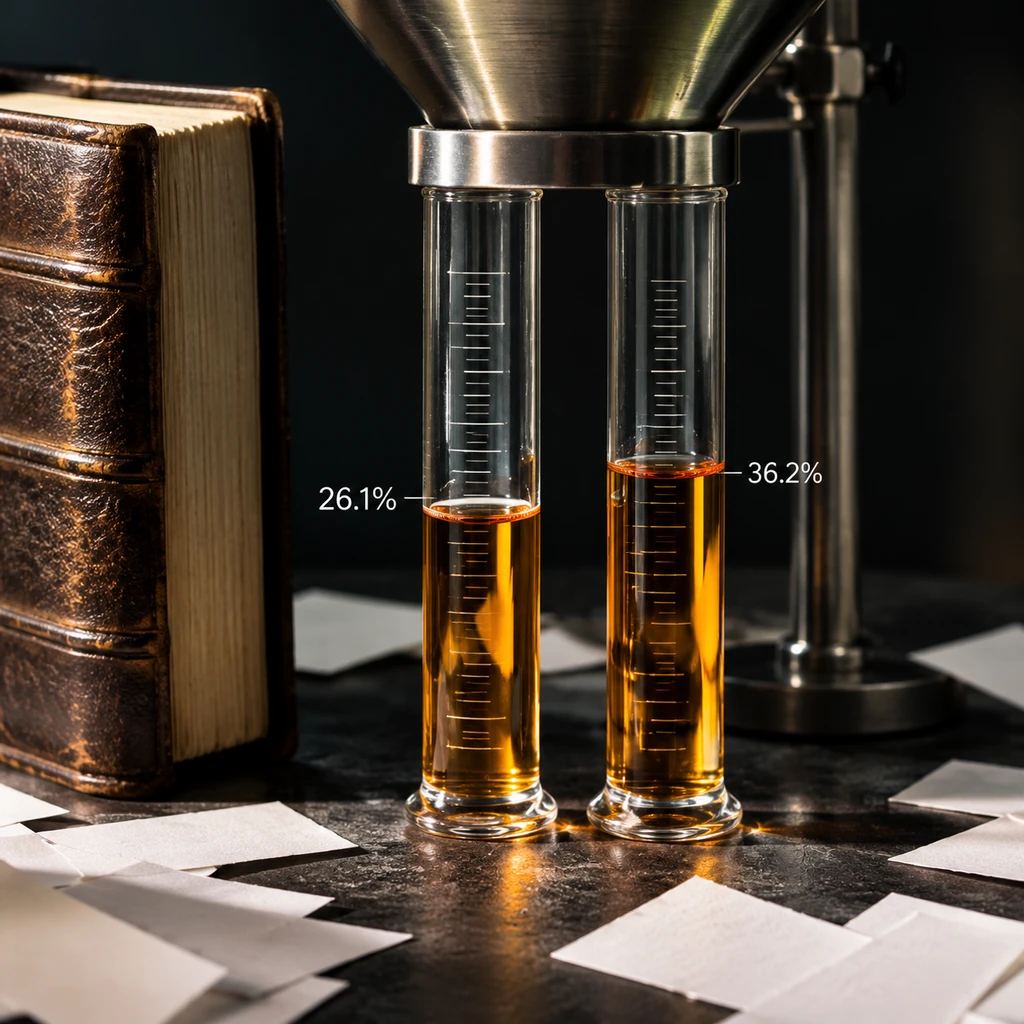
第一个瓶颈是指令遵循率。MiniMax 在 2026年1月14日发布的 OctoCodingBench 就是专门测这件事的:把技能规则、系统约束和仓库指南混在一起交给模型,看它能不能一字不差地守规矩。结果 M2.1 只有 26.1% 的实例能完全合规,连行业头部的 Claude Opus 4.5 也才拿到 36.2%。古人讲“徒法不足以自行”,规矩定得越细密,模型顾此失彼的概率就越高。
第二个瓶颈是上下文税。在 minimax-code 仓库的 Issue #263 中,开发者已经直接指出,把一堆技能目录和 MCP Schema 一股脑塞进会话,会造成严重的重复 Token 消耗,急需按需发现(on-demand discovery)机制。这很像二十世纪七十年代软件工程危机时的《人月神话》:当年企图靠堆砌厚重的流程文档来消灭 Bug,结果流程本身吃掉了工程师大半的精力;今天企图靠堆砌 SKILL.md 来管住 Agent,结果技能表先把模型的上下文窗口撑爆了。当然,今天的情况和当年不完全一样,AI 消耗的是可计算的 Token 和注意力权重,只要运行时能做好动态按需加载,这笔税还有机会降下来。
至于 MCode 客户端本体,工程打磨的欠账依然明显。在外部评测里,一个只有 11 行代码的微型 Python 仓库,MCode 修复除零错误并补齐 6 个测试花了 38 秒,生成指南花了 30 秒,期间还伴随着原生依赖安装和远程登录的摩擦。而在 GitHub Issue 区,10月19日提交的 Issue #508 报告 0.6.11 版本在 Linux 下会耗尽可用内存,10月20日的 Issue #512 则反馈特定 macOS 桌面版在恢复持久化任务队列时会反复卡进 10 分钟超时。逼着社区里不少开发者干脆只拿 MCode 当外壳,背后接外部模型干活,或者反过来把它的技能包拆进 Claude Code 里用。
- 风险.盲目把 15 项全量技能塞进项目目录,不仅会因重复加载目录 Schema 白白烧掉大量上下文 Token,还会稀释模型对核心业务逻辑的注意力,建议只先挑
independent-review等 1-2 个高频痛点技能做同模型 AB 测试。
所以别再被“15 项内部秘籍开源”的标题牵着走了。对一线研发团队来说,MCode Stack 真正值得白嫖的,是它把代码审查和子任务拆分写成结构化检查单的思路。接下来真正决定各家编程 Agent 高下的,不再是谁家开源的 Markdown 菜谱更厚,而是谁能先解开 Issue #263 里的按需加载难题,把那可怜的 26.1% 规则遵循率往上提一提。