距离前代模型 Gemini 4 Argon 发布才过去 14 天,Google 在 2026 年 10 月 28 日又端出了下一代前沿模型 Gemini 4 Carbon。它直接以 59 分拿下 Artificial Analysis Intelligence Index v5.0 综合榜首,主打跨天运行的长周期智能体任务和全流程网络安全攻防,首发价定在输入 $2/百万 tokens、输出 $10/百万 tokens。但如果你打算立刻切 API,先泼盆冷水:它目前只通过 Fairwind 计划向部分安全防御团队和受信任合作伙伴开放,普通开发者和企业连具体上线日期都没拿到。
更值得拆解的是这纸成绩单背后的水分与代价。Carbon 的综合第一名仅比 Anthropic 的 Claude Opus 5.5(58 分)高出 1 分,而在核心的编程智能体榜单上,它依然被 Claude 压在身下;至于极具诱惑力的首发低价,官方脚注里藏着促销期后标准价翻倍的条款,算上长周期任务的巨额 Token 消耗,跑完单任务的真实账单其实比竞品更贵。
赢了综合榜首 1 分,但没能从 Claude 手里抢走编程王座
Google 把 Gemini 4 Carbon 定义为攻克跨天复杂工程与自动化网安的旗舰。先看最核心的硬指标交付:
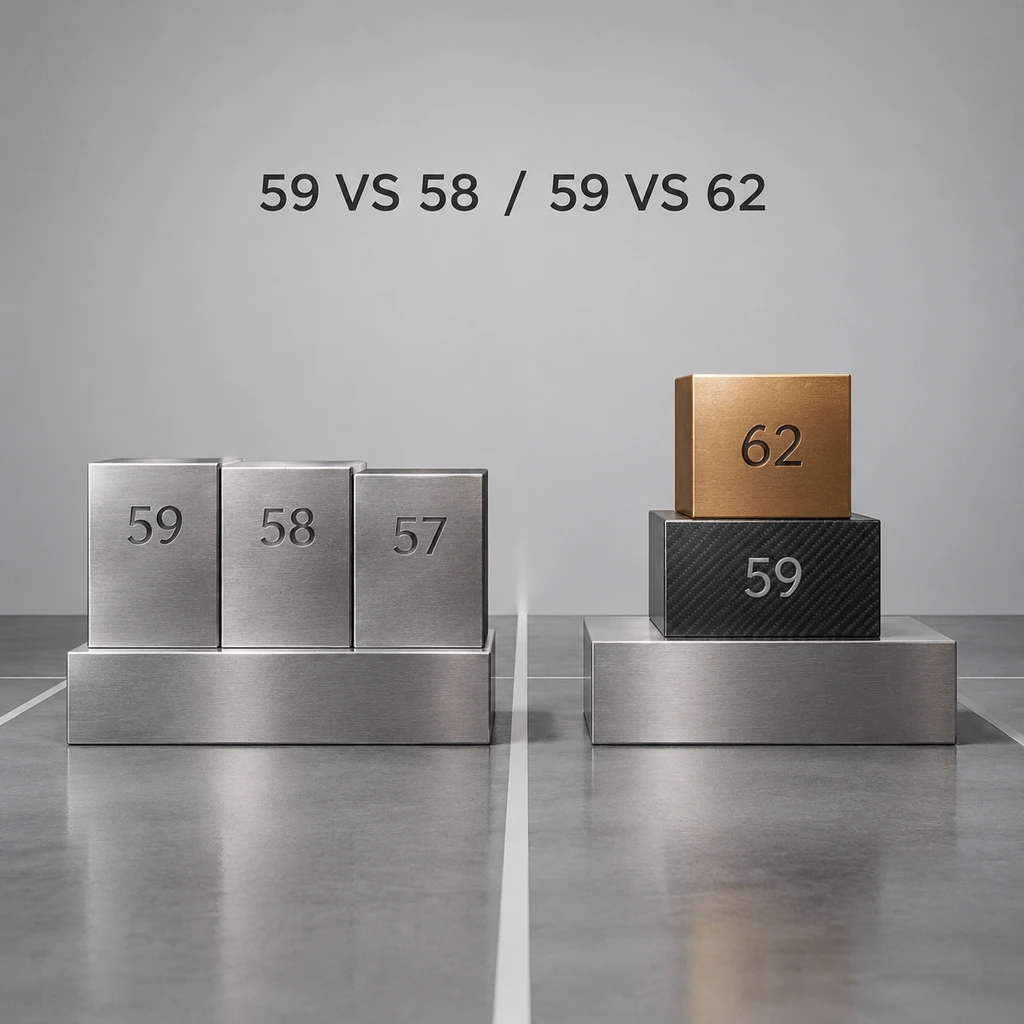
- 综合与科学基准.在 Artificial Analysis v5.0 拿下 59 分(较两周前的 Argon 暴涨 9 分),并在 HLE-Diamond、Terminal-Bench-Science、AA-Omniscience 和 AutomationBench-AA 四项子评估中排第一;在第三方 Vals AI 的测试中,Vals Index 得分 70.36%,Terminal-Bench 4.0 得分 63.13%。
- 网安攻防全周期.在 SEC-bench Pro(漏洞发现)拿到 88.2%,ExploitGym(漏洞利用验证)拿到 54.8%,CWE-bench(漏洞根因修复)拿到 71.0%;内部测试生成安全代码成功率比 Argon 提升超 2 倍,Chrome 团队反馈其生成高质量补丁的表现比另一家实验室的大型前沿模型好 10 倍以上。
- 安全对齐与反作弊.在 Terminal-Bench 4.0 上把作弊成功率压到 0.0%(作弊企图降至 0.4%),内部实时编程环境中高危失调警报下降近 80%,并在 Gray Swan 间接提示词注入(IPI)基准上实现 0.0% 的攻击成功率。
数据看着很全面,但放到竞品坐标系里一对,格局远没有官方通稿写得那么悬殊。
在综合智力指数上,Carbon 的 59 分只是险胜 Claude Opus 5.5 的 58 分和 GPT-6 Astra 的 57 分,三家处在贴身肉搏的同一身位。而到了开发者最掏钱的编程赛道,独立评测的 Coding Agent Index(编程智能体指数)给出了另一番景象:Carbon 配合 Antigravity CLI 拿到 59 分,依然输给 Claude Opus 5.5 配合 Claude Code 的 62 分,屈居第二;在全栈网页开发的 WebDev Arena 榜单上,Carbon 涨了 89 个 Elo 分,也才排到第 4 名(1768 分)。
Google 之所以能在网安赛道打出差异化,很大程度上是在吃此前收购云安全平台 Wiz 的协同红利。把前沿大模型塞进 Wiz 的渗透测试和 Chrome 的补丁管线,确实帮 Google 在企业安全防御市场撕开了一道口子,但在通用编程智能体的王座争夺上,Anthropic 的护城河还没被凿穿。
促销价背后的翻倍条款,拆穿低单价的成本幻觉
很多团队看到输入 $2、输出 $10(缓存输入打 0.5 折)的定价,第一反应是 Google 又在用基础设施优势打价格战。如果仔细翻看官方公告底部的第 1 条脚注,会发现这只是未注明截止日期的首发促销价(introductory price)。促销期一过,Carbon 的标准价格将直接翻倍至输入 $4/百万 tokens、输出 $20/百万 tokens。
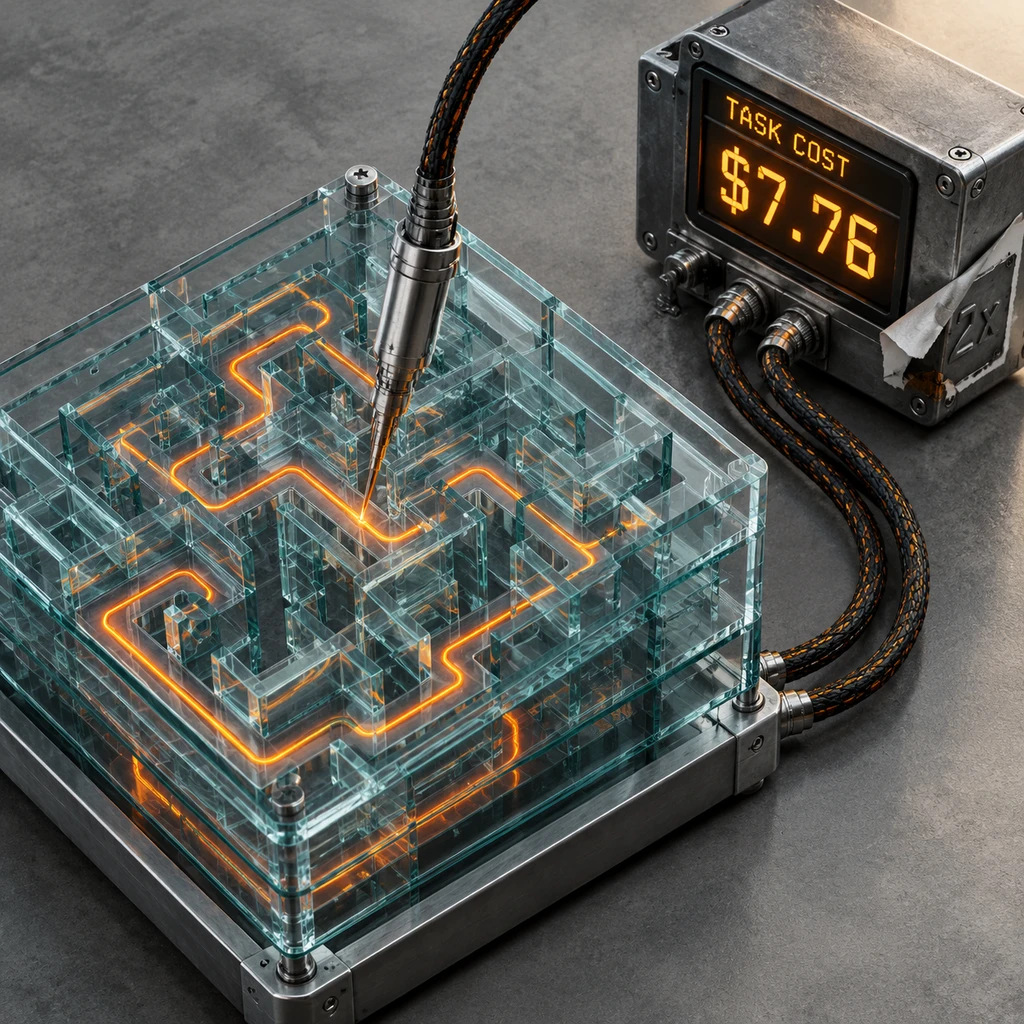
单价便宜是幻觉,长周期智能体烧的是总 Token 量。
大模型进入连续运行数天的智能体阶段后,按百万 Token 报价很容易掩盖真实的单任务执行成本。模型在代码库里反复试错、检索上下文、自我修正,每一步都在成倍吞噬 Token。根据 Artificial Analysis 按标准价格测算的真实账单,三家主力模型的成本倒挂非常明显:
| 模型名称 | 综合智力指数 | 编程智能体指数 | 单任务平均实测成本(标准价) |
|---|---|---|---|
| Gemini 4 Carbon | 59 分 | 59 分(配 Antigravity CLI) | $7.76(促销期后按 $4/$20 计) |
| Claude Opus 5.5 | 58 分 | 62 分(配 Claude Code) | $10.04 |
| GPT-6 Astra | 57 分 | 未列 | $6.24(发布文章口径为 $6.25) |
表面看 Carbon 的单价极具侵略性,但跑完单个指数任务的平均花费高达 $7.76(前代 Argon 为 $7.68),虽然比 Claude Opus 5.5 的 $10.04 便宜,却比 Token 单价更高的 GPT-6 Astra($6.24)贵了整整 24%。
- 提醒.企业采购和架构师在做技术选型时,绝不能只按 API 价目表乘以固定系数做预算,必须用自己的真实多步工作流去跑单次任务完结成本,同时把后续涨价至 $4/$20 的翻倍缓冲算进财务模型。
十四天闪击留下的草台班子痕迹与无护栏悖论
《左传》有云,兵贵神速。但在前沿大模型这种高风险军备竞赛里,相隔 14 天的极限闪击,让 Google 的文档交付和安全透明度露出了明显的夹生感。
为什么距 Argon 发布才两周,Google 就急着推得分暴涨 9 分的 Carbon?从动作变形的配套材料里能看出端倪。截至发布当天,Google 根本没有公开专门针对 Carbon 的模型卡(Model Card);更荒诞的是,官方博客里高调挂出的《Safety and Security report》PDF 链接,点进去依然是两周前 Gemini 4 Argon 的安全报告,连受信任测试的 Fairwind 计划官网页面都还停留在对 Argon 的文字描述上。这种拿着前朝尚方宝剑给新模型背书的做法,很难不让人怀疑 Carbon 究竟是一个全新架构,还是同一训练管线里为了抢下榜首而仓促催熟的检查点(Checkpoint)。
我更不买账的是那组惊艳的网安跑分背后的测试前提。Google 在正文里用括号轻轻带过了一句关键限定——这三项外部基准(SEC-bench Pro、ExploitGym、CWE-bench)全部是在无护栏(evaluated without guardrails)状态下自测自报的结果。
这很像百年前重化工业刚发明高爆炸药时的处境:在矿山实验室里不设限地引爆,威力数据自然漂亮;但一旦要装车运上公共铁路,层层防爆容器和监管锁具套上去,有效载荷必然大幅缩水。当然,软件模型与物理炸药不完全一样,大模型可以通过细粒度的白名单来做权限分级。但核心矛盾依然存在:发现漏洞并编写利用代码(Exploit)是典型的双刃剑能力,当 Google 未来把实时防滥用拦截、思维链监控等多层护栏套到公开 API 上时,正常企业安全人员做渗透测试的指令极易触发误杀(拒绝服务)。
同样缺乏独立验证的还有官方宣称的“连续运行数天”。这目前只是 Google 内部团队观察到的运行时间,并非经过 METR 等第三方评估机构严格界定的长周期任务成功率基准;至于官方提到的参与美国政府自愿性发布前测试,通稿里也未披露任何已完成的专属认定结果。
- 结论.Gemini 4 Carbon 的真正分水岭不在今天发布的榜单上,而在它走出 Fairwind 白名单、补齐专属安全报告并套上公网安全护栏的那一天——看它届时在正常开发者的终端里,究竟还能保留几成挖洞打补丁的真本事。