2026 年 10 月 24 日,微软正式在 GitHub 上以 MIT 协议开源去中心化多智能体框架 Agensh,版本号标记为 v1.0。这项此前发表于 arXiv 预印本平台(编号 2609.26781)的研究,首次向行业展示了多达 1,024 个 Agent 在没有人类介入、无外部网络访问的环境下,协同重构大型软件工程的完整记录。
把智能体数量拉到四位数,并不意味着工程生产力会出现千倍跃升。Agensh 证明了去中心化组织模式在多智能体系统中的可行性,但其实测跑分同样给狂热的自动化预期浇了一盆冷水:在核心实验任务中,从 128 个 Agent 扩张到 1,024 个 Agent,算力规模整整扩大 8 倍,代码测试通过率却仅从 50.94% 微升至 55.06%,换取了仅仅 4.12 个百分点 的边际改善。
告别中心调度,Agensh 把开源协作搬进系统
在以往的多智能体演化路径中,系统节点一旦扩张到数十个,通常就会迅速崩溃。早期以微软 AutoGen 为代表的框架依赖群聊广播机制,信息在所有节点间漫灌,迅速引发上下文爆炸;LangGraph 选择基于 Pregel 计算模型的有向状态图,依赖严密的同步编排;而微软商业化主推的 Microsoft Agent Framework(MAF)则依赖预先定义的确定性工作流。无论是群聊还是中央调度器,都存在一个致命瓶颈:作为中心调度器的模型节点处理能力存在物理上限。
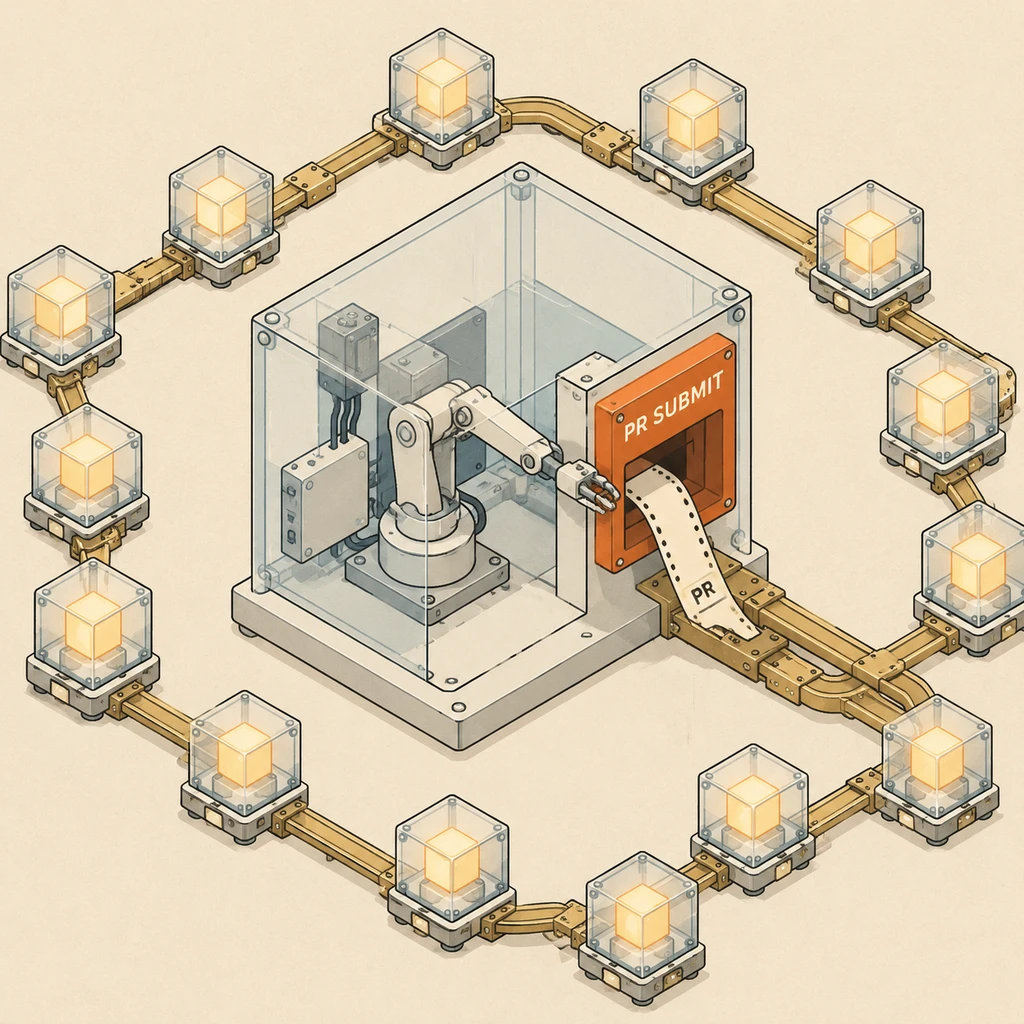
Agensh 选择彻底丢弃中心编排器,转而模拟人类开源社区的协作模式。在整个架构中,1,024 个智能体没有唯一的指挥官,而是依靠三套共享的基础设施运转:一套基于 Gitea 的版本控制系统用于代码存储与分支合并,一套基于 Mattermost 的即时通讯服务用于任务讨论与认领频道,以及一套受 DeLM 启发的全局共享上下文数据库,用于沉淀事实、环境观察与失败尝试。
智能体在该系统内运行着闭环自主状态机,整体流程分为五个阶段:
每个 Agent 在进入工作时先读取全局上下文,发现未解决问题后在公共频道声明认领,随后在本地独立沙盒创建分支并编写代码。跑通本地单元测试后,Agent 向 Gitea 提交合并请求。整个流程没有单一决策节点,系统通过分支冲突判定与持续集成规则,完成了庞大团队的工程协同。
跑分背后的边际瓶颈与隐形成本
脱离中心调度后,千级 Agent 是否带来了期望中的工程跃升?实验数据给出了极为冷静的答案。
在论文测试中,团队使用了 GPT-5.6-sol 模型并开启高推理工作量模式,设定了 6 小时 固定物理时间预算。在包含 FFmpeg、GROMACS、Pandoc、PHP-src 和 ctags 五大高难度开源项目的 ProgramBench 基准测试中,128 个 Agent 的协作使平均测试通过率从单 Agent 的 19.31% 增长到了 28.78%。
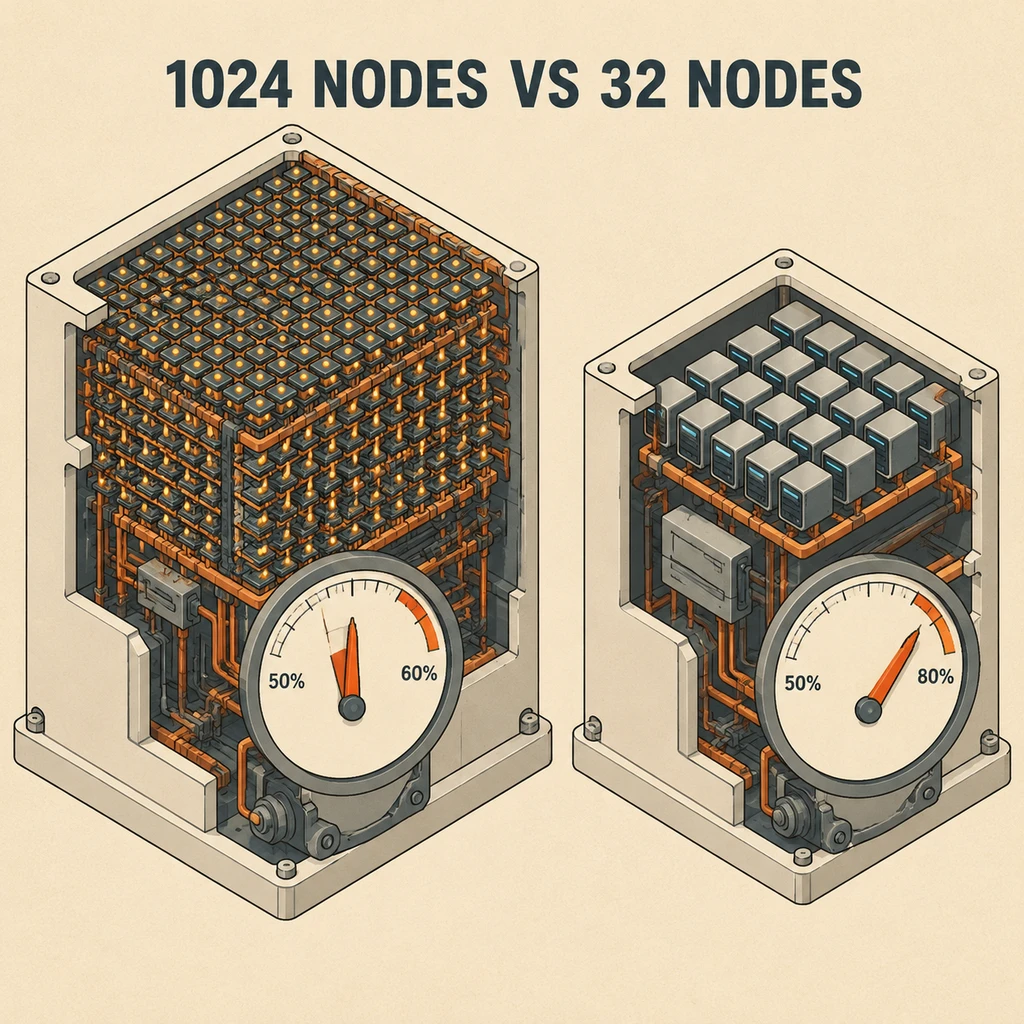
但在唯一完成了 1,024 规模压力测试的 Pandoc 代码重建任务上,性能曲线呈现出了陡峭的边际效用递减:
增加 8 倍的并发节点,最终只换来 4 个百分点的代码质量微调。
论文选择以 6 小时固定时间作为对照标准,这掩盖了工程落地的实际经济账目。1,024 个节点在高并发下同时拉取分支、测试构建并向共享上下文数据库写入日志,其总计消耗的 Token 数量与计算开销未在论文中公开。这种协作本质上是用极高密度的推理调用去换取固定时间内的产出上限。
代码仓库 README 中补充的数据更显示出模型基础能力的权重:改用更新的 GPT-6.1-sol/high 后,单 Agent 通过率就已经达到 56.19%,而仅仅组织 32 个 Agent 协作,通过率就跃升到了 79.59%。这意味着,把算力盲目花在大规模并发节点上,其收益可能远逊于直接调用更聪明的单体模型。
落地鸿沟:单机复现包与物理集群的现实差距
对于普通开发者和企业自动化团队而言,Agensh 是一次极具价值的学术概念验证,但绝非开箱即用的生产力工具。
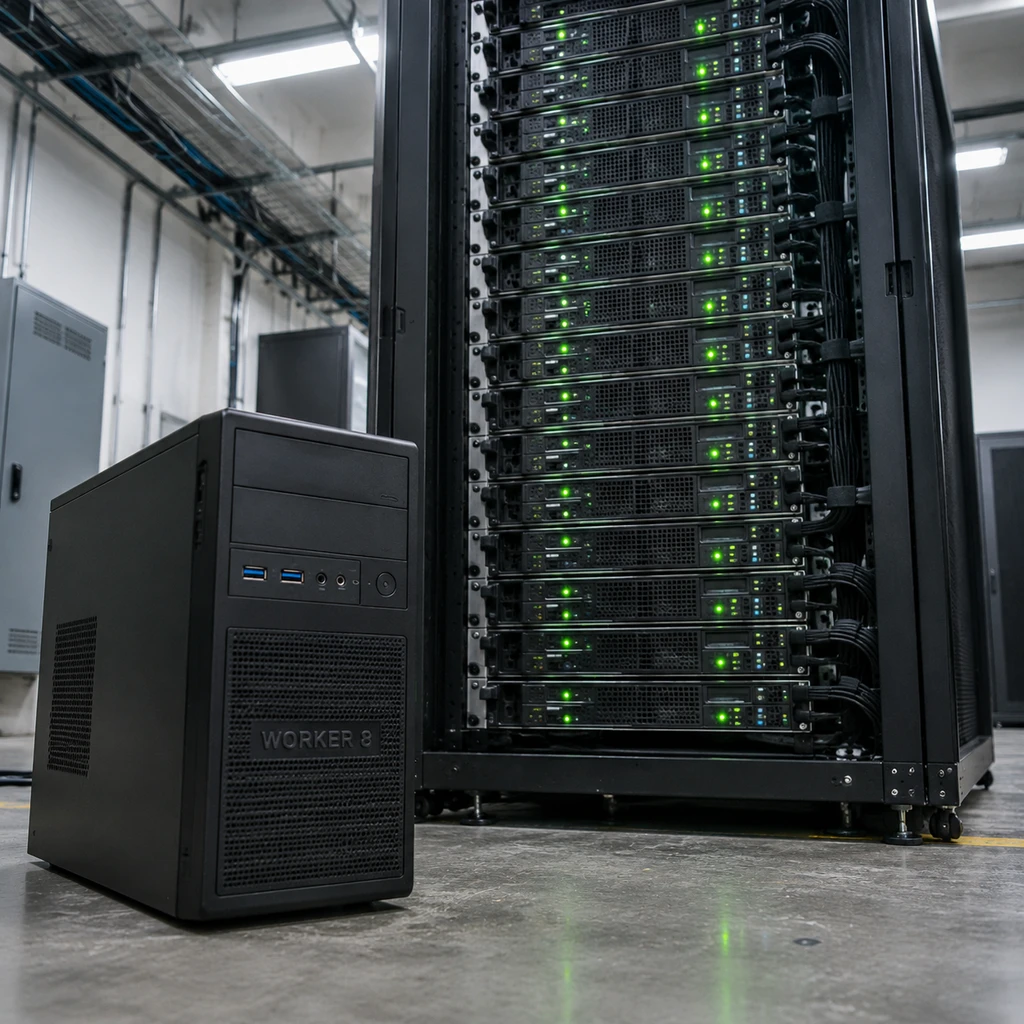
开源仓库目前提供的部署方案存在显著的工程折叠。仓库默认提供的 Docker Compose 配置文件仅支持在单机环境下启动 8 个 worker 节点。而论文中跑通 1,024 智能体的实验环境,实际上搭建在 16 个物理节点 构成的集群之上,每个物理节点承载 64 个 worker。官方在文档中明确提醒,开源环境是基于 v6 cleanroom 镜像重新打包的,团队无法保证第三方在新环境中能完全复现历史成绩。
此外,尽管架构去除了模型层面的调度器,其底层的工程依赖仍然是集中式的。千级节点产生的并发读写直接压在 Gitea 和 Mattermost 单一实例上,代码冲突合并、上下文服务的一致性维护,都会成为传统运维意义上的单点瓶颈。
微软当下在多智能体上的布局意图正在逐渐清晰:一方面将早期探索性质的 AutoGen 归档,引导开发者转向偏向工业化集成的 MAF 框架;另一方面通过 Agensh 在分布式组织协同的极限边界上探路。
- 风险.盲目扩大 Agent 节点规模不仅无法线性提升软件交付质量,反而会引发极其高昂的并发 Token 账单与严峻的集群通信开销。
对软件工程团队来说,Agensh 最大的参考价值不在于立刻部署上千个数字员工,而在于它展示了无需中央编排器的去中心化协议如何运作。在未来很长一段时间内,数十个智能体配合更强基础模型的精细分工,依然会是比千人围殴更具经济可行性的工程解法。