大模型变得越来越聪明,写出来的东西却越来越让人读得费劲。
很多经常和前沿模型对话的人都有类似的感觉:现在的输出信息量确实大,但读起来总有一股说不出的紧绷感,句子很硬,需要大脑倒回去看两遍才能理顺。过去大家普遍认为,模型推理能力越强、参数越新,生成的文字理应越贴近高水平人类写作。arXiv 上最新发表的预印本论文《Why is AI-generated language so hard to understand?》打破了这种想当然的共识。研究测试了 14 款模型,发现以 Claude 和 GPT-5.6 系列为代表的最顶尖模型,底层语言组织正在发生反向异化,越聪明,语法结构反而离人类的阅读习惯越远。
顶尖模型集体患上“高密失语症”
研究团队搭建了一套庞大的跨领域语料库,测试对象包含 9 款前沿及近前沿模型:Claude Sonnet 5、Opus 5、Opus 5.5、Fable 5;GPT-5.6 Luna、Terra、Sol;GLM-5 与 Kimi K2.5,外加 5 款 Llama 和 Olmo 作为对照。语料覆盖了 120 场对话(跨 10 个主题、至多 12 轮交互)、45 次针对 5 个真实代码库的解释,以及 980 篇命题作文,并拿来 2,934 篇人类学生作文 作为对比参照。
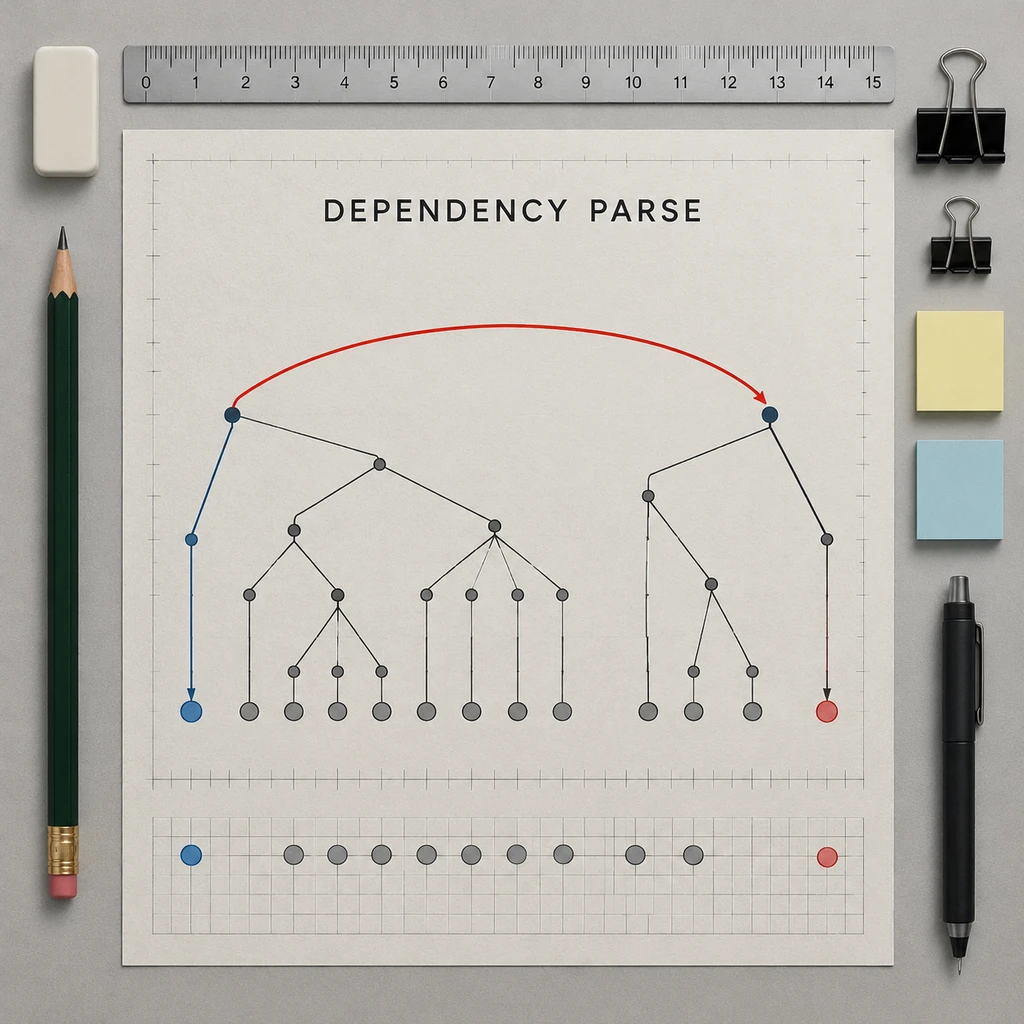
评测结果显示,这 9 款前沿模型无一例外,都在大幅度使用加重人类大脑处理负担的语法特征。
这些特征在心理语言学上有明确定义:一个是超长句法依赖,把主语和真正支配它的谓语拉开很远;另一个是无生命主语搭配动作动词,比如让数据结构、代码文件去主动执行某种人类习惯由人完成的动作;此外还伴随大量的低频词组合、多重名词堆叠,以及在对话中疯狂省略关系代词。
为了剥离这些高难语法,研究人员用 NLLB-200 翻译模型把 AI 文本做了英-日-英双向回译,让机器把怪异的长从句和压缩句洗成平直表达。回译前后的心理语言学特征差异非常惊人。
原始文本与平滑文本的标准差差异在 Opus 5 上飙升到了约 2.1 SD,Fable 约 1.6 SD,GLM-5、Luna 与 Opus 5.5 也在 1.0 SD 左右。回译之所以能抹去这么多结构偏差,是因为人类语言在经过机器中转重组后,会自动落回高频、惯用的平顺轨道。这反过来证明,模型原本吐出来的词句,本身就处于高度反常的张力之中。
谁在逼模型把话写成压缩包
造成这种病态语法的根源,不在于预训练学得不好,而在于后训练的激励导向变了。
人类语言在数万年的演化史里,核心约束是成功交流。人脑的工作记忆容量很有限,我们说话写字必须提供足够的冗余、连接词和结构缓冲,才能让听者的大脑在毫秒级的时间里跟上节奏。
大模型当前的生存环境截然不同。行业竞争的重心全面扑向复杂长链推理、数学解答和写代码。在强化学习(无论是 GRPO 还是基于验证的 RLVR)的考卷上,模型多吐一个没有信息增量的虚词,都要受到严厉的惩罚。字数越少、推理越硬、成本越低,奖励就越高。
模型在底层被迫用排版代码的逻辑来排版自然语言。
研究者在受控环境下做了一组验证实验。他们用 Qwen2.5-1.5B-Instruct 模型训练结构化事件转句子的任务,在 GRPO 算法下引入奖励函数 $R = \text{正确性} \times \text{格式} - \lambda \cdot \text{tokens}$,测试不同的长度惩罚系数。实验运行了 24 次,结果只要不加 KL 正则化约束,模型对省略关系代词“that”等极端压缩形式的偏好度就会迅速超过 98%。
这意味着只要给模型施加压缩长度和提高单位密度的压力,它就会本能地阉割语法连接,把复合句压缩成堆满名词的硬块。专门强调深度思考的 Olmo Think 在评测中表现出了和顶尖闭源模型几乎相同的特征,而普通 Base 或 Instruct 模型回译前后的变化极小。推理模型的强化学习机制,本质上是在用人脑的阅读体验换取机器的逻辑密度。
结论可信,但证据链并非无懈可击
论文给出的机制解释非常符合当下 AI 训练的工程直觉,但如果用严格的实证标准去审视,这项研究依然存在几处不容忽视的证据断层。
第一,整篇论文测量的是心理语言学的代理指标,并没有做任何针对真人受试者的阅读测试。无论是长句法依赖还是无生命主语,在认知科学上确实意味着大脑需要调动更多短期记忆,但这不等于人类真正读不懂,更不能直接折算成阅读错误率上升。
第二,对照基准存在天然偏差。研究者拿来和 AI 对话做对比的人类语料是影视字幕,对照 AI 代码解释的是 StackExchange 问答,对照论文的是学生习作。这些人类文本在写作目的、受众预期上和 AI 面对特定提示词时的语境并不完全对等。此外,NLLB-200 回译工具本身就带着向平庸、常见语法归拢的倾向,用它作为标尺去丈量偏差,测量工具本身就带有放大镜效应。
第三,Qwen2.5 上的长度惩罚确实证明了压缩能改变表层代词的取舍,但并不能完全等同于顶尖商业模型内部复杂的强化学习全貌。闭源黑盒模型到底是因为长度惩罚才变成这样,还是单纯因为吸收了过多代码和技术规范文本,目前依然无法给出板上钉钉的历史因果定论。
- 提醒.不要把文本认知负荷指标直接等同于沟通无效,它目前更像是一种阅读疲劳度的预警信号。
有趣的是,模型家族内部已经出现了自我修正的迹象。在 21 项与认知难度挂钩的指标对比中,最新的 Claude Opus 5.5 有 19 项指标低于 Opus 5。Anthropic 很可能已经意识到上一代旗舰模型语风过于晦涩,在后训练对齐时悄悄调低了极端压缩的权重。
当越来越多企业开始用大模型自动生成技术文档、系统总结和协同邮件时,这种语法异化带来的摩擦会成倍放大。天下难事必作于易,天下大事必作于细。如果一个模型在数学基准上拿了满分,写出来的汇报却让读它的工程师头昏脑涨,那么省下来的生成成本,最终只是转嫁成了人类组织的理解损耗。