芯片初创公司 Cerebras 在 2026 年 10 月 22 日公布了一套技术推演方案,试图打破万亿参数大模型面临的显存墙。作者 Sarah Chieng 在官方报告中,以月之暗面开源的 3 万亿参数模型 Kimi K3 为标靶,详细拆解了如何用 59 片 WSE-3T 晶圆级芯片 搭建流水线,并喊出每秒生成 1000 至 2000 个 token 的惊人速度。
这一设想在工程设计上极其精巧,但它目前依然停留在理想化教学推演的图纸阶段。对于被推理延迟拖垮的开发团队而言,这套方案证明了晶圆级片上高速缓存应对超长文本的可行性,但也暴露出单芯片容量极限下的残酷妥协:为了换取极端的单流生成速度,系统牺牲了主流数据中心赖以生存的并发承载力与采购经济性。
单片 44GB SRAM 的突围:解构 59 片晶圆的装配线
万亿参数大模型的推理核心痛点在于内存墙。传统 GPU 集群通常把模型权重打散存放在高带宽内存(HBM)中,每次生成一个词都要全量搬运一次权重,导致单用户交互的生成延迟居高不下。Cerebras 的底层逻辑截然相反:它依靠单颗面积巨大的晶圆芯片,直接在片上集成高带宽、低延迟的 SRAM 静态随机存取内存。
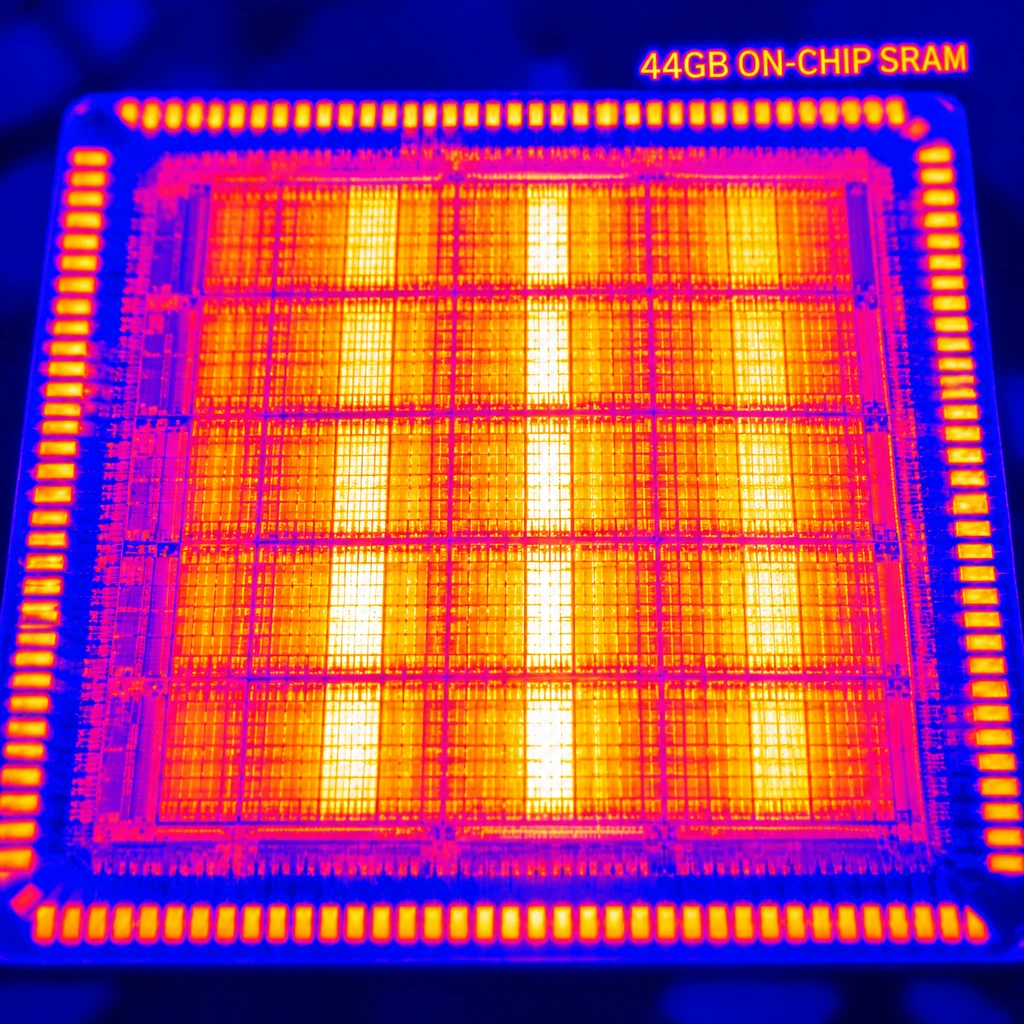
然而,一片 WSE-3T 的片上内存仅有 44 GB。面对万亿级模型动辄数 TB 的体量,单片芯片根本塞不下完整权重,Cerebras 只能采用类似汽车装配线的流水线并行方案。
在这一架构中,权重完全固定在晶圆本地,晶圆之间通过以太网 RDMA 进行互联,仅需传递微秒级的激活值,单跳延迟约在 2 微秒。输入提示词如传送带上的零件,从第 1 片晶圆流经第 59 片晶圆,每个计算周期由最后一片吐出一个新 token。
纸面均匀切分与真实 MoE 架构的落差
Cerebras 给出的数学模型干净利落,但这很大程度上建立在一个脱离工程现实的简化假设上:它假定 3 万亿参数被均匀削成 4-bit 并等分给 93 个层级,每层不多不少恰好占据 16 GB。
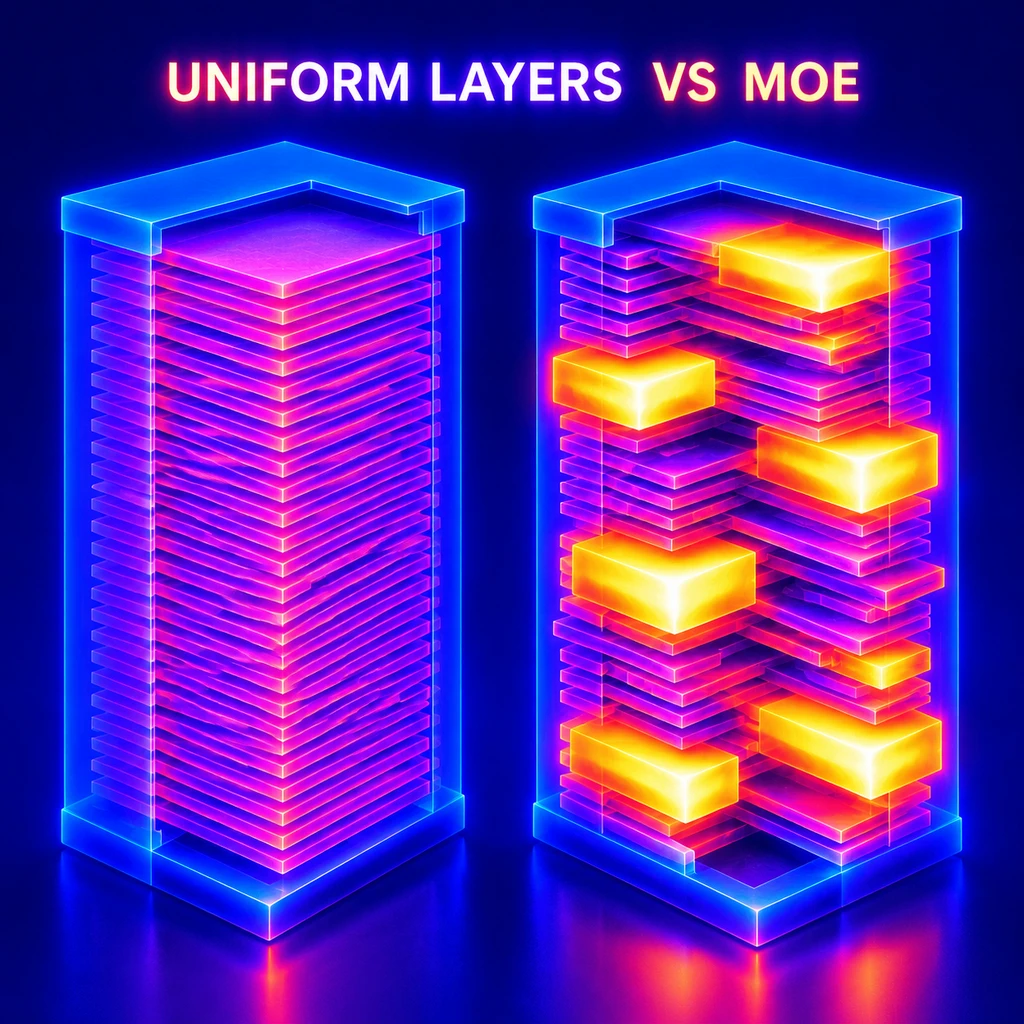
翻开月之暗面在 Hugging Face 开源的 Kimi K3 官方技术卡,真实的模型构造要复杂得多。Kimi K3 的实际总参数为 2.8 万亿,激活参数为 1040 亿,是一套标准的混合专家(MoE)结构。整套架构由 69 层 Kimi Delta Attention 与 24 层 Gated MLA 混合构成。更关键的是,K3 仓库中的配置文件显示,其量化策略采用组大小为 32 的 mxfp4-pack-quantized 格式,但对注意力层、共享专家、LM Head 和视觉组件明确做了量化排除,并非全量均匀 4-bit。
这种非均质设计直接动摇了 59 片晶圆的装配假设:
- 提醒.如果核心模块保留高精度,关键层的显存占用将大幅超出 16 GB,迫使系统进一步拆解层结构或增加晶圆用量;若强行整体压制为 4-bit,模型推理质量难免受损。
在实际运行数据上,截至 2026 年 10 月底,行业内尚无第三方机构针对 Cerebras 部署 Kimi K3 的端到端实测跑分。独立分析机构 Artificial Analysis 曾在 2026 年 5 月 6 日测得 Cerebras 私有云端点运行上一代 Kimi K2.6 达到 981 tokens/s。这一历史跑分印证了 Cerebras 在相对较小模型上的单流性能,但面对包含非量化组件的 3 万亿级别混合架构,59 片晶圆的纸面推导仍待现实检验。
极速单流交互对垒 GPU 吞吐经济学
评价一套大模型推理系统,不能只看仪表盘上的极速读数,更要看吞吐账本与综合功耗。Cerebras 追求的 1000 至 2000 tokens/s,瞄准的是对实时生成要求极高的特定任务,如长文本即时归纳或自动化智能体交互。然而,数据中心买单者考量的核心指标始终是聚合吞吐与每 token 成本。
根据 SemiAnalysis InferenceX 在 2026 年 10 月 23 日公布的基准数据,由 Blackwell 架构组成的 NVIDIA GB300 NVL72 集群在运行 Kimi K3 时,单 GPU 聚合吞吐量可达 8,240 tokens/s(在 100 tokens/s 延迟目标与 FP4 精度下),综合推理成本估算低至每百万 token 0.078 美元。
而在开源框架一侧,vLLM 官方测试表明,即使在无投机采样的 16 张 GB300 上,K3 的单用户生成速度仅为 118 tokens/s,但一旦开启 DSpark 投机解码,单流速度也能抬升至 370 tokens/s。
两者的冲突并不在于谁跑得更快,而在于各自对应的商业现实。
极速单流是交互层面的奢侈品,并发吞吐才是云计算底层硬通货。
Cerebras 设想了一个 256k 平均上下文的极限场景。在此类长文本负载下,仅有的 24 片稠密注意力晶圆需要分担全部 KV Cache。即使通过线性注意力减免了大部分层的状态缓存,剩下每片芯片留给缓存的 SRAM 也只有 28 GB。流水线必须依靠源源不断的微批次请求维持各晶圆满负荷运转,一旦并发规模受限于片上物理空间,整座流水线便会频繁陷入停工等待。
从纸面逻辑迈向机房部署,Cerebras 确实提供了一种避开 HBM 带宽钳制的工程样本。但对于准备采购算力的云基础设施买家来说,单纯的单流读数不足以支撑昂贵晶圆阵列的采购审批。
真正的分水岭,在于后续第三方独立机构能否在相同的上下文长度、真实的非均匀量化条件以及严苛的 P95 延迟要求下,披露 59 片晶圆阵列的实际整机功耗与并发成本。在这些真实约束得到验证前,主流平台依然会把预算留在兼顾通用吞吐与生态弹性的 GPU 方案上。