背完一部动漫里最常用的 500 个单词,词频软件会显示你已经掌握了全片 85.9% 的词汇。泡好茶按下播放键,结果连听三句台词,每句都卡在一个生词上;等查完字典,茶已经凉了。语言学习工具团队 learnfromx 用 Python 3.13.7 和分词器 SudachiPy 0.6.11 拆解了《葬送的芙莉莲》(Frieren)等 8 部日本动画的前 3000 行字幕,算出一组刺眼的数字:掌握前 500 个高频词,实际能完整听懂的台词只有 38.4%。
市面上主流的日语学习网站,比如 JPDB、Jiten 和 manga-kotoba,都喜欢把词汇覆盖率(Token Coverage)摆在最显眼的位置。这个指标的算法很容易让人产生幻觉:它按单词出现的总次数计算。在《葬送的芙莉莲》前 3000 行台词里,共有 2448 个不重复的独立词汇;排在最前面的全是「の」「は」这类语法助词,一个词出现上千次就累计上千次。只背前 100 个高频词,词频覆盖率就能冲到 68.3%,但你能完整看懂的台词只有 8.5%。
为什么 86% 的覆盖率救不了半部番
从 85.9% 掉到 38.4%,吞掉理解力的是单句的木桶效应。
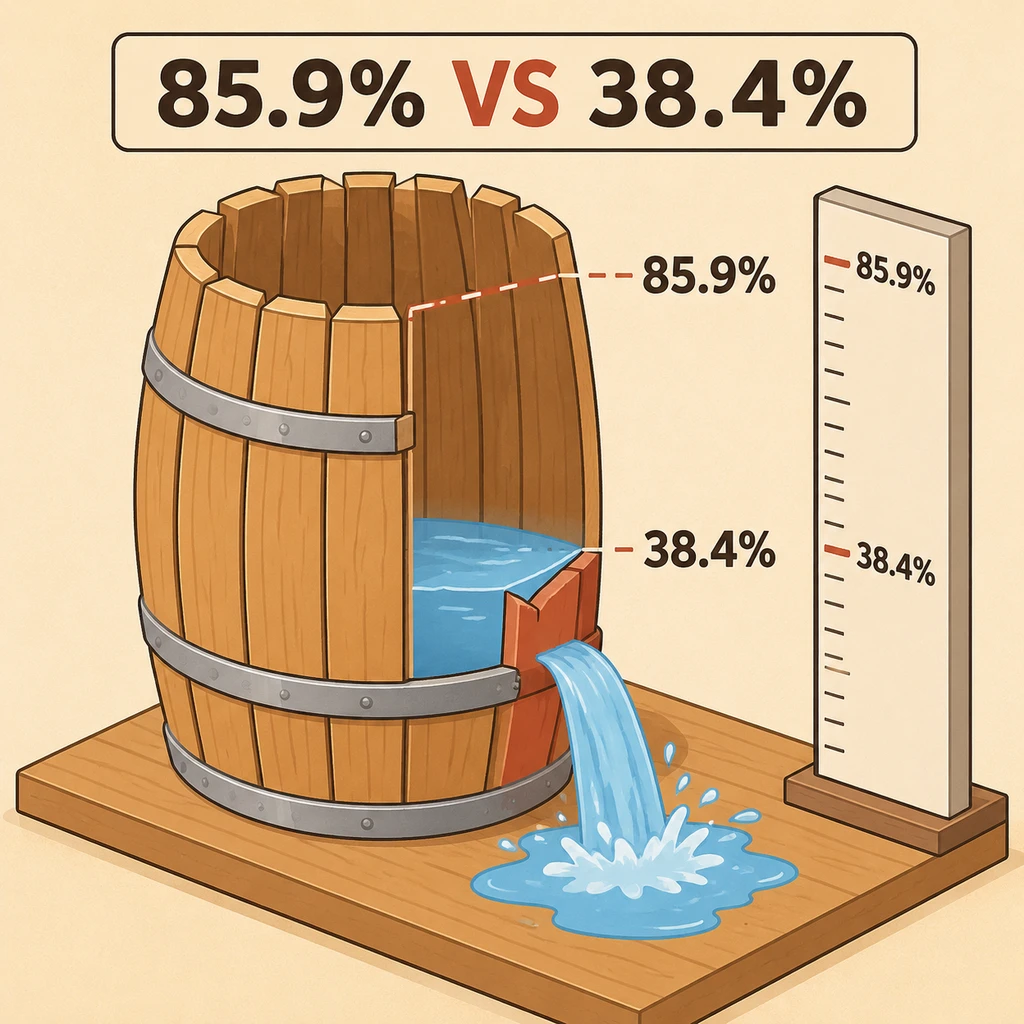
《葬送的芙莉莲》平均每行台词有 7 个词。要想不查字典听懂一整句话,这 7 个词你得全部认识。在 85.9% 的单字命中率下,连续 7 个词全认识的数学概率是 0.859 的 7 次方,算下来大约是 35%,和实测的 38.4% 几乎吻合。语言学界早就给过更严苛的门槛:95% 的词汇覆盖率才算具备推断性听力理解的基准,而要想顺畅做深度理解,这个数字得推到 98%。
不同作品的词表结构,决定了啃生肉的起步门槛天差地别。learnfromx 用同一套清洗标准(剔除标点、专有名词、语气词和歌曲,按词典原形归并)横向测算了 8 部热门动画:
| 动画名称 | 独立词汇数 | 500 词覆盖率 / 整句理解率 | 看懂一半台词所需词汇 |
|---|---|---|---|
| Serial Experiments Lain(玲音) | 1,924 | 88.0% / 55.9% | 401 |
| Dororo(多罗罗) | 2,431 | 85.2% / 42.1% | 633 |
| Chainsaw Man(链锯人) | 2,203 | 86.3% / 41.1% | 647 |
| Frieren(葬送的芙莉莲) | 2,448 | 85.9% / 38.4% | 730 |
| Death Note(死亡笔记) | 2,529 | 86.6% / 36.0% | 782 |
| Jujutsu Kaisen(咒术回战) | 3,028 | 81.5% / 32.7% | 980 |
《玲音》是这批样本里最友好的一部,台词短、用词集中,背 401 个词就能听懂一半句子,1191 个词就能摸到 95% 的学术及格线;到了《咒术回战》,光看懂一半台词就得准备 980 个词。
进度条背后的指标算计
我不太买账的是各类语言学习软件对覆盖率指标的包装。
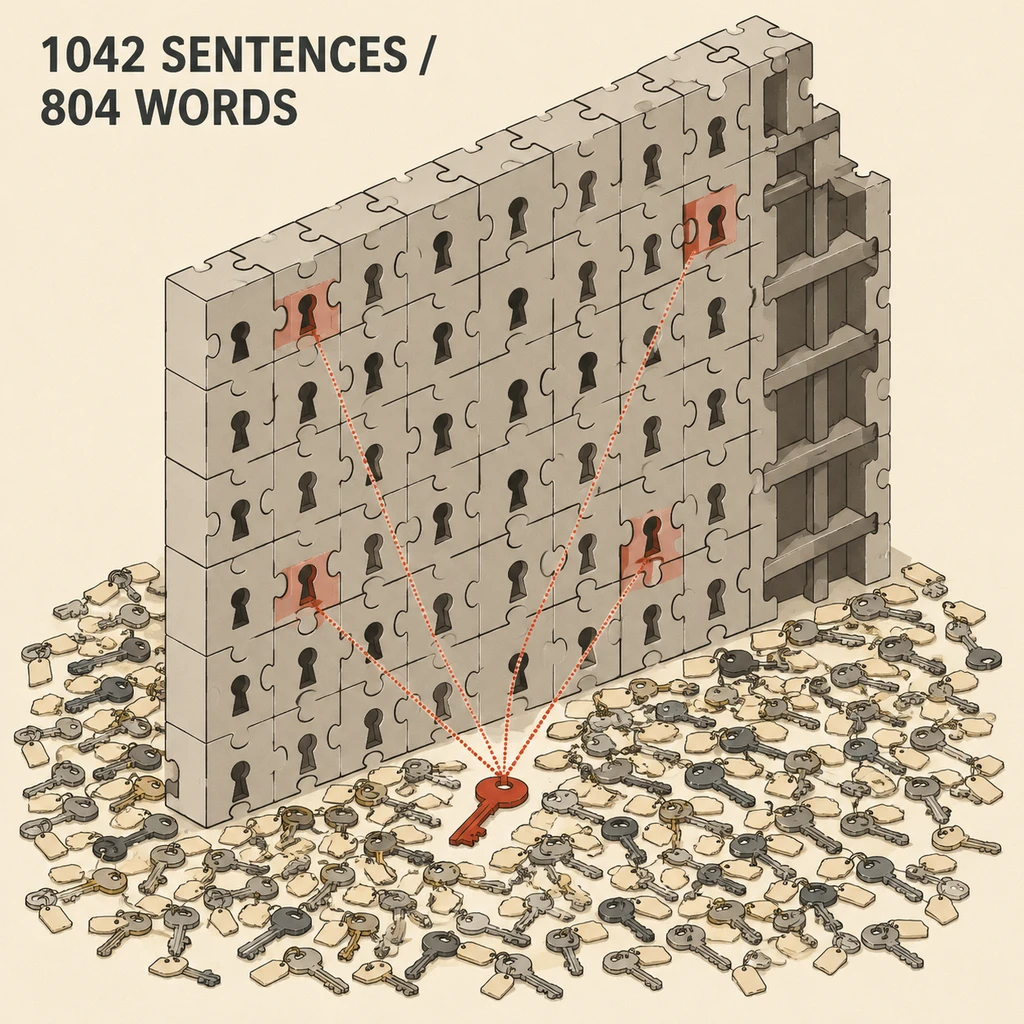
面板卖的是进度幻觉,听力考的是木桶短板。
过去几年,背词软件和刷题社区把古德哈特定律演绎得很彻底——当一个指标变成目标,它就不再是个好指标。平台喜欢展示词频覆盖率,因为它的曲线前陡后平:新手背几百个词,进度条就能飙过 80%,正反馈极强,留存率和付费转化自然好看。而且 JPDB、Jiten 各家对黑名单、专有名词和词形还原的算法各自为政,用户在 A 平台看到的 90%,换个平台根本没法横向对齐。
真正在学语言的人,迟早要面对两堵被进度条藏起来的墙。
第一堵墙是专有语境的长尾分散。在《葬送的芙莉莲》听不懂的那 1849 句台词里,有 56.4%(1042 句)其实只差最后一个生词。但你没法靠突击十几个高频词把它们一次性扫平——这 1042 句台词里缺的词,分散在 804 个不同的低频词上,背会「約束(约定)」或「後悔(后悔)」,每个词最多也就能帮你多解锁 4 句台词。从 500 词扩充到 1000 词,面板上的词频覆盖率只涨了 6.5 个百分点,但整句理解率能暴涨 22.1 个百分点。
拿通用词表去硬撞垂直作品同样吃亏。用日常日语最常用的 2000 词去测这 8 部动画,只能看懂 23.4% 到 37.6% 的句子;但如果直接背该动画自己的前 2000 词,整句理解率能拉升到 74.3% 至 93.3%。毕竟在芙莉莲的世界里,「魔法」排在第 21 位,比「私(我)」还靠前 4 位;连「生臭坊主(酒肉和尚)」都能排进第 304 位。哪怕背熟了前 3000 行的词表,到了后 3000 行进入魔法使考试篇,「試験(考试)」这个词突然从出现 1 次暴增到 51 次,旧词表的整句覆盖力立刻会掉下去 10.7 个百分点。
第二堵墙更隐蔽:一词多义与惯用语。《荀子·劝学》讲「诵数以贯之,思索以通之」,光靠机器数词频,连字面意思都未必通得了。在脚本统计里,只要你认识「手」,那么「手が震えています(手在发抖)」和「手に取るように分かる(了如指掌)」这两句都会被判定为已掌握。实际上,第二句照字面翻译成「像拿在手里一样明白」,没学过这个惯用句型的人照样一头雾水。如果把词性变化和原形拆开算(比如把「行った」和「行く」算作两个词),500 词的整句理解率还会再往下掉 5.3 到 7.7 个百分点。
- 提醒.38.4% 已经是脚本里的乐观上限。真实看番时,角色语速、连读弱化、省略主语的口语语法,都会继续压低这个数字。
learnfromx 做这组测算,底牌其实是为自家的闪卡应用铺路:与其盯着虚高的总词频,不如直接挑出那些「全句只差一个生词」(即 i+1 原则)的真实台词做成卡片,连带把同一个词的不同词义拆成独立卡片来练。这算是把准了痛点。下一次打开学习软件,看到进度条上亮起 85% 的高分时,别急着泡茶;先看看剩下的 15% 里,藏着多少句一词卡死整行的台词。