给一个网页链接,4 分钟吐出一条 1080p 30fps 的高清产品短视频,整条管线里完全没有视频大模型。
开源项目 LaunchVideo 展示的正是这种反直觉的工程设计:没有 Sora 或 Runway 的扩散算法,也不烧昂贵的 GPU 显存,它让 Claude Opus 5.5 负责写出带有动画的前端代码,再扔进一个无服务器微虚拟机里,靠无头浏览器切帧拼出视频。
主流 AI 视频工具都在死磕写实光影与物理规律,LaunchVideo 却掉头用几十年前就成熟的浏览器排版与音视频编码技术,做出了像素级精准的软件演示片。它不是模型能力的奇迹,而是一次极为老练的工程借道。
没有扩散模型,它是怎么把代码变成视频的
LaunchVideo 的核心产出物不是连续的潜空间像素,而是写在 HTML 和 CSS 里的动效逻辑。整套系统的生产流程由一个 TypeScript 编写的智能体调度,配合三个极简工具完成全套动作。
输入产品 URL → 抓取页面要素 → Claude Opus 5.5 编写动效代码 → microVM 虚拟时钟渲染 → 导出 MP4当用户输入一个网址,抓取工具会提取站点的文案、标题层级、最高频的主题色值以及对应的谷歌字体。随后,大语言模型开始接管原本属于动效设计师的工作,直接输出包含完整页面布局与过渡动效的 Web 代码。
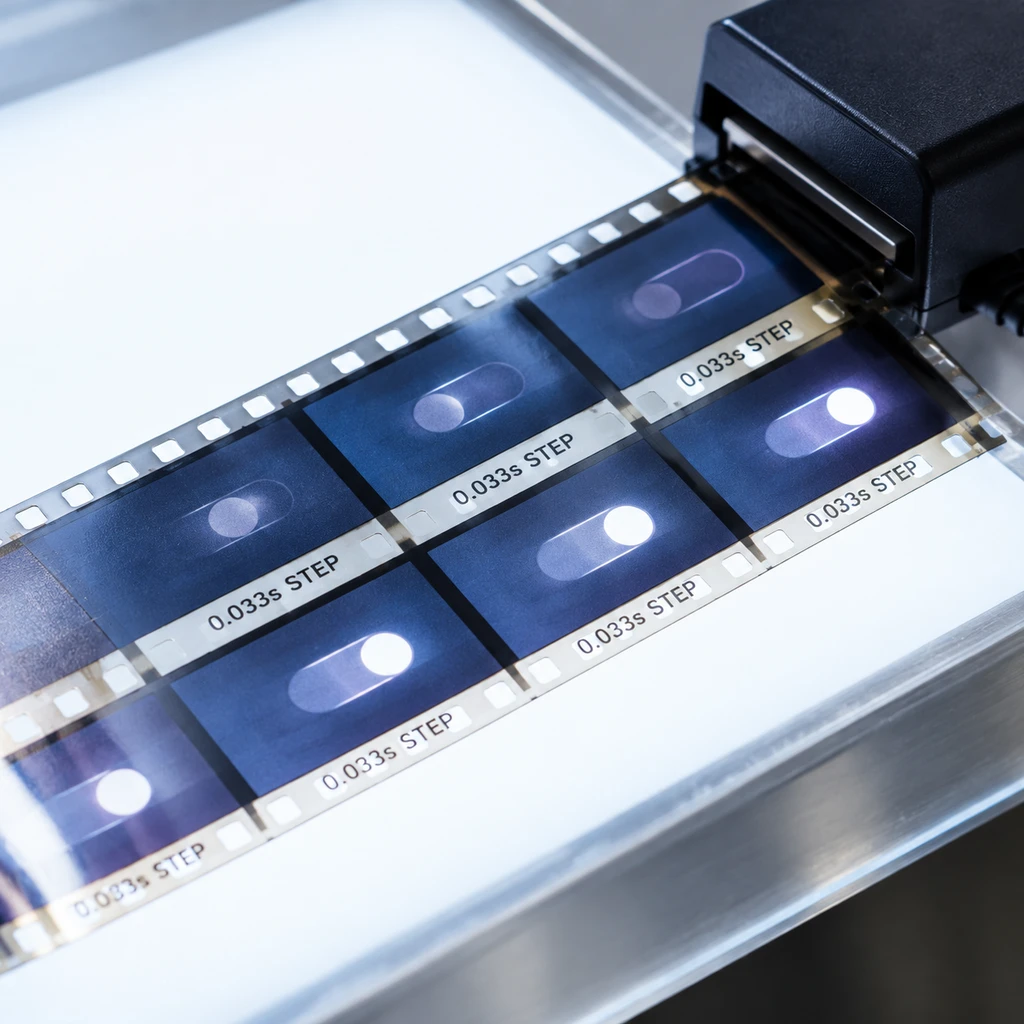
接下来的渲染环节才是整套方案最精巧的地方。普通网页如果直接录屏,受制于 CPU 调度、字体加载与脚本解析,极易出现掉帧、卡顿或微小的异步误差。LaunchVideo 部署在 OpenComputer 的无服务器环境中,运行在一个配置为 4 核心 vCPU、8GB 内存的 Amazon Linux 微虚拟机内。它在启动无头 Chromium 后,直接用虚拟时钟重写了浏览器的底层计时器。
浏览器原本依赖的动画刷新机制、定时器乃至系统日期全部被虚拟化。时间不再自动流逝,而是变成了离散的刻度。系统让时钟跳跃固定间隔,截取一张图片,再跳跃、再截取。无论宿主机负载如何波动,每一帧画面的渲染都是百分之百确定的。最后,这些静态图片被推入静态编译的 FFmpeg 中,采用恒定速率因子压制成标准的 MP4 格式,上传并销毁虚拟机。整个容器生命周期随用随弃,不留常驻服务。
像素精度的胜利,与尚未结清的算力账本
当工业界还在忍受扩散模型把操作界面扭曲成超现实油画时,LaunchVideo 展现出了一种近乎降维打击的清晰度。
在当前的视频生成市场中,Runway 主打运镜与电影感特效,计费采用基于分辨率与时长的点数制;HeyGen 与 Synthesia 则扎根于数字人出镜、口型同步和多语言营销,本质上是企业播音员。这两条路线在面对复杂的软件工作流演示时都显得力不从心。扩散模型无法理解什么是按钮组件,字号一旦变小就会出现不可读的乱码;数字人则只能站在画面一角念稿,缺乏对软件界面动效的呈现能力。
用代码当画笔,天然消解了视频大模型的文字幻觉与几何畸变。
前端代码天然具备可维护性。颜色不对可以改变量,文案拼错可以改字符串,动效节奏太快可以微调持续时间。每一处像素在被浏览器解析时都严格遵循标准,无需祈祷提示词能碰对随机种子。
不过,这项工程并非没有代价。网络上传言该方案单次生成的成本仅约 2 美元,但这个数字目前只停留在口头测算阶段,并未经过公开审计的完整账单核实。从实际开销来看,生成一部通常只有 20 到 40 秒 的短视频,需要消耗约 9 万输入 Token 与 1.5 万输出 Token。
为了确保排版不报错,系统需要将抓取的数据、复杂的动效代码模板、控制时钟的辅助脚本以及校验上下文完整注入模型上下文。这种巨额的 Token 消耗,再加上包含安装依赖在内的 4 分钟虚拟机运行时间,决定了它目前不是随手即用的廉价玩具,而是一笔需要精准核算的工程开销。
动效的繁荣,遮不住解释力的匮乏
抛开极客式的工程巧思,冷静审视 LaunchVideo 产出的成片,会发现一个明显的落差。
原作者将这类产物归为解释类视频,但在真实的产业实践中,它距离真正的概念教学相去甚远。LaunchVideo 目前交付的内容,更像是一套被现代排版引擎驱动的高级动态幻灯片。它通过华丽的缓动曲线、大号无衬线字体与高饱和度配色抓人眼球,本质上是 SaaS 软件在社交平台上打响名头所用的营销切片。
教学视频的核心在于认知传递,需要根据学习者的知识结构层层剥离逻辑,提供具有上下文一致性的步骤拆解。目前的行业测评指出,这项技术缺乏量化衡量教学质量的基准标准,大语言模型只是在机械地把提炼出来的卖点转化成视觉运动,并没有真正理解产品背后的技术闭环。
不仅如此,字体授权的合规边界、未标明出处的视觉素材,以及缺乏真实屏幕录制的纯 CSS 伪造界面,都在限制它走向严肃的产品交付。它可以在推特上引发开发者阵阵赞叹,但如果把它放进企业严肃的知识库或上线培训中,这种形式大于内容的动效很可能会分散使用者的注意力。
- 风险.代码渲染绕开了画质畸变,却没绕开逻辑编排的硬门槛;动效可以由大模型代写,但对产品价值的深度解构,仍取决于人类提示词的构思上限。
大模型接管视频制作的方式,并不只有死磕物理世界这一条死胡同。LaunchVideo 给整个行业提了个醒:面对软件演示这种重逻辑、重文本、重排版的垂直场景,把大语言模型的代码生成能力与老派的无头浏览器、虚拟时钟拼在一起,就能以极具确定性的方式撕开一道缺口。
这场尝试不是视频模型的胜利,而是一次工程编排对算法神话的降维打击。当模型开始懂得调度编译器与浏览器,所谓视频生成,不过是一场早已写好脚本的确定性寻帧。