把大模型装进眼镜,行业已经讲了两年故事,但大部分产品不过是装了摄像头的云端麦克风。
加州理工学院研究人员创立、加州大学伯克利分校教授 Ion Stoica 担任顾问的 AI 实验室 PrismML,在高通 Snapdragon 峰会上拿出了实质动作:他们将一个 2B 参数的 Bonsai 多模态视觉语言模型,直接跑在了高通第一代 Snapdragon AR1 Gen 1 智能眼镜芯片上。
很多人以为这只是一次常规的离线模型精简,但这次实验的真正底牌在于极限比特量化。模型由 1.7B 参数的 1-bit 语言模型与 0.3B 参数的 4-bit 视觉编码器组成,在 4 GB 系统内存的眼镜平台上,把大模型装进方寸之间。
极限比特压缩下的硬件账本
智能眼镜最大的物理铁律是重量与散热。镜架空间无法容纳大容量电池,更承受不住高发热芯片贴在太阳穴上的温度。过去业内普遍认为,端侧跑文本大模型尚可勉强,运行多模态视觉模型则是天方夜谭。
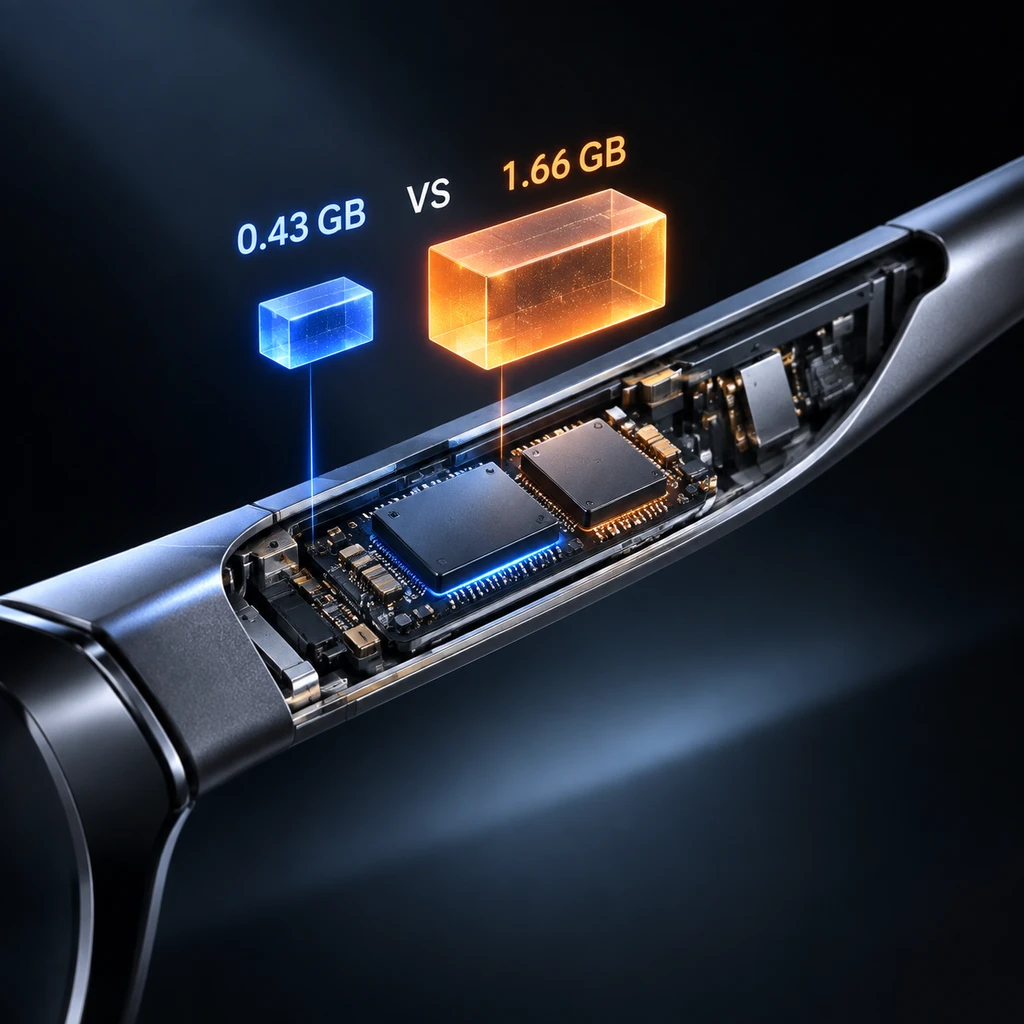
PrismML 击穿这一限制的核心手段是 1-bit 权重表示。
该模型的 1.7B 语言部分权重内存占用被压缩至 0.43 GB。相比同等规模 4-bit 模型所需的 1.66 GB,显存占用直接砍掉了 74%(相当于显存占用降低 3.83 倍)。在 4 GB 运行内存的 Snapdragon AR1 Gen 1 测试机上,配合高通内部编译的 1-bit 内核 QNN SDK,模型推理速度达到了 15.36 tokens/秒,大约每 token 耗时 65 毫秒,吞吐量比 4-bit 方案高出 2.06 倍。
在通用测试基准上,PrismML 宣称该 1-bit 模型在 BFCL v3、HumanEval+、MMLU Redux、IFEval、IFBench、MuSR、GSM8K 及 GPQA Diamond 等指标上,达到了与 4-bit Qwen 3 1.7B 相当的水准,同时支持 1,024 tokens 的上下文窗口。
| 评估指标 | 4-bit 基准模型 | PrismML 1-bit 模型 | 实际变化幅度 |
|---|---|---|---|
| 1.7B 语言权重内存 | 1.66 GB | 0.43 GB | 显存占用缩减 74% |
| 推理吞吐速度 | 7.44 tokens/s | 15.36 tokens/s | 速度提升 2.06 倍 |
| 每 Token 生成耗时 | 约 134 毫秒 | 约 65 毫秒 | 延迟明显缩短 |
| 评测基准表现 | Qwen 3 1.7B 基准 | 对标 4-bit 表现 | 性能基本持平 |
从纸面参数看,这是一次极其优异的系统工程优化。但这块标称峰值算力 6 TOPS、每时钟周期 2,304 次 MACs 计算的芯片,在实验室之外面临更苛刻的考量。
实验室数字背后的隐性代价
我更在意的是官方公告里隐去的数据。
15.36 tokens/秒只是生成间隔,绝不等于用户佩戴眼镜时的端到端响应体验。在真实世界里,用户发问后,设备必须经历图像传感器曝光、视觉编码器特征抽取、前置意图分析,最后才是语言生成并转成语音合成播报。这一整套管线的端到端延迟,公告并未公布。
更关键的是功耗。眼镜贴近头部,散热主要依赖微小的被动铝合金框架传导,电池容量通常只有 100 至 200 毫安时。持续运行 6 TOPS 峰值负载的 NPU 和高频数据搬运,会以极快速度抽干电池并造成镜腿发烫。
- 风险.官方尚未披露真实功率(瓦数)与续航损耗,若单次多模态查询导致机身温度骤升,这种端侧方案短期内便难以支撑全天候常开感知。
这也是为什么目前没有一家硬件品牌正式发布搭载 PrismML 的量产智能眼镜。
云端巨头与安卓同盟的路线博弈
这场技术展示并不是一家初创公司的单打独斗,而是高通试图复制移动时代安卓生态对抗苹果故事的最新一幕。
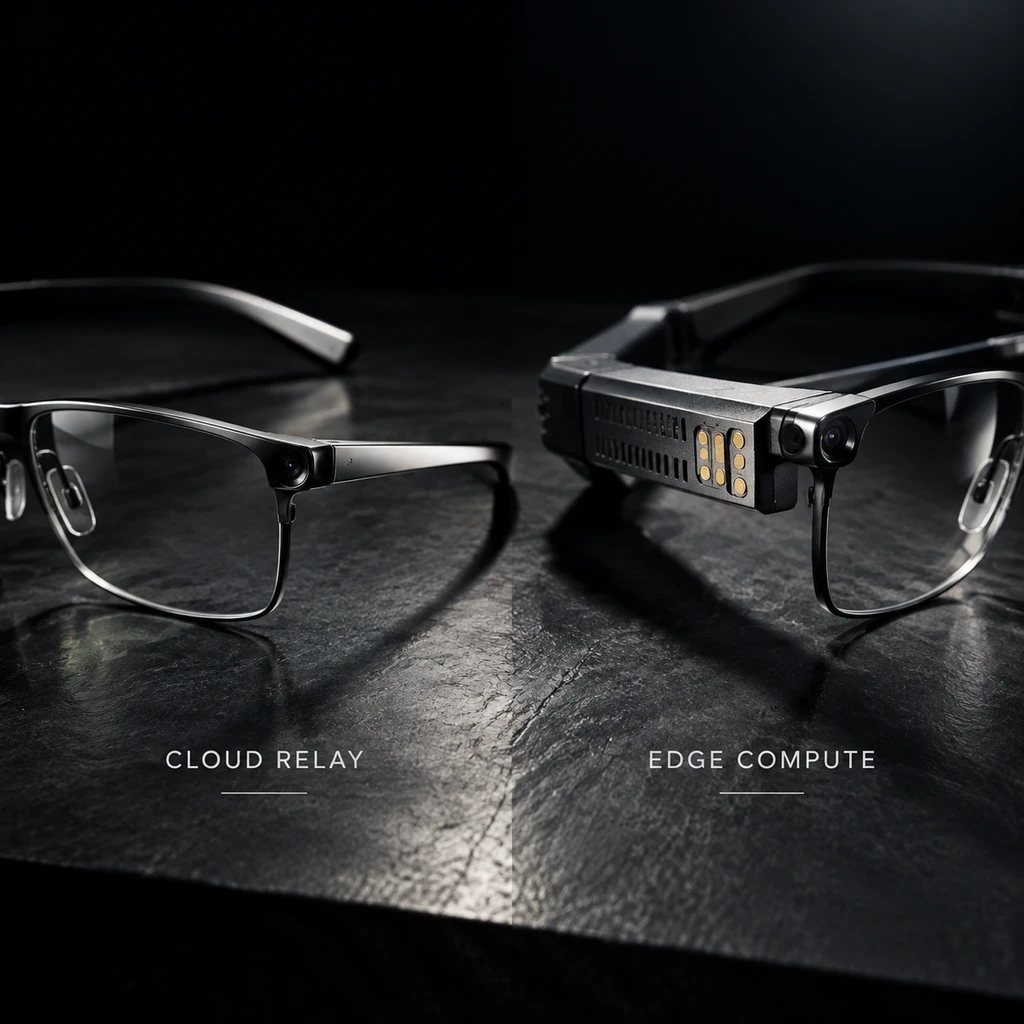
智能眼镜赛道当前的领跑者是 Meta。Meta Ray-Ban Gen 3 起售价 449 美元,提供 9 小时综合续航;纯音频版的 Ray-Ban Meta Audio 起售价 349 美元,续航达 12 小时。它们配备 12 MP 相机,但在架构上选择了一条轻巧路径:眼镜只做传感器采集与语音中继,把复杂的视觉与语言推理全交给云端的 Muse Spark 大模型处理。
尺有所短,寸有所长;端侧图隐私与瞬时响应,云端揽博学与深度推理。
Meta 拥有庞大的数据中心、社交图谱与订阅生态,承担得起云端推理的算力账单。但对接入高通生态的众多第三方硬件 OEM 而言,每一笔打到云端的 API 调用都是沉重的运营负债。
高通曾于 2025 年 6 月在 Snapdragon AR1+ Gen 1 上演示过无需手机中转的本地 Llama 1B 纯文本助手,如今扶持 PrismML 推进 2B 视觉语言模型,意图非常清晰:高通必须向硬件厂商证明,不靠 Meta 的云端帝国,安卓阵营用现有的 AR1 芯片也能做出具备独立智能的眼镜。
然而,端侧自治与云端主导并不是非此即彼的对立。
一个 2B 参数的视觉模型即便量化水平再高,受制于参数容量与 1,024 上下文限制,它能胜任的也仅仅是第一视角的即时物体识别与短句问答。面对复杂的长程规划、深奥逻辑或跨应用调度,它依然无能为力。
- 结论.智能眼镜的真正分水岭不是消灭云端,而是分工进化。未来的标准解法大概率是端侧 1-bit 小模型负责低功耗唤醒、敏感情境过滤与毫秒级视觉快筛,手机与云端超大模型处理复杂推理。
PrismML 证明了 1-bit 模型在第一代 AR1 芯片上的可行性,这一步足够扎实。但要让这项技术真正走出实验室、稳稳架在消费者的鼻梁上,高通和算法团队接下来要拿出的,不能只有基准跑分,必须包含真实的续航与温度数据。