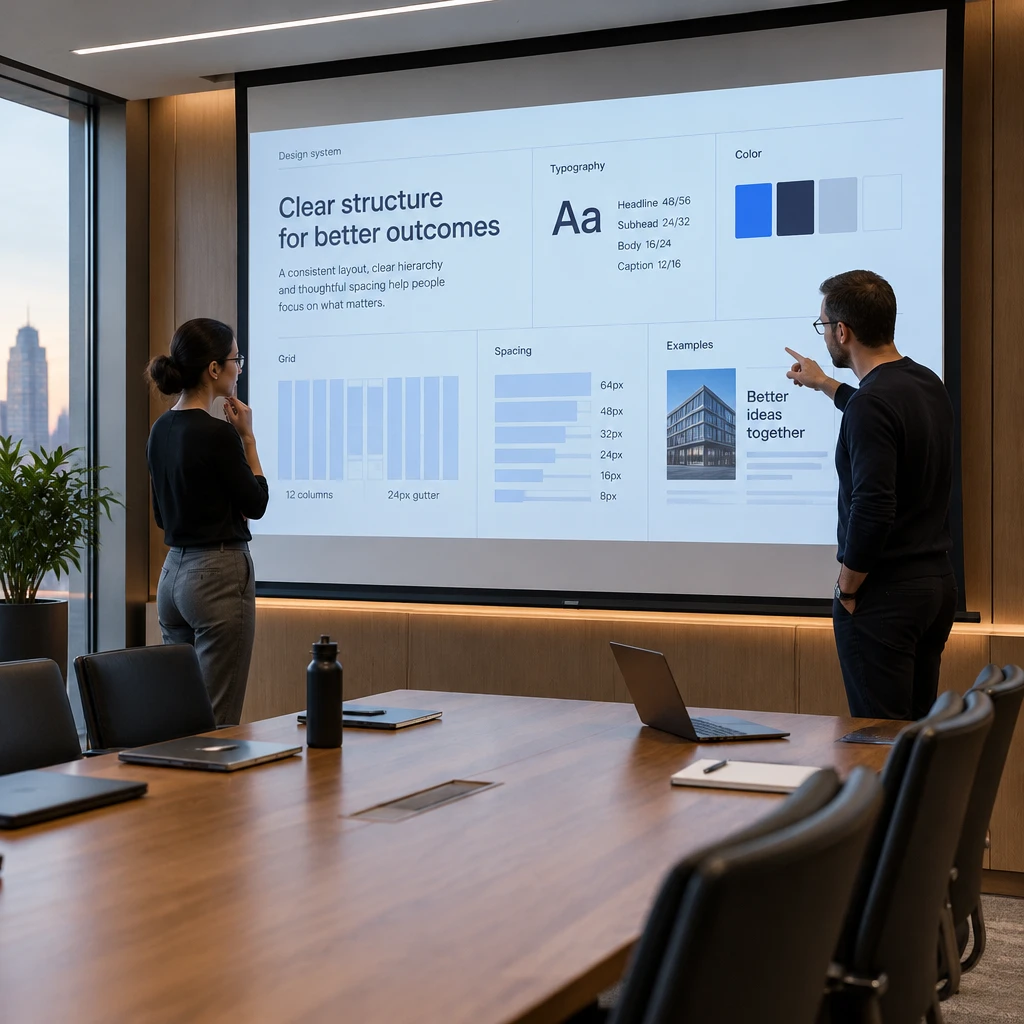
IBM Research 公布了 Palette 项目,目标很明确,就是用企业自己能私有化部署的 20B 开源小模型,生成严格遵循内部视觉规范(如 IBM Design Language)的 PPT。在权威基准 PresentBench 测试的三个领域里,Palette 拿到 59.7 分,总排名第二,仅以 1.1 分之差 排在 Google NotebookLM(60.8 分)身后,还在经济学和教育两个单项上拿了第一。
账面故事是小模型逆袭前沿大模型,既治好了通用模型甩不掉的 AI 模板味,又守住了机密数据不出域的底线。但如果翻开评测说明和 GitHub 上的 IBM/project-palette 源码,你会看到另一幅景象:这个 20B 模型既没有单打独斗,也没有真正把权重和合成数据交出来。公关叙事水分不小,但它沉淀下来的工程配方却相当扎实。
盲写排版的解耦配方:单 LoRA 双角色与反事实数据
通用大模型做 PPT 容易千篇一律,而小模型直接做 PPT 则会彻底崩坏——标题和背景同色、文字飞出画布、色块叠在一起。
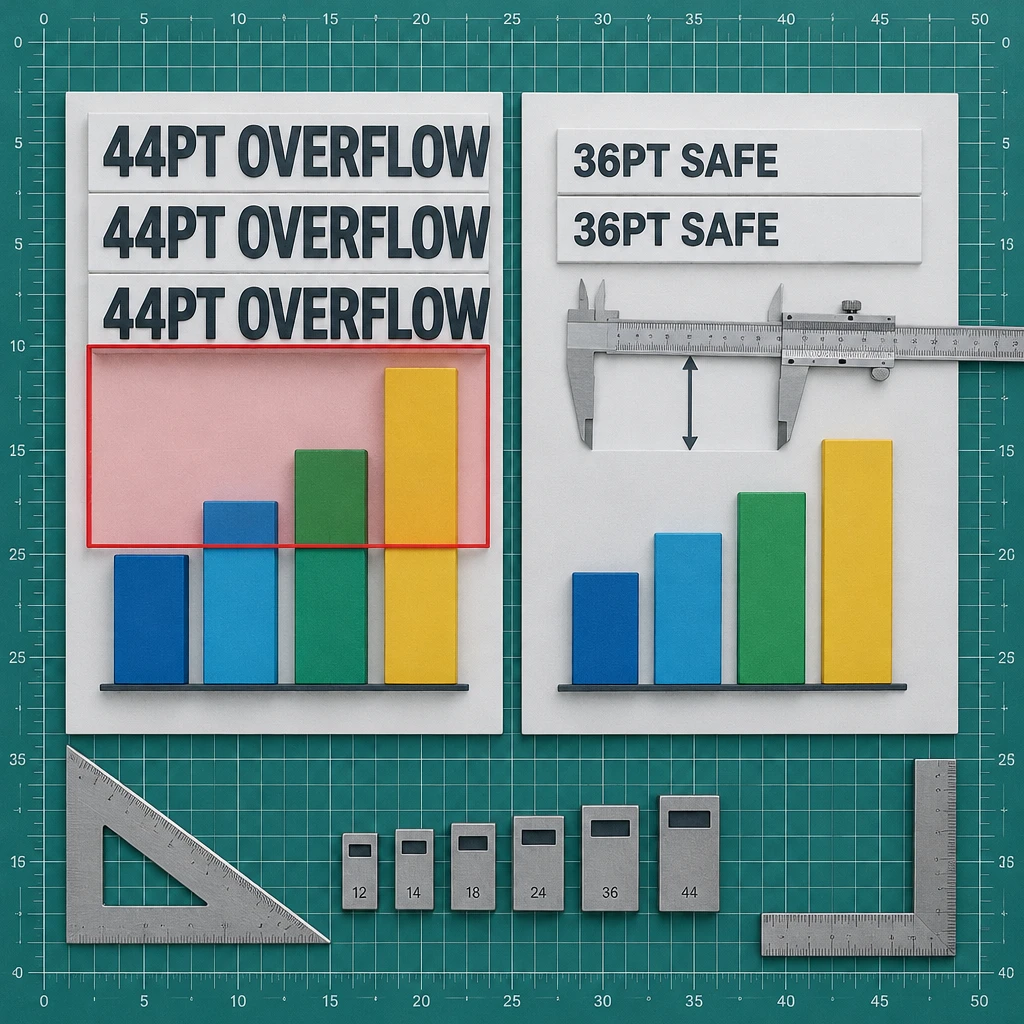
病根在于模型不是看着画布排版的,它是在盲写代码。模型要在脑子里心算一个 75 字符的标题用 56 号字会不会超过两行,同时还要决定这一页放图表还是表格。把编辑取舍和几何算术塞进同一次生成里,20B 体量的小模型根本算不过来。
Palette 的解法是模仿人类团队,用 单个 LoRA 适配器 训出两个角色:
- 设计师(Designer)只管内容和版式,读取大纲后输出一份结构化 JSON 简报,定好配色、字体、每页布局和设计理由。
- 程序员(Coder)只管几何计算,拿走单页 JSON 规范,并行编写
pptxgenjs渲染代码。因为每页上下文独立,编码阶段直接 提速 6 到 7 倍。
这里有个极容易踩坑的工程细节。程序员写的 JavaScript 代码样本,长度大概是设计师 JSON 样本的 5 倍。如果按原始比例混合微调,设计师角色就会严重欠拟合,IBM 团队不得不把设计师样本做了 5 倍过采样 才拉平能力。
互联网上并不存在带设计理由和底层代码的 PPT 数据集。团队用大型开源教师模型合成了约 1,000 份演示文稿(约 10,000 页幻灯片),并在数据里塞进了反事实推理(Counterfactual Reasoning)。模型不只是写出把字号设为 36pt,还必须在推理过程里写明:标题有 62 个字符,如果用 44pt 会折成三行并撞上下方的图表,所以放弃 44pt 改用 36pt。
在合成数据时,最头疼的是模型胡编乱造(例如简报要求画 6×5 的表格,但原文只有 3 条数据,模型就会自己编造剩下的数据)。团队试着在提示词里加严厉的禁令,几乎没用;最后发现教师模型极度依赖上下文里的参考示例(Reference Decks),直接修改参考示例,比写十条提示词规则都管用。
生成之后,所有页面还要过一道确定性检查器(Harness)。检查器把代码真实渲染出来,量出文字重叠和出界,再交给独立的编辑模型重写代码;只有检查器确认修改版确实变好了,才会替换原稿。在 131 份文稿测试中,仅靠这套外部检查器兜底,就给总成绩硬拔高了 3.5 分。
跑分与开源的真相:59.7 分背后是谁在出力
如果只看博客正文,很容易以为一个 20B 模型单挑赢了商用系统。但核对 PresentBench 原始设计、报告细节与 GitHub 代码库后,有三个事实必须摊开讲。
跑分证明了它排版及格,却没证明它守住了企业模板。
第一,59.7 分不是 20B 模型独立拿下的。PresentBench 给的是原始长文档,而不是现成大纲;在评测中,IBM 实际上先调用了一个 独立的前沿大模型 把源文档提炼成输入大纲,再交给 Palette 画图,且对比的基线分数是直接抄自论文而非同场重跑。此外,PresentBench 完整基准有 5 个领域(学术、广告、教育、经济学、演讲)共 238 个任务,Palette 只挑了其中 3 个领域汇报;更尴尬的是,IBM 作者自己也承认,PresentBench 根本不考核模型是否遵循特定设计语言——也就是说,高分并没有验证它最核心的品牌合规卖点。
第二,所谓的开源私有化,目前只给了一个空壳脚手架。去 Hugging Face 和 GitHub 上找一圈就会发现,无论是那个 20B 模型的 LoRA 权重,还是那 1,000 份合成训练数据,均未公开提供下载。
第三,代码库的配置与文章口径对不上。仓库 README 里写的是 gpt-oss-20b-palette-lora,但点开 config.py,默认配置却指向了 Qwen2.5-Coder-32B 的适配器,同时还调用了其他独立模型分别负责规划、编辑和视觉批评。而且这套代码必须绑定 IBM 内部的 RITS 推理令牌才能跑通,外部开发者克隆下来也无法在本地独立复现。
- 风险.训练数据清洗与推理阶段修复共用同一个几何检查器,模型极易针对单一检查规则过拟合;且并行提速只算了写代码那一步,漏掉了前置大模型规划、JSON 生成和反复渲染重试的端到端总延迟。
庖丁解牛:企业 Agent 真正该抄走的作业
《庄子·养生主》里讲庖丁解牛,核心就一句:依乎天理,批大郤,导大窾。骨节之间本来就有缝隙,顺着缝隙下刀,才不会拿刀刃去硬砍骨头。
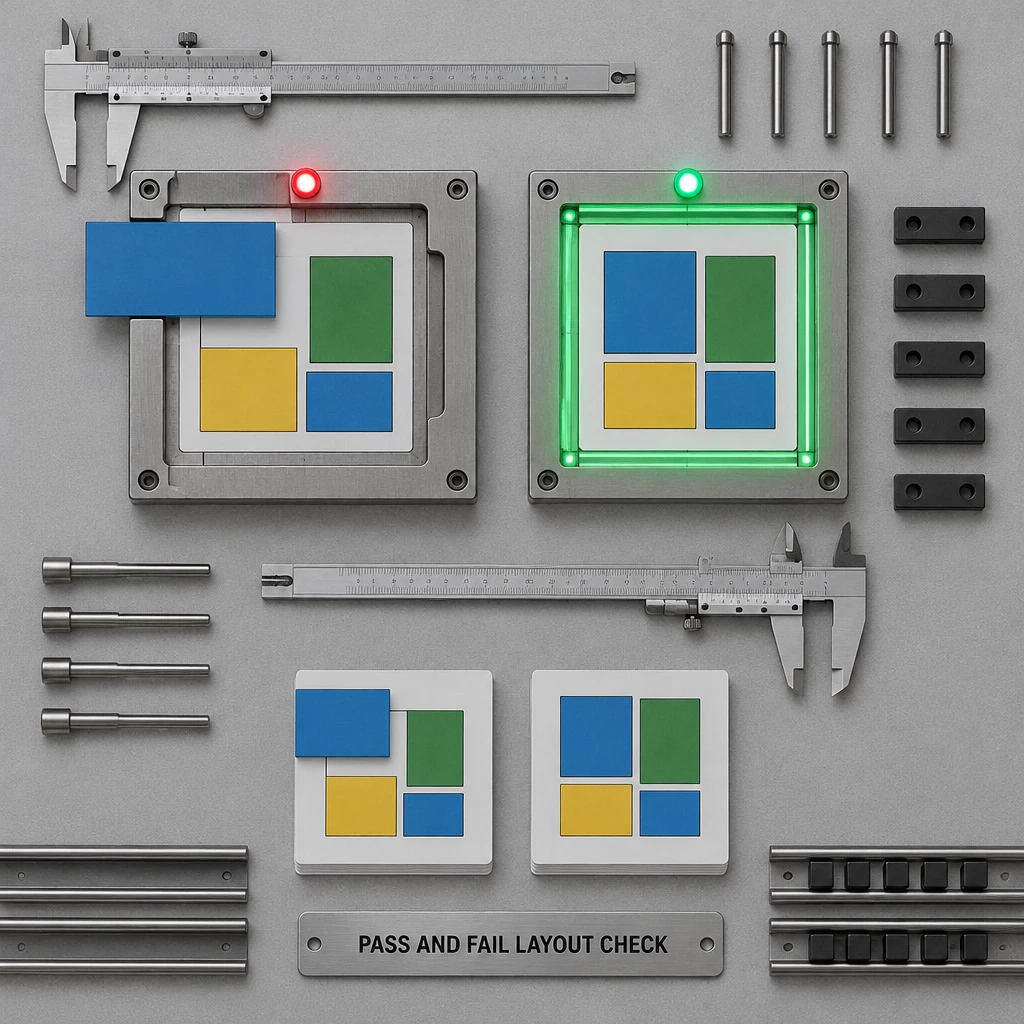
过去很多团队做垂直办公 Agent,总想靠一个参数不大的端到端模型,一口气把脏乱的业务文档变成排版精美的交付物,这就像拿小刀硬剁牛骨。IBM 这次虽然在跑分宣传和开源成色上藏了心眼,但它展示的刀法却切准了结构化生成任务的缝隙。
对于正在做飞书、钉钉、WPS 插件或企业内部效率工具的研发团队来说,不指望 IBM 补发权重,现在就能直接拿走三样东西:
- 用 JSON 简报做中间态解耦把审美编排和坐标计算拆成两步,不仅能用单 LoRA 低成本微调,还能让用户直接在文本大纲里用
[[make this a timeline]]这种方括号指令精准干预单页版式,改一页不必重画整套 PPT。 - 用反事实理由合成过程数据教小模型写界面代码时,光给正确代码没用,必须让教师模型在合成数据里写明为什么淘汰另一个字号或布局,把排版规则变成可学习的文本推理。
- 先写检查器,再谈训模型与其指望模型一次算对坐标,不如先用确定性代码写好重叠与溢出检查器。用它清洗合成数据、在推理端做安全替换,哪怕模型只有 20B 甚至更小,交付底线也能被稳稳托住。
接下来真正值得盯住的信号有两个:一是 IBM 会不会在 Hugging Face 上把那套 20B/32B 的 LoRA 权重和 1 万页合成数据补齐;二是行业里谁先拿出真正能测出企业视觉系统遵循度(Brand Adherence)的硬核基准。在那之前,别轻信小模型单挑前沿系统的神话,但务必把这套先拆角色、再绑检查器的手艺学到手。