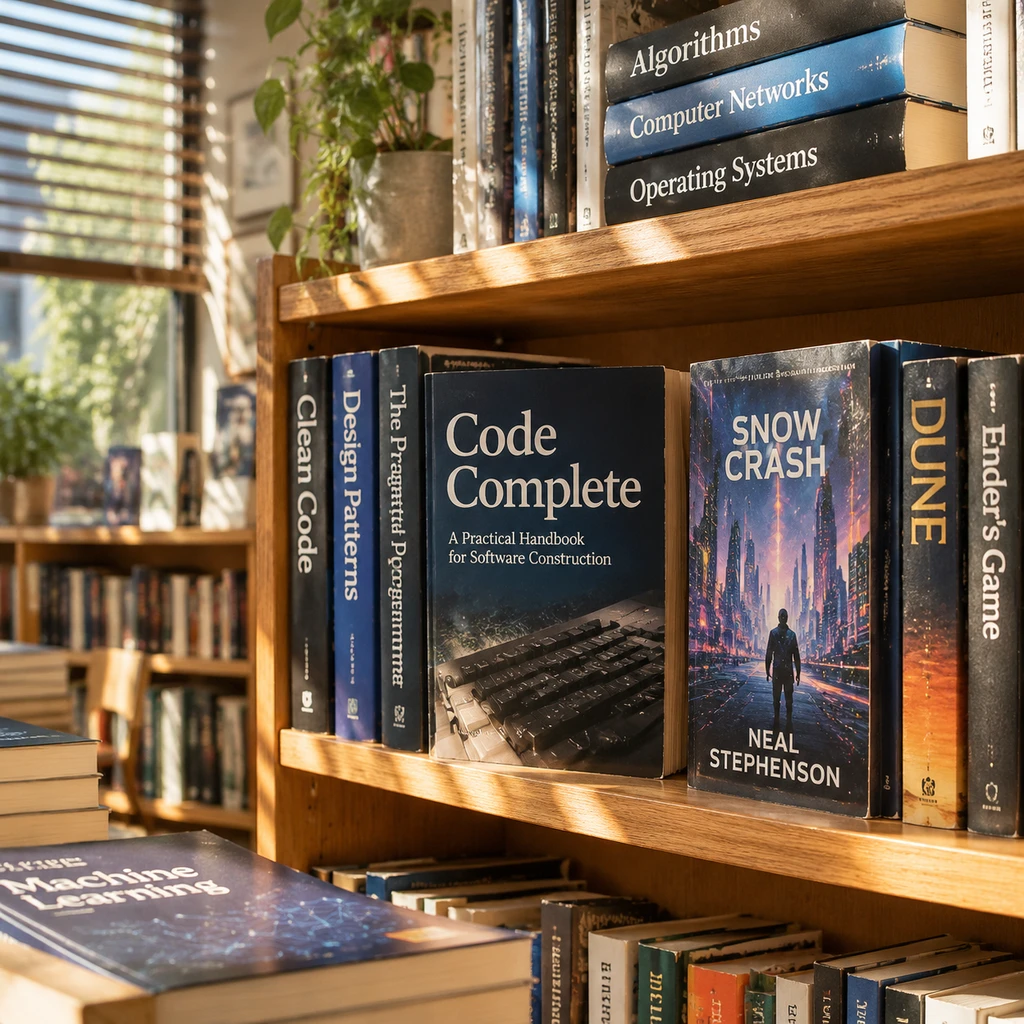
开发者社区 Hacker News 近日上线了一个名为 HackerBooks(hackerbooks.org)的图书聚合项目,直接把 2007 年至 2026 年间评论区出现过的 16,543 本书籍 整理成了可视化榜单。对于想了解硅谷工程师精神图谱的读者来说,这是一座横跨 19 年的书单矿脉;但如果你打算照着榜单直接下单买书,很可能会掉进它把批评也算作推荐的统计陷阱里。
翻开 HackerBooks 的历史总榜(Top all-time),排在最前面的几乎是硅谷极客文化的标准切片。尼尔·斯蒂芬森的科幻小说《雪崩》(Snow Crash)以 1,004 人推荐 断层领跑,《代码大全》(661 人)、《程序员修炼之道》(652 人)与《银河系漫游指南》(651 人)紧随其后,阿兰·兰德的《阿特拉斯耸耸肩》也拿到了 805 票。网站除了提供历史总榜、飙升榜(Rising)和每日随机洗牌的首页,还支持直接下载底层数据集。
零成本拼图与提及即推荐的假象
这个看似庞大的书库,底层其实是一套精巧的开源数据拼装方案。开发者没有从零编写爬虫去抓 Y Combinator 的服务器,而是直接调用了开源数据集 open-index/hacker-news 的历史评论,再通过 Open Library 匹配图书元数据与封面。只要一本书在 2007 年以来的评论区被至少两名不同用户提起,就会进入这 1.65 万本书的池子。
真正的问题出在前端文案与后端逻辑的错位上。HackerBooks 在每本书的封面下方都醒目地印着由多少位 HN 用户推荐(Recommended by X HNers),但项目创建者在社区讨论中承认,算法统计的只是单纯的提及次数,根本没有区分褒贬。
算法分不清赞美与吐槽,吵得越凶的书在榜上爬得越高。
这就解释了为什么榜单里会混进不少争议之作。比如拿下 133 票的《Learn C the hard way》,在 C 语言开发者社区长期伴随大量关于教学方式和代码规范的批评;获得 226 票的《共产党宣言》和 78 票的《The UNIX-haters handbook》,更多是极客们在意识形态争论或操作系统口水战中的高频引据,而非一边倒的必读安利。
- 风险.读者如果把页面上的推荐数当成豆瓣或 Goodreads 的好评票数直接买书,极易买到社区公认的避雷教材或纯属话题靶子的读物。
十五年挖书史,全量与精准难以兼得
Hacker News 评论区一直被公认为高质量书单的富矿,但原生论坛没有标签和归档功能。过去 15 年里,每隔几年就有开发者尝试用技术手段把这些书挖出来,而他们撞上的始终是同一堵墙。
早在 2011 年 2 月 22 日,社区就出现过一个同名的早期项目 HackerBooks.com。受限于当年的分词与实体识别水平,用户在那个网站搜索 C、C++ 和 C# 会返回完全相同的结果,搜索 Ruby 甚至会跳出 ASP.NET 的教材。
后来的挑战者演化出了两条截然不同的路线。一条是以 YaHNd 旗下的 HN Books 为代表的周期聚合路线,无需 JavaScript 即可极速浏览周榜、月榜并支持邮件订阅;另一条则是 Levelbrook 的精选路线,它放弃了全站扫描,只从 443 个图书讨论专帖 中提取数据,严格按实际推荐的独立评论者排序。
| 聚合工具 | 数据覆盖范围 | 核心排序与交互机制 | 主要局限 |
|---|---|---|---|
| HackerBooks (2026) | 2007–2026 全量评论(16,543 本) | 每日随机洗牌 + 历史提及总榜 | 依赖 JS 渲染;批评与推荐混计 |
| YaHNd HN Books | 周期性全站热门提及 | 周/月/年榜单 + 邮件订阅(免 JS) | 缺乏长尾冷门书随机探索体验 |
| Levelbrook | 仅限 443 个阅读专帖 | 独立推荐者计数 + 原评论引文展示 | 覆盖面窄,漏掉日常技术帖里的好书 |
把这三代工具放在一起看,就能看清社区数据挖掘的天然矛盾:要像新版 HackerBooks 这样把书库规模推到 1.65 万本的高召回率,就很难保证每一票都是真心安利的高准确率;而像 Levelbrook 那样守住专帖语境,又会漏掉大量散落在日常技术讨论里的冷门神作。
对于普通技术读者和开发者而言,当下使用 HackerBooks 最稳妥的动作,是把它当成一个带索引的评论区搜索引擎。看中某本没听过的技术书或科幻小说时,不要轻信封面下的票数,务必点进详情页顺着链接回溯到 Hacker News 的原始楼层,看一眼当年提及它的极客到底是在划重点,还是在写避坑指南。而对于独立开发者来说,既然底层数据集已经完全开源,下一步最值得做的变量,就是接上大语言模型对这 1.65 万本书的原始评论做一次低成本的情感极性清洗,把真正的推荐票从口水战里筛出来。