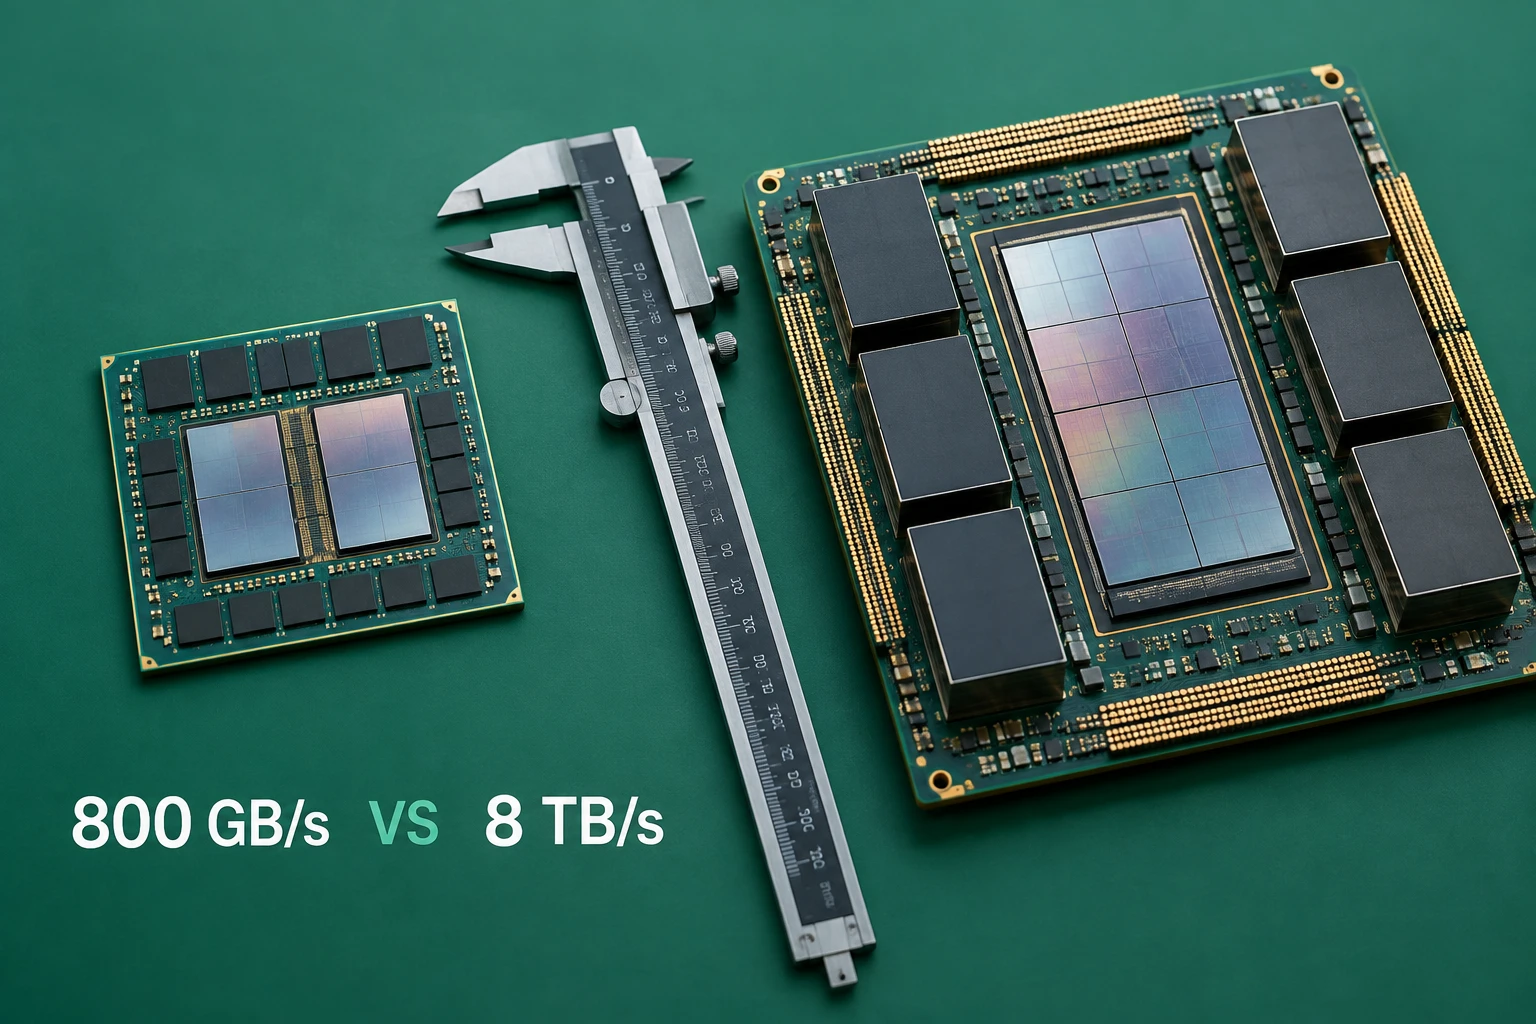
科技行业向来喜欢看“自研屠龙”的故事,近期关于苹果正在研发搭载自研 M 系列 Ultra 芯片的企业级 AI 服务器的报道,再次引发了市场对苹果全面摆脱英伟达的狂想。然而只要把算力硬件的工程底牌翻开,这种爽文叙事便不攻自破:苹果造服务器从来不是为了在通用 AI 算力赛道与芯片巨头正面对决,而是一场受制于物理瓶颈、以隐私合规为代价的技术防守。
早在 2024 年 5 月,彭博社就曾披露苹果计划在数据中心部署 M2 Ultra 芯片处理 AI 负载。该芯片集成 1340 亿晶体管,拥有 24 核 CPU、最高 76 核 GPU 和 32 核神经网络引擎,并支持最高 192GB 统一内存 与 800GB/s 内存带宽。配合苹果的私有云计算(Private Cloud Compute,简称 PCC)架构,这套系统基于 Secure Enclave 硬件信任根与无状态处理理念,成为苹果端云协同推理的核心底座。然而,苹果官方安全白皮书里所用的措辞始终是“定制 Apple Silicon 服务器”,从未直接使用过消费级的 Ultra 型号标称。
算力账本里的数量级鸿沟
大模型推理与生成的真正命门不在于峰值算力,而在于内存带宽。在 Transformer 模型的自回归生成阶段,计算单元每一次生成 Token 都要把数百亿参数从内存中搬运一次,系统吞吐量完全被访存速率卡死。
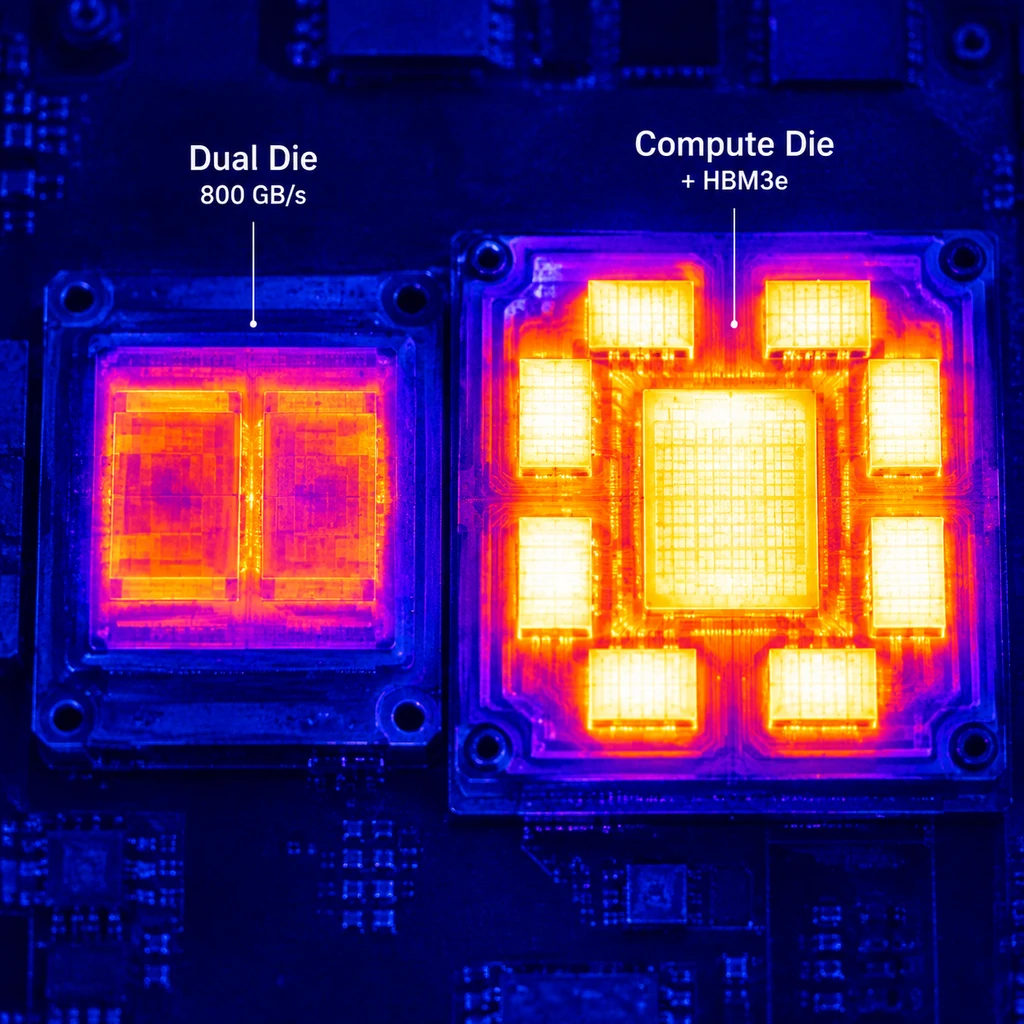
把硬件参数摆在同一基准下,落差一清二楚。英伟达 B300 依托 288GB HBM3e 提供了约 8 TB/s 的带宽,谷歌 TPU Ironwood 也达到了 7.2 TB/s。而即使是更新一代的 M3 Ultra,其最高 512GB 统一内存对应的带宽仅在 819 GB/s 左右。
这意味着在单位时间内,工业级 AI 加速器的模型参数吞吐能力是苹果芯片的近十倍。单纯靠统一内存容量大,无法掩盖带宽维度的代际断层。
| 算力硬件平台 | 显存/内存容量 | 内存带宽 | 核心互联架构 | 典型工作负载 |
|---|---|---|---|---|
| Apple M2 Ultra | 192GB 统一内存 | 800 GB/s | UltraFusion 晶圆级互联 | 私有轻中型推理 |
| Apple M3 Ultra | 512GB 统一内存 | 819 GB/s | UltraFusion 晶圆级互联 | 低并发本地化部署 |
| Google TPU Ironwood | 192GB HBM | 7.2 TB/s | 专用集群互联光纤 | 大规模训练与推理 |
| NVIDIA B300 | 288GB HBM3e | 8.0 TB/s | NVLink 机架级总线织网 | 高并发通用 AI 中枢 |
更深层的硬伤在通信网络。英伟达能够统治当代数据中心,核心护城河是基于 NVLink 与 InfiniBand 搭建的横向扩展织网(Scale-out Fabric)。以 GB300 NVL72 机柜为例,整柜通过 72 颗 GPU 和 36 颗 Grace CPU 协同运作,机柜功耗达 100 至 150 kW 级,专为海量并发而生。苹果的 UltraFusion 仅是把两块晶圆拼接在一起的芯片内封装技术,根本不具备跨节点组网的机架级互联协议。面对十亿级用户的并发洪峰,缺乏网络织网的苹果服务器会迅速陷入通信死锁。
低功耗神话与成本悖论
行业内常有人赞赏苹果芯片的能效比,认为单机仅数百瓦功耗的 M 系列主机能帮数据中心省下大笔电费。这种观点脱离了工作负载谈能耗,混淆了空载功耗与交付效率。
算力经济学的终极指标不是一台服务器消耗多少电,而是交付每个请求所消耗的焦耳数(Joules per Token)。高功耗的英伟达集群虽然单柜耗电如雷,但在极其密集的带宽支撑下,毫秒级即可完成一次推理,并在单卡内并发承接数百个任务。而苹果芯片受限于 800GB/s 的带宽瓶颈,生成 Token 速度缓慢,并发通道极为狭窄。
算力不是省出来的,而是吞吐出来的。跑不动的低功耗,本质上是最昂贵的算力浪费。
一旦把硬件折旧、机房机位租赁以及单 Token 的真实时间成本摊平,依靠消费级芯片魔改的服务器在超大规模商用场景下,经济效益远没有纸面上漂亮。
隐藏在安全更新背后的妥协
真正戳破苹果纯血自研神话的,是苹果官方自己在技术架构上的战术撤退。
2026 年 6 月 8 日,苹果官方发布安全更新披露:私有云计算(PCC)的基础设施已经向使用英伟达 GPU 的谷歌云(Google Cloud)环境延伸。尽管苹果在这个混合云体系中依然强制推行度量启动、密码学证明等透明度规范,但它说明了一个不争的事实:面对日益膨胀的模型体量与并发需求,仅靠定制 Apple Silicon 已经撑不住完整的云端算力消耗。
从拓扑结构看,苹果自研 M 系列芯片在服务器端的真正使命不是替代英伟达,而是做一道合规前置网关。普通轻量计算由端侧消化;中度敏感任务送进由自研芯片锁死的 PCC 隐私信箱;一旦涉及更大体量、需要长上下文逻辑链的运算,最终仍然要靠外部公有云的 GPU 矩阵来托底。
- 结论.苹果做 AI 服务器,买单的是自身对隐私合规的承诺,而不是试图切入通用云端算力市场。只要苹果无法自研出高带宽 HBM 堆叠和专有机架级高速互联网络,其服务器就只能偏安于轻载私有推理的生态角落。