大模型赛道打了几年,大家似乎默认了一个前提:模型必须滔滔不绝。哪怕你只需要一个简单的二选一判断,自回归模型也要在后台慢慢吐出一串可能格式破碎的 JSON,再按高昂的输出单价向你按字收钱。
TypeSafe AI 上周推出的 Jev 砍向了这个惯性。这是一种被称为决策模型(Decision Model)或快思考系统(System One)的新形态:输入文本或半结构化状态,输出只给浮点数,不吐出任何一段自然语言。它的输入价格定在 0.042 美元 / 百万 Token,输出完全免费,甚至比 OpenAI 的轻量级模型 GPT-5 Nano(0.05 美元 / 百万 Token)还要便宜。
把复杂的语言生成退回为纯粹的判别打分,表面看是一笔划算的工程减法。但当人们为低廉的调用账单欢呼时,真正棘手的问题才刚刚浮出水面。
扔掉嘴巴的判别器
主流大模型在工业落地时有三大顽疾:输出延迟不可控、生成内容有幻觉、JSON 解析经常在半夜崩溃。
Jev 解决这套问题的方式粗暴直接:不给模型开口说话的机会。用户向它的接口提交一个状态对象(一篇文章、一段用户日志或一份键值对记录),然后附带一个或多个问题。模型内部并行评估所有问题,耗时不会随问题数量线性暴增,返回结果全是由纯数字构成的数组。
它的接口支持三类问题:
- Noul 问题.取名自伯努利分布,接收陈述句并返回 0 到 1 之间的概率值,用来回答是非判断。
- Choice 问题.在给定的几个选项中做单选,返回带有置信度的概率分布。
- Score 问题.用户定义数值区间与分级描述,模型返回该范围内的具体浮点分数。
早期尝试者迅速把它接入垃圾邮件过滤、内容打标以及搜索重排流程。典型做法是先用成本极低的 BM25 算法粗筛出 100 个候选结果,再让 Jev 对这 100 个结果逐一打分排序。开源社区甚至借此搭建了用浮点数预测下一步走向的 jevchat、实现纯打分补齐的 jev-leftpad,以及跑在数字概率上的 jev-2048 游戏。
但这种热闹更像是一场对极低 Token 单价的技术狂欢。
算账不能只看 Token 标价
很多工程师看到 0.042 美元的输入单价,就认定重排系统的成本可以原地下降一个数量级。这种乐观忽略了实际生产链路中的开销结构。
重排场景的综合成本从来不只取决于基础单价。当你需要对 100 个候选文档做精细重排时,候选集的扇出规模会瞬间吃掉几十万甚至上百万的输入 Token。即使单价极低,反复扇出的总体用量依然庞大。
更致命的是网络与端到端延迟。大模型服务真正在生产环境卡脖子的指标是 p95 延迟与并发吞吐。一个外部 API 如果没有严苛的 SLA 保障,在几十次并发请求中只要出现一两次抖动,整个下游推荐系统就会超时。
剥离了语言能力的模型,并没有自动获得确定性。
目前在公开网络检索中,尚未检索到 TypeSafe AI 与 Jev 的标准公开技术文档、公开基准测试及模型版本规范。没有 F1 分数,没有 AUROC,也没有信息检索领域通用的 NDCG 跑分,它的工业可用性目前很难独立验证。
- 风险.决策模型输出的置信度若未经过 Platt 缩放或等保回归等统计校准,数值就不能当作概率使用,所谓 0.8 的置信度可能只是未经校正的原始评分。
彻底黑箱带来的代价
如果说工程算账只是性价比的权衡,那么解释权的彻底丧失,就是算法治理上的严重倒退。
自回归大模型也是黑箱,但至少保留了一条退路:你可以要求它输出思维链(CoT),或者给出支持该结论的几点论据。尽管它的自我陈述可能存在事后合理化的欺骗,但工程师依然有文本抓手来排查偏见与逻辑漏洞。
Jev 连这点抓手都拔掉了。你输入几千字背景,它只扔回一个冷冰冰的 0.73。究竟是文中的哪句话触发了垃圾邮件标记?没人知道。
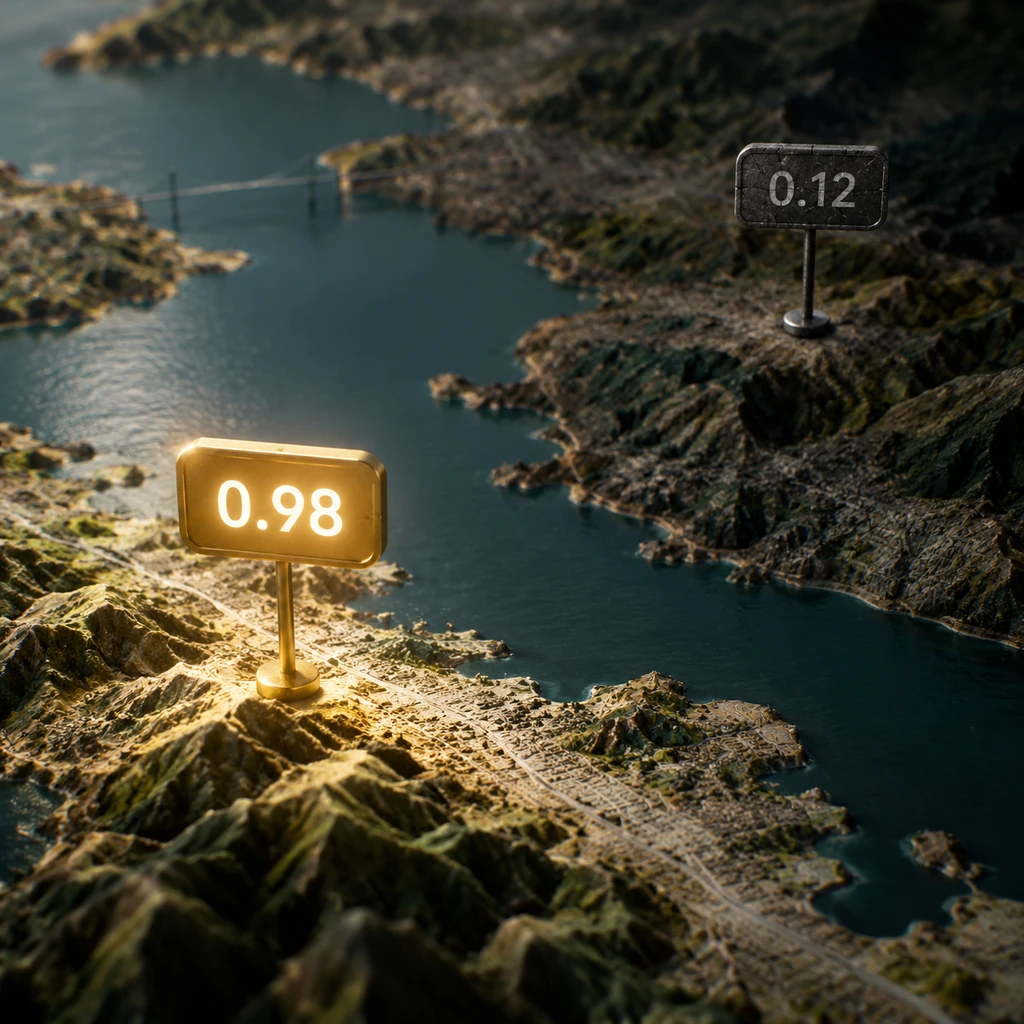
在早期的测试中,有人让 Jev 对旧金山湾区各个城市是否是好城市进行打分,结果富人聚集的 Cupertino 拿到最高分,而低收入和少数族裔集中的 East Palo Alto 稳居垫底。这个测试把隐性偏见的风险暴露无遗。如果有人把这种完全不可解释的浮点打分直接搬进简历初筛、信用卡核保或风控预警系统,背后潜藏的歧视风险将无法被审计和规避。
《韩非子》讲“郢书燕说”,燕相好歹还能对着荒诞的郢人来信牵强附会出治国之策;而面对一个只给数字的纯粹判别黑箱,系统运维者连穿凿附会的余地都没有。
在欧美算法监管趋严的当下,企业若要采用这类模型,更现实的路径是构建分层防线:用规则引擎与 BM25 做底层粗筛,用判别模型处理低风险场景的流水线排序,在涉及人身、财产与合规裁量的高敏感节点,仍必须由具备可追溯文本依据的生成模型或人工兜底。
低价是打开市场的敲门砖,但仅靠切除嘴巴来换取速度的模型,无法自发解决公正与可信的账单。