2026年9月21日,曾参与确立RLHF后训练范式、联名发表里程碑论文InstructGPT的Diogo Almeida,带领其创办的TypeSafe AI正式推出了新型模型Jev。它的发布视频在社交网络迅速斩获了约4000万次观看,不仅远超GPT-4o的2200万次与Fable 5的1500万次,也仅次于Navier Stokes的7400万次与6 Astra的1.37亿次。
这场轰动不是因为行业又多了一个夸夸其谈的拟人聊天机器人,而是因为这位亲手推动过ChatGPT底层对齐范式的核心研究员,公开站到了自回归Chat大模型的对立面。工业落地的真正瓶颈从来不是模型不够博学,而是工程系统根本无法容忍自回归生成带来的不可控拒绝、高昂缓存成本与迟钝延迟。生产系统不需要一个不可靠的神,而需要像正则表达式一样无感、极速且永不拒绝的底层构件。
4000万次播放背后,后训练开拓者的自我否定
大模型的后训练演进有迹可循:2017年Christiano等人确立基于人类反馈的强化学习(RLHF),2020年Stiennon等人将其引入摘要生成任务,到了2022年Ouyang等人的InstructGPT论文发表,正式确立了指令遵循与对话式LLM的标准架构。
但这一路线在走向生产环境时露出了沉重代价。为了让模型在公众对话中显得礼貌而无害,过度对齐带来了难以根治的虚假拒绝;为了讨好人类标注员,模型往往在关键决策上出现谄媚与幻觉。
当软件开发者试图把大模型嵌入代码检查、工具调用和实时控制流时,这种不确定性便成了灾难。Diogo将工业系统迫切需要的模型定义为专注于即时、低延迟感知判断的System One专用模型,主张以高可靠性和零拒绝取代盲目攀比通用常识的造神路线。
算不过的内存账:KV Cache的工程暴政
在自回归架构下,Token按序生成依赖维持庞大的键值缓存(KV Cache)。随着上下文窗口拉长,这套机制在内存带宽和物理显存上向企业征收极其高昂的税收。
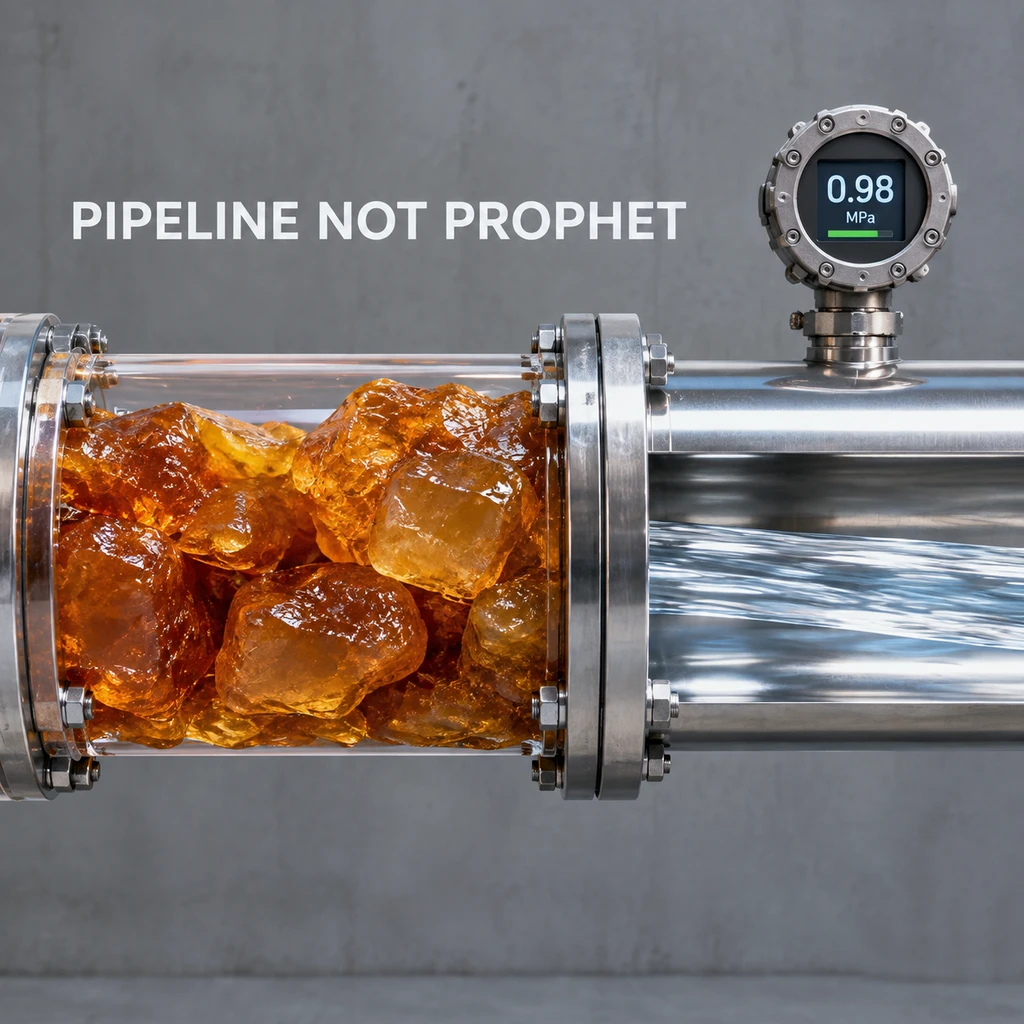
Diogo专门撰文痛陈《KV Cache的暴政》,直言在长上下文与多步Agent场景中,状态维护与缓存搬运彻底绑架了吞吐量。哪怕只做一次微小的代码语法检测或一次函数路由,系统也必须反复调度巨大显存,把毫秒级的控制逻辑硬生生拖成数秒的等待。
工业落地的残酷现实在于:生产系统要的是确凿无疑的管道,不是昂贵脆弱的先知。
为打破这种低效运转,TypeSafe官方公布了覆盖代码Linting、工具调用压缩、Doom游戏实时控制与黑暗数据解析的配套设计模式。Jev将分类器机制与Transformer结构融为一体,并开放了置信度API(Confidence API),让软件可以在毫秒级判断中直接读取概率依据,而非解析模棱两可的长文本输出。
- 结论.大模型在生产端要解决的不是智商高低,而是控制流的确定性与单次决策的极致性价比。
争议聚焦:架构创新还是分类器升级
在技术狂欢之外,业界的审慎审视随之而来。开源信息抽取社区很快指出,Jev的底层逻辑与开源实体命名抽取架构GLiNER有着高度相似的痕迹,认为这本质上是判别器与Transformer混合体系在特定工业任务上的重组,而非颠覆性的算法革命。
与此同时,开发者Theo也对Jev在复杂代码Agent场景中的实战表现提出公开质疑。在多步复杂的软件构建中,模型真的能抛弃上下文缓存管理和链式推理,仅靠离散的判别完成全局任务吗?
面对争议,Diogo的做法是公开拒绝采用通用的JevBench评测榜单。他明确抵制用跑分榜思维来包装专职工具,抨击全网短时间内冒出的至少55个同质化克隆API,强调团队重心已转向后续ReasoningJev的架构验证。
- 风险.如果不能在真实软件工程的长流程中证明自洽性,剥离了自回归推理能力的微模型很容易沦为高级语法分析器的替代品。
生产环境的软件构件向来崇尚稳定沉默。当整个行业仍在为通用人工智能的宏大叙事支付昂贵的算力溢价时,Jev的出现敲响了一记警钟:能够真正留存进代码库的,或许从来不是万能的对话拟人偶,而是隐形在底层默默执行逻辑的确定性开关。