大模型在对话框里越来越聪明,但一戴到脸上或装进机器狗的耳朵里,常常被几米外的一阵咖啡机噪音打回原形。冰岛声学仿真平台 Treble 近期宣布完成 1800 万美元 A 轮延期融资,累计融资金额突破 4000 万美元。这家由两位声学工程师在 2020 年创办的团队,正在做一件反常识的事:不再让语音 AI 靠抓取互联网录音硬撑,而是把声波在真实三维空间中的反弹、吸收与折射用偏微分方程算出来。
这笔由 Paladin Capital Group 领投的资金,连同亚马逊等客户的入场,折射出整个语音智能开发链路的断裂。过去两年,资本把大部分筹码压在智能客服与会议纪要等纯软件 Agent 上。当交互界面急速向智能眼镜、车载终端与具身机器人倾斜,技术瓶颈已经不在对话逻辑,而在空气介质本身。
现实声学物理墙
语音 AI 长期浸润在干净的录音数据中。互联网爬取来的播客、演讲和电话录音,虽然语义庞杂,在物理维度上却极度贫瘠。现实环境不仅有语义,还有复杂的反射面:混凝土墙壁的混响、玻璃窗的折射、家具产生的驻波,以及麦克风阵列被外壳包裹后的相位畸变。
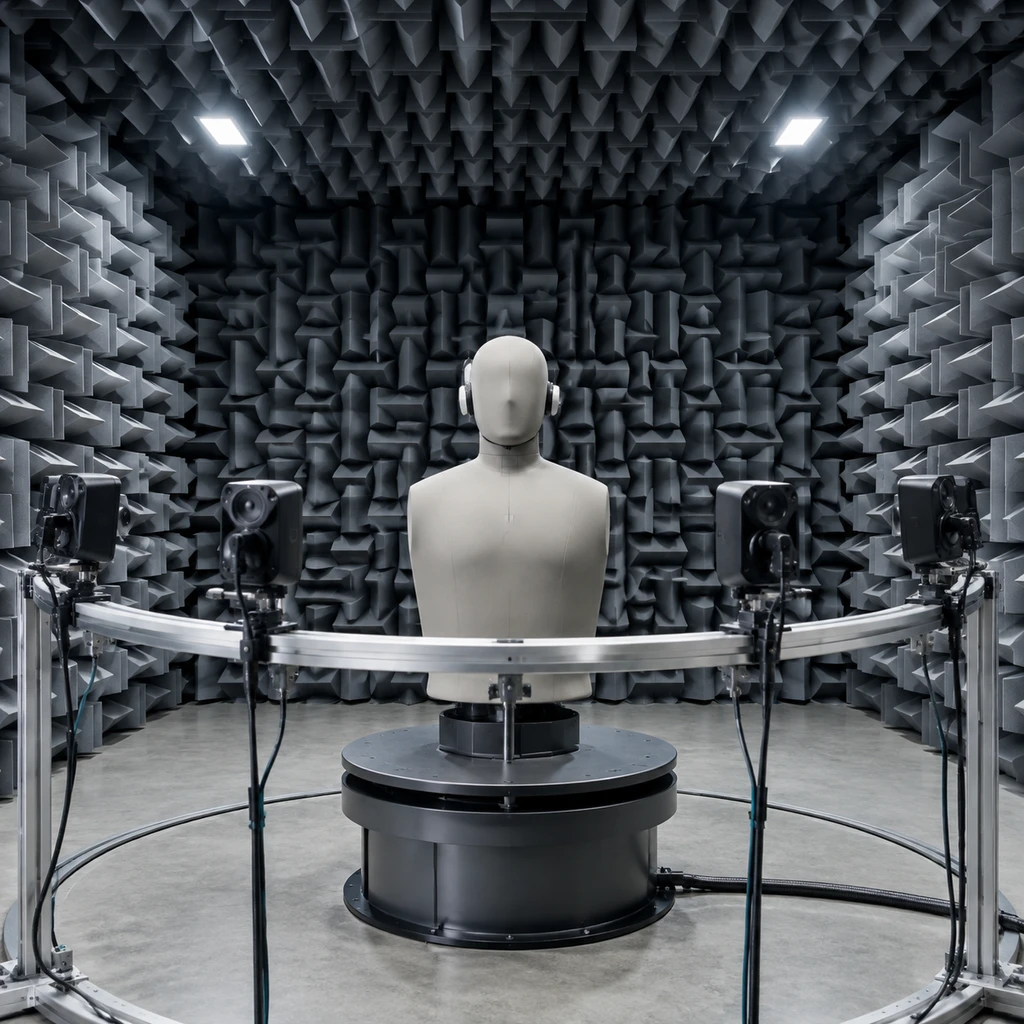
从传统录音室走向真实物理世界,模型面对的长尾声学信道近乎无穷无尽。以往硬件厂商解决这个问题的方法笨拙且昂贵:建一座实体消音室,摆上人头模型,戴着样机逐个角度播放白噪音与指令。这种实体测试不仅周期以月为单位计算,根本无法适应大模型时代以小时为周期的迭代节奏。
Treble 的打法是造一座云端声学数字孪生工厂。通过将波动声学与几何声学结合,它在云端用高阶 Ambisonics 技术模拟复杂的 3D 声场。根据其公布的基准数据,使用这种物理高拟真数据训练下游模型,语音识别字错率最高可以降低 38%。
测大脑还是测耳朵
行业当下对语音评测存在显著混淆。以 Hamming、Coval 或 Cekura 为代表的新一代工具,核心测试的是 Agent 的决策逻辑与语义合规:用户打断时模型能不能及时停嘴、有没有按业务流调用工具、多轮对话是否跑偏。
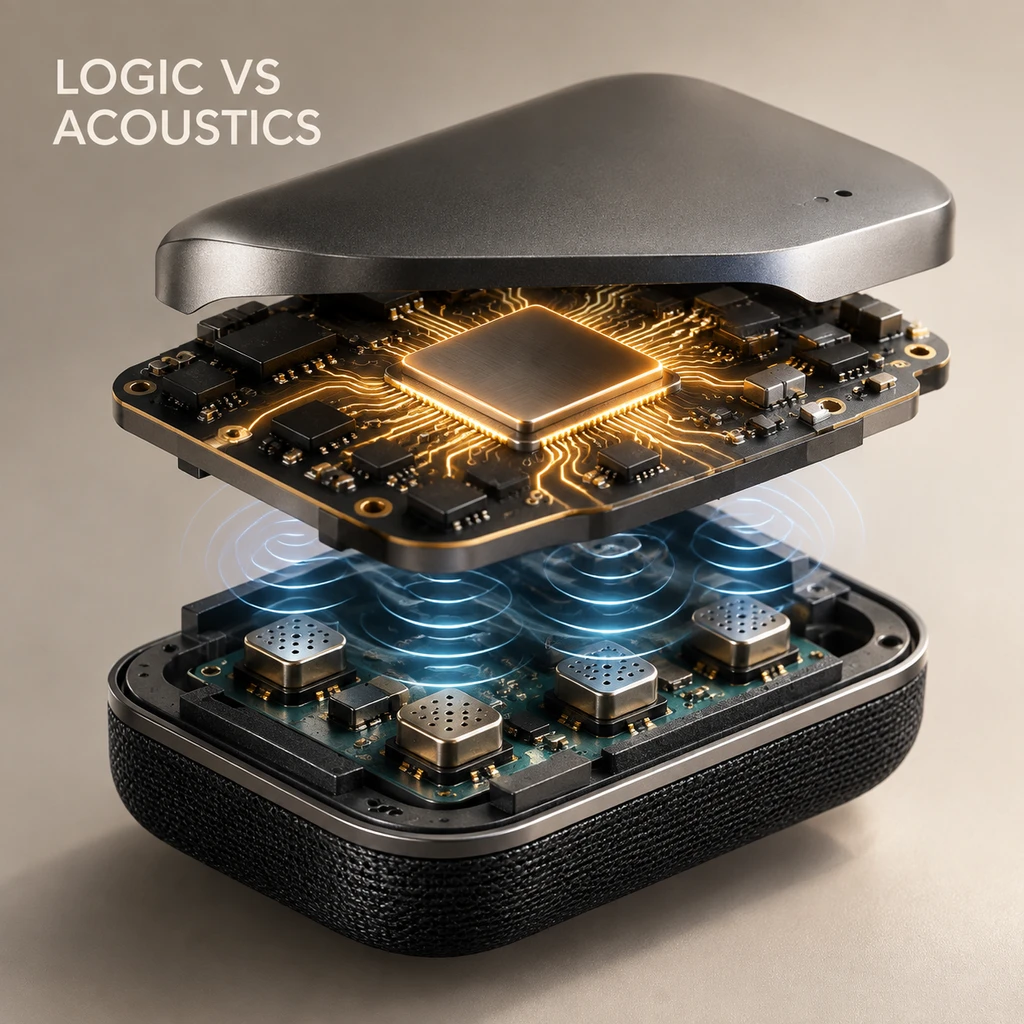
这属于测大脑。但如果声波进入麦克风的那一瞬间就由于空间回音产生了相位抵消,后面的逻辑推理再强也没有施展空间。Treble 卡位的是空气与芯片之间的物理信道层。
+-------------------------------------------------------------+
| 上层评测工具 (Hamming / Coval / Roark)                       |
| 评估重点:对话逻辑、Agent 任务达成、工具调用、打断机制        |
+-------------------------------------------------------------+
                              ▲
                              │ 语义转录文本
+-------------------------------------------------------------+
| 下层物理仿真 (Treble / COMSOL / Pyroomacoustics)             |
| 评估重点:波动方程、房间混响、麦克风阵列畸变、信噪比         |
+-------------------------------------------------------------+
在专业声学计算领域,老牌工业巨头 COMSOL 算力精度高,但软件笨重、价格昂贵,缺少针对现代深度学习团队的高并发 Python API;开源社区的 Pyroomacoustics 成本极低,却往往停留在基础的镜像法几何声学,在低频波导与复杂边缘衍射上捉襟见肘。Treble 通过提供支持高阶声场的云端 SDK,正好切在了两者的夹缝中。
穿戴与具身的声学重担
古人讲兼听则明,但在复杂的物理世界里,听清本身就是一种特权。
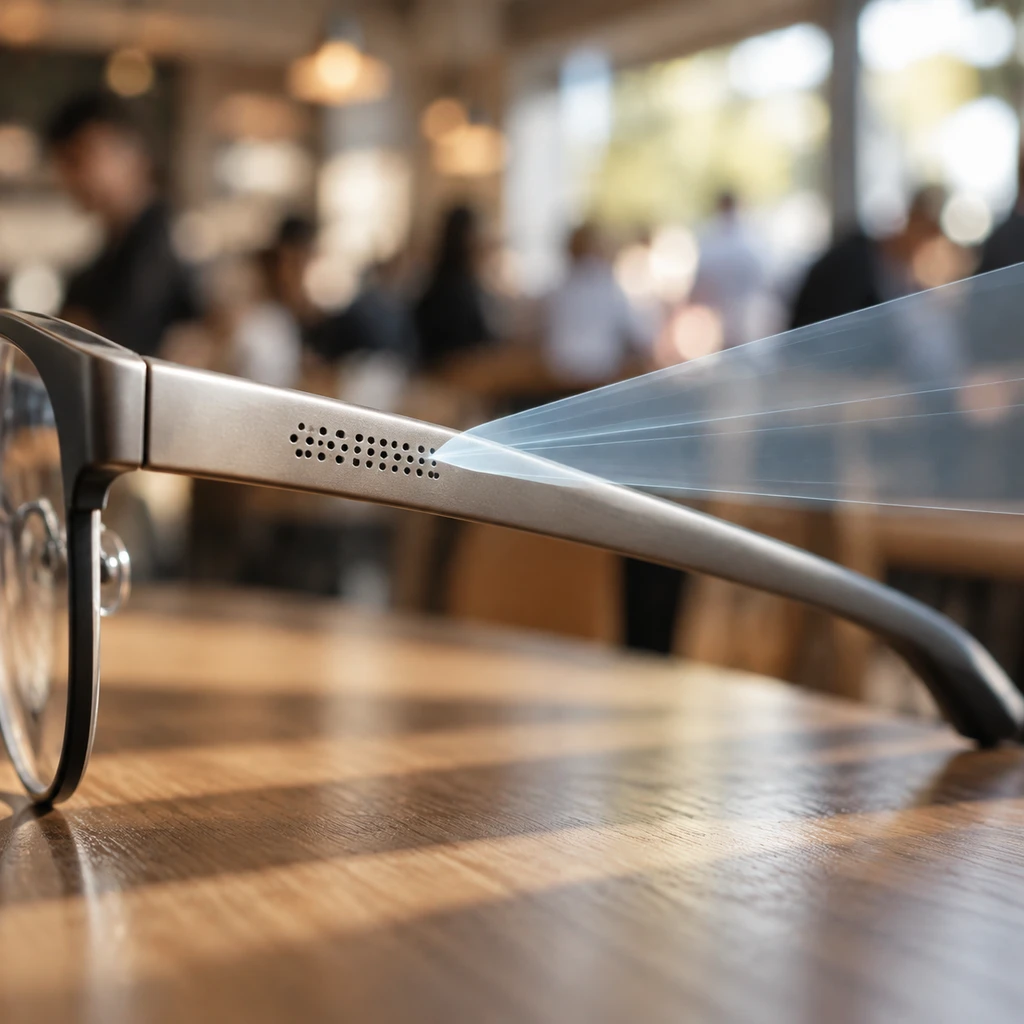
智能眼镜被公认是大模型的下一代承载终端,其核心交互完全依赖语音。但在人声鼎沸的餐厅或车水马龙的街头,眼镜腿上的微型麦克风距离嘴部极远,信噪比极差。如果没有极其精确的阵列波束成形,无论后台大模型有多大算力,第一道转录就把指令丢失了大半。这正是 Treble 创始人 Finnur Pind 描绘的超人听力场景:通过空间声学过滤,设备需要像筛子一样定向剥离两米之外的全部杂音。
具身机器人与无人机的加入更是放大了这一痛点。机体本身的旋翼转动、伺服电机运转都会产生巨大的结构自噪声,传统消音室测试很难穷尽机器在动态运动中的气流和声学反弹。
物理世界不相信文本提示词,声波在撞到墙壁那一刻便只遵从偏微分方程。
- 建议.硬件团队应尽早将声学仿真纳入持续集成流水线,避免把物理信道的问题堆积到后期依赖算法降噪硬解。
声学仿真正在从过去建筑设计与传统汽车的边缘工业软件,被推向前台成为具身智能的算力底座。它不再是一次性的耳机结构验证,而是大模型在真正进入物理世界之前,必须经历的高并发虚拟回音壁。