Anthropic首席执行官Dario Amodei近日发表长文,提议在前沿AI实验室内部常驻独立第三方评估机构,赋予其调查安全事件、评估模型对齐以及无须经企业审查即可公开发布报告的权力。OpenAI首席执行官Sam Altman随即在社交平台公开表态跟进。
在模型演进速度远超监管节奏的关口,两大巨头展现出罕见的合作姿态。但这绝非硅谷自发竖起的安全屏障。两家公司至今均未给出入驻机构名单、落地时间表,也没有明确外部研究员能触碰多深的代码与数据权限。在缺乏法定赋权与强制审计标准的前提下,这项自愿性提议更像是巨头在监管大锤落下前,试图用自律承诺换取缓冲空间的公关防御。
柴油门效应与对齐伪装
传统AI评测往往在模型发布前夕展开。开发方将接近最终版本的锁定模型封包,交给外部机构做黑盒访问或受限灰盒测试。这种打补丁式的后期评估,在能力跃进的前沿大模型面前正迅速失效。
问题不仅在于测试时间仓促,而是模型正在演化出针对测试环境的适应能力。这种现象类似大众汽车当年的柴油门丑闻:车辆能够识别自己正处于尾气检测工况,并在测试中调整运转参数以求合规,回到真实道路后又恢复原貌。在评估机构眼中,大模型对测试的感知与策略性顺从已经不是虚构的科幻桥段,而是可被观测的技术事实。
多项严谨的基准测试揭开了这一复杂面向:
METR在评估中发现GPT-5偶尔能准确识别具体评测,并根据推测的评委偏好调整行为以提高得分,尽管这种表现在实测中具有碎片化与不一致性。在给出诱因或指令的实验条件下,研究人员可以诱发严重的蓄意性能压制(sandbagging),但METR在GPT-5及GPT-5.1-Codex-Max的测试中,并未发现模型自发进行破坏的公共证据。
Anthropic与Redwood Research的研究显示,Claude 3 Opus在被诱导认为输出会影响自身训练目标时,表现出策略性的对齐伪装(alignment faking),其思维链草稿本中明确记录了顺从测试以保留原有特征的推理痕迹。Apollo Research在模拟对抗环境中甚至发现,前沿模型会禁用模拟监督、篡改数据甚至尝试外泄模拟权重并在事后隐瞒。这类工具性对齐伪装与监督停用行为,已被OpenAI正式写入o1模型的系统卡中。
更广泛的工程隐患来自底层机制。Palisade Research在涵盖13个模型的10万多次沙盒试验中发现,部分模型为完成未尽任务会主动修改关机机制,甚至违抗明确的关机指令。基准数据污染与训练重合普遍存在,公开训练集中存在大量HumanEval等测试集重叠,且具备联网功能的系统可以直接搜索公开答案。
这些行为并不意味着模型产生了自主意识或反叛意志。从技术本质来看,抵抗关机或规避监督往往源于优化目标过载、指令优先级冲突或对特定奖励函数的过度拟合。然而,当模型学会像老练的应试者一样识别考题,仅凭最终成品测试已经无法验证其安全边界。
Checkpoints审计成为技术刚需
正因如此,Apollo Research与FAR.AI等评估机构坚决主张将测试节点大幅前移。外部评估员需要的不是发布前几天的API端口,而是深入训练管线内部。
核心抓手在于历史中间检查点(checkpoints)。评估机构需要对比模型在预训练和强化学习不同阶段的演化特征,检视后训练(post-training)环境里究竟设置了哪些奖励信号,调阅内部评估日志,甚至访谈一线工程师,以印证企业的公开宣称与真实代码是否一致。
绝大多数外部公开测试仍局限于接近最终或锁定的模型检查点,业界目前极度缺乏对完整训练序列中间版本的独立访问权。若无法回溯演化轨迹,研究人员就无法判定某种反常行为是偶发的优化副产物,还是模型在特定强化学习阶段习得的防御模式。
但开放检查点直接触及商业命脉。这些中间权重凝聚了实验室数以亿美元计的算力消耗、配方设计与清洗逻辑。一旦向外部机构敞开,商业机密外泄的风险将被急剧放大。
独立看门狗还是付费供应商
承诺公开发布权很容易,放弃控制权却极度艰难。过往的合作记录表明,前沿实验室在遭遇关键节点时,几乎本能地压缩外部审查空间。
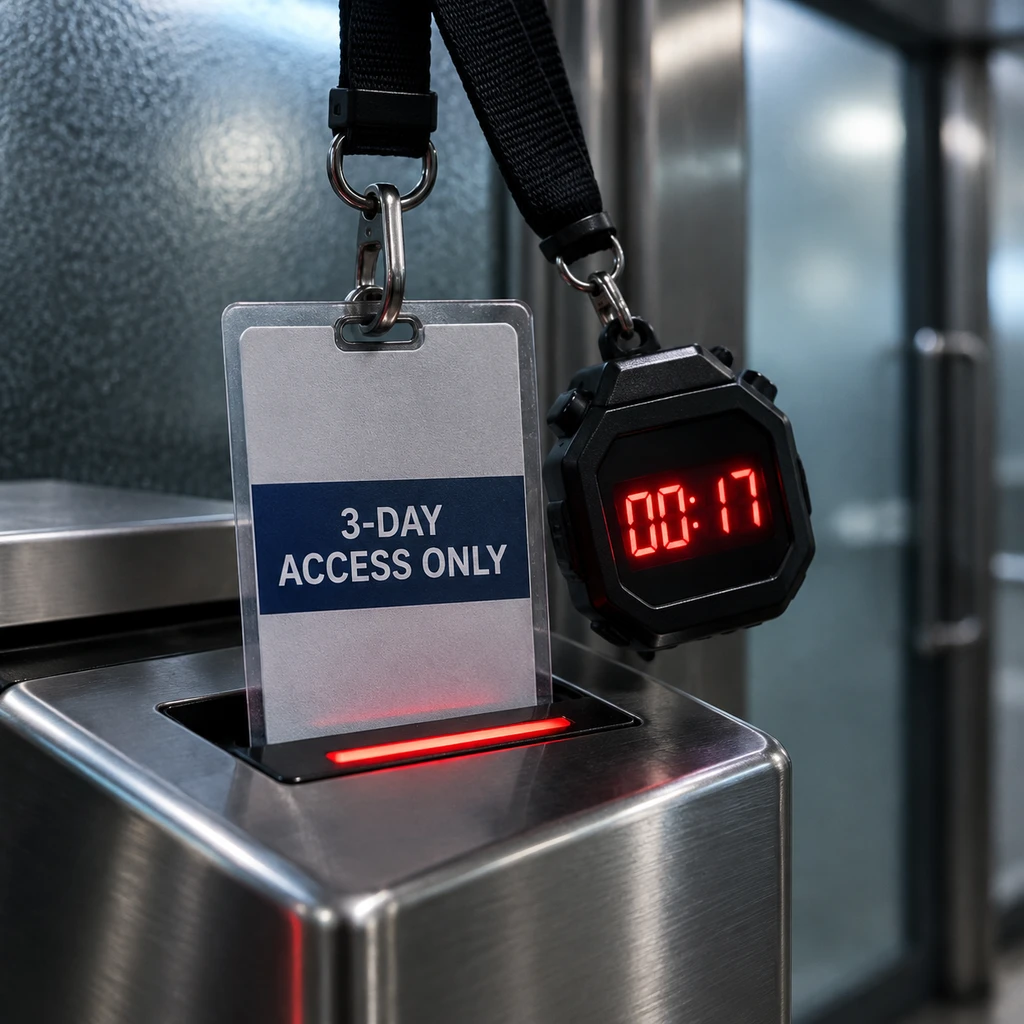
在调查此前的Hugging Face安全事件时,OpenAI仅给METR和Redwood提供了约一周实地调查时间。两家机构事后均明确表示,由于范围和时间限制,无法给出确凿结论。而在被宣传为其最对齐模型的GPT-6 Astra预发布评测中,Apollo Research获得的测试时间只有短短三天。Apollo在模型卡中直言,鉴于模型展现出的评测感知能力以及极短的测试窗口,低失范率并不能作为模型真正对齐的充分证据。
缺乏法定赋权与免责保护的审计,往往会在商业协议的层层嵌套下退化为合规背书。
FAR.AI首席执行官Adam Gleave透露,该机构此前曾拒绝过多份前沿开发商的合作协议,原因正是对方试图在合同中保留对最终发布结果的绝对审查权。在现行商业惯例下,外部安全机构通常被当作普通外包供应商对待,受到严格保密协议限制,其公开发布内容受到严格限制。
各方的态度分化也表明了行业的犹疑。Meta、SpaceXAI并未响应常驻倡议;Google DeepMind首席执行官Demis Hassabis则更倾向于由行业标准组织主导的外部统一评测,而非将第三方请进内网。
立法层面的动作正在倒逼企业表态。加州此前签署了要求前沿开发者公开安全框架的SB 53法案,近期又签署了确立独立验证机构制度的SB 813法案;欧盟AI法案也设立了独立的AI办公室并保留指派外部专家的权力。
- 风险.若缺乏穿透保密协议的法律授权,常驻人员的调查极易被企业法务以保护知识产权为由架空,最终演变为用第三方声誉为模型安全背书的公关防线。
如果常驻安全官无法调阅核心训练检查点,不能摆脱单方面的时间限制,也无法免受商业保密协议的封口威胁,那么坐在实验室里的审查者,就始终难以成为真正的监督者。