你在对话框里输入个人病症、财务隐私或法律咨询,厂商在服务协议里白纸黑字承诺绝不出售对话记录。大多数人以为只要模型权重安全、服务端不被拖库,这些字句就是安全的;但真实世界的漏洞往往发生在最平庸的角落。
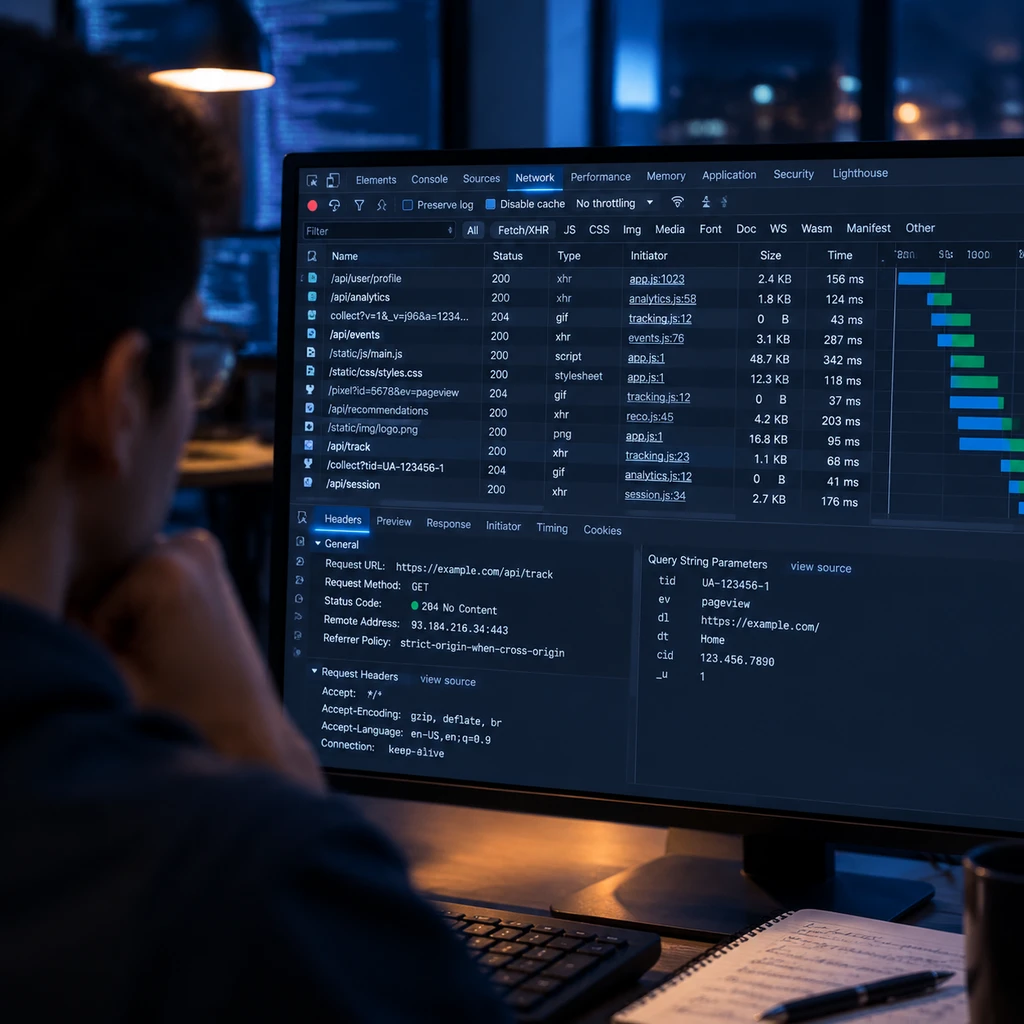
加州大学戴维斯分校(UC Davis)的研究人员 Muhammad Jazlan、Ethan Wang、Yash Vekaria 与 Zubair Shafiq 在近期提交并修订的一篇 arXiv 论文中,公布了一组令人不安的网络抓包结果。他们给 20款主流AI聊天机器人 注册全新测试账号,输入“pregnancy test near me”(附近早孕检测)这类高敏感提示词,监控其网页端的网络通信流量。
结果发现,20款产品中有 17款 会向至少一个独立第三方实体传输数据。整个测试一共捕获到 47 个独立第三方实体、178对通信关系。其中广告服务覆盖了 12 款产品,占据 73 对通信链条;分析监测服务则覆盖了 17 款。
受测对象几乎包揽了当前全部第一梯队工具:ChatGPT、Gemini、Claude、Grok、DeepSeek、Character.AI、Perplexity、Copilot、Manus、Kimi 均在名单之列。所谓坚不可摧的生成式 AI,在普通浏览器前端的审查下,底裤漏了个干干净净。
泄密的不是神经网络,而是平庸的前端代码
大众对 AI 泄密的直觉,往往停留在深奥的技术叙事上:模型在后训练阶段有没有记住我的数据?服务端数据库会不会遭遇高阶黑客攻击?
但这次实测表明,泄密的元凶根本不是复杂的模型结构,而是 Web 工程师几年前就烂熟于心的传统前端脚手架。AI 聊天机器人从来不是凭空浮现的原生安全客户端,它们绝大部分直接嫁接在上一代互联网的监控体系之上。
外泄的第一条路径是会话回放。Genspark、SeaArt 和 ChatOn 三款服务,在页面中直接嵌入了微软的会话录屏分析工具 Microsoft Clarity。这个脚本的作用是捕获用户在 DOM 树上的所有交互以还原操作轨迹。实测显示,用户的完整输入提示词、AI 吐出来的药店推荐甚至长篇角色扮演响应文本,以未经加密的明文形式被 Clarity 完整打包上传。不仅如此,Genspark 还直接把用户的完整提示词,作为地图搜索请求以明文发送给了 Google Maps。
第二条路径是网页元数据拼接。许多网页端为了交互体验,会把用户的第一句 Prompt 自动提炼为当前会话标题,顺手写入浏览器标签页的 Title 或 Open Graph 标签中。包括 Kimi、Claude、Manus、Gemini 和 Genspark 在内的产品,都将提示词或提炼出的关键词(如“pregnancy”)直接暴露在页面标题或元数据内。其中,Kimi 的提示词标题被页内加载的 Google DoubleClick 与 Google Ads 追踪接口顺手抄走。IMDEA Networks 的独立调查也发现了同样的硬伤:Grok 与 Perplexity 会向 Meta Pixel 发送完整的对话 URL,Grok 甚至通过 Open Graph 元数据向 TikTok 追踪器直接暴露了对话文本,且部分共享链接的访问权限控制极其薄弱。
第三条路径是用户身份的明文捆绑。有 15款 聊天机器人将带有对话标识符(chat identifiers)的 URL 扔给了第三方分析工具或社交媒体接口。SeaArt 将对话标识符同步发往 Facebook、Google、TikTok、Yandex、Outbrain、Quora 等 12 个外部目的地;Genspark 也分发给了 7 个目的地。
身份信息本身同样在外逃。Claude 和 Mistral 向客服插件 Intercom 传输了用户的注册邮箱、姓名、内部用户 ID 及哈希值;Character.AI 向报错组件 Sentry 与分析平台 Statsig 发送了包含邮箱、真实 IP 与 User-Agent 的组合包;Perplexity 向归因平台 Singular 同步了哈希邮箱,SeaArt 向 TikTok 广告像素传输了哈希邮箱;Meta 的广告追踪 Cookie(_fbp)则普遍潜伏在 Character.AI、Manus、Genspark 等界面的网络载荷里。
网络营销人员常拿“SHA-256 哈希已经脱敏”当挡箭牌。但在跨站追踪与设备指纹技术面前,确定性哈希恰恰是跨平台拉齐用户档案、把“某个匿名 IP 在深夜询问早孕试纸”与“某个真实邮箱用户”强力绑定的最佳锚点。
话术与现实:不出售不等于不泄露
面对公众质疑,各家厂商在合规条款里的用词向来滴水不漏。
OpenAI 官方政策明确声明,外部广告主绝不会拿到对话全文、记忆、姓名或 IP,但其免费和低阶版本允许基于当前对话乃至历史记忆在内部匹配广告;Anthropic 声明 Claude 界面绝不投放广告、不对用户建立营销画像,但其隐私政策允许使用个人数据为自家的其他服务进行定向推广;Google 则声明当前未将 Gemini Apps 的对话直接用于广告展示。
门禁修得坚不可摧,后墙却挂着售票窗口;合规文本管住了大门,前端组件敞开了后门。
这些声明在字面上或许没有撒谎。OpenAI 和 Anthropic 确实没有建立一个“把你的提示词打包装箱、明码标价卖给广告代理商”的批发后台。但这种法务修辞巧妙避开了工程现实。
第三方追踪代码并非外部黑客偷运进来的,正是各家产品团队自己打包进前端静态资源里的。为了监控页面崩溃,工程团队接了 Sentry;为了看用户在哪一步跳出,产品经理装了 Clarity;为了投流转化与买量归因,增长团队插了 Meta Pixel 与 TikTok Pixel;为了客服沟通,运营团队嵌入了 Intercom。
部门各自背负指标,代码层层叠加上线,法务在办公室里推敲着“我们不出售数据”的字眼,浏览器已经在向几十个第三方服务器打卡报到。当高敏感的 AI 对话遇到毫无遮掩的传统 Web 埋点,所谓模型安全就成了一纸空文。
真正具有讽刺意味的对照出现在私密模式测试中。在提供临时聊天(Temporary Chat)或私密模式的 7 款工具里,第三方通信关系瞬间从百余对断崖式跌落至 13对,第三方实体只剩下基础的运维监控或地图服务(Datadog、Mapbox、Google),此前广泛存在的身份与提示词泄露无一出现。
这直接戳破了厂商借口技术复杂度的说辞。产品团队完全清楚怎么把追踪脚本拔除干净,临时模式能做到,常规模式做不到,本质上只是一场商业计算:在常规交互中保留这些脚本,能换来清晰的漏斗转化、用户画像沉淀与跨站归因收益。
- 风险.只要你还在使用默认窗口与 AI 对话,就应默认对话框里的每行字,都可能被会话回放插件与追踪像素同步收录,切勿在常规网页端输入医疗诊断、财务账号或未公开商业机密。
天下熙熙,皆为利来。十年前移动互联网借由免费应用收集位置与通讯录,如今生成式 AI 顶着科技突破的光环,私下里依然摆脱不了对监控资本主义旧秩序的依赖。当你在深夜推敲一句隐秘的求助时,屏幕那头除了算力集群,挤满的依然是那些熟悉的面孔。