FlashAttention-4 有一处缺陷可能让本该参与计算的注意力块被整个跳过。FlashAttention 上游议题 #3195 的报告者把问题指向归约缓冲区的数据竞争,并称项目测试没有捕获它。哥伦比亚大学与 CertiK 的研究人员推出 TensorLean,把检查放到 NVIDIA GPU 内核编译后的 PTX 层。它补的是测试的一处盲区:测试只能观测跑过的调度,证明可以检查模型允许、却未必在测试中出现的执行顺序。
TensorLean 的 38 个缺陷按问题计,不按实例计
研究团队评估了 149 个实例,涵盖 FlashAttention-2、-3、-4 和 DeepGEMM 等项目。其中 83 个通过证明;其余 66 个实例的检查共引出 38 个缺陷报告,涉及 6 个项目,FlashAttention 占 23 个。实例和缺陷用的是两套口径。读者不能把每个未证实例都算成一个独立缺陷,也不能仅凭汇总数判断每项未证结果如何归因。
按 #3195 的描述,竞争可能让内核误以为某个块没有需要纳入计算的键,于是跳过仍含未屏蔽键的块。这里漏掉的是一部分计算,和浮点舍入造成的微小偏差不同。项目方另称,一处 FlashAttention-4 数据竞争在 17,760 次测试运行中未出现。现有材料不足以确认它就是 #3195,也不能仅凭议题记录认定维护者已确认或合并修复。
PTX 层证明管到哪里
GPU 内核会让数据搬运、计算和归约重叠执行。TensorLean 先用 Lean 分别写清张量运算、内存布局、输入前提和输出容差,再对编译生成的 PTX 检查线程之间必须遵守的先后关系。它在模型内证明内核没有数据竞争、能够终止,再核对最终结果是否落在容差内、约定范围外的内存是否保持不变。
检查编译产物的好处是,源代码生成 PTX 时引入的偏差也有机会被发现。但结论只在规格与模型内成立。规格写错、输入不符合前提,或指令行为超出 PTX 模型覆盖范围,证明就不能替这些情况背书。后续机器码生成和实际硬件执行也不自动纳入结论。
安全、实数等价与浮点容差各有标准
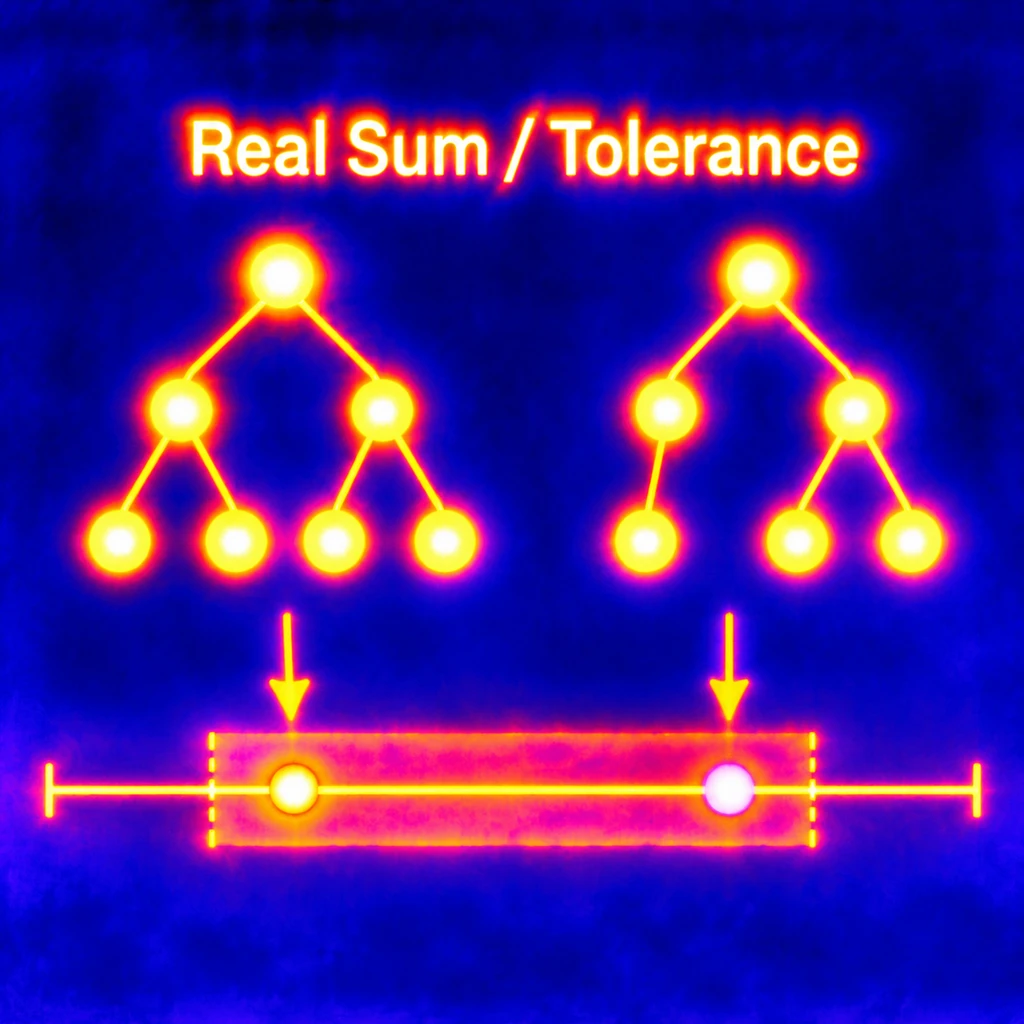
VOLTA 也在 PTX 层工作。它比较参考内核和优化后内核,并在支持的模型内检查数据竞争与死锁。但它把浮点值当作实数,因此实数等价并不保证 IEEE 浮点舍入后的结果,也不回答数值稳定性问题。GPU 内核改写累加顺序后,即使数学表达式等价,浮点结果仍可能不同。TensorLean 核对的是这种差异能否落在事先约定的容差内。
ProofWright 报告的 KernelBench L1 生成内核验证率为 74%,说的是安全检查,不是完整数值等价;论文另对一类逐元素内核证明了语义等价。SF Tensor 的 PTX-in-Lean 工作则侧重形式化 PTX 内存模型,公开案例的证明由人工完成或借助大模型完成,也依赖模型假设。几项工作回答的问题不同,通过率和耗时不能直接排成榜单。
部署能否采信,取决于第三方能否复跑
报道引用了 GitHub README,也给出了仓库链接;另一则公告转述却称论文和开源发布仍待推出。仓库可访问与完整验证材料已经公开是两回事。现有材料不足以确认第三方能否拿到可复跑材料,包括规格、确切的 PTX 产物、证明脚本和日志,并用它们复核代表性的通过项和缺陷项。
FlashAttention 和 DeepGEMM 的维护者可以用报告补回归测试,但把验证纳入发版,还要算上写规格、补证明提示和改动后重跑的成本。训练和推理框架的集成方更关心另一笔账:线上使用的 GPU 与配置、编译产物和输入条件是否落在证明范围内。升级决策要看对应版本的修复与回归记录,库名出现在验证名单上还不够。