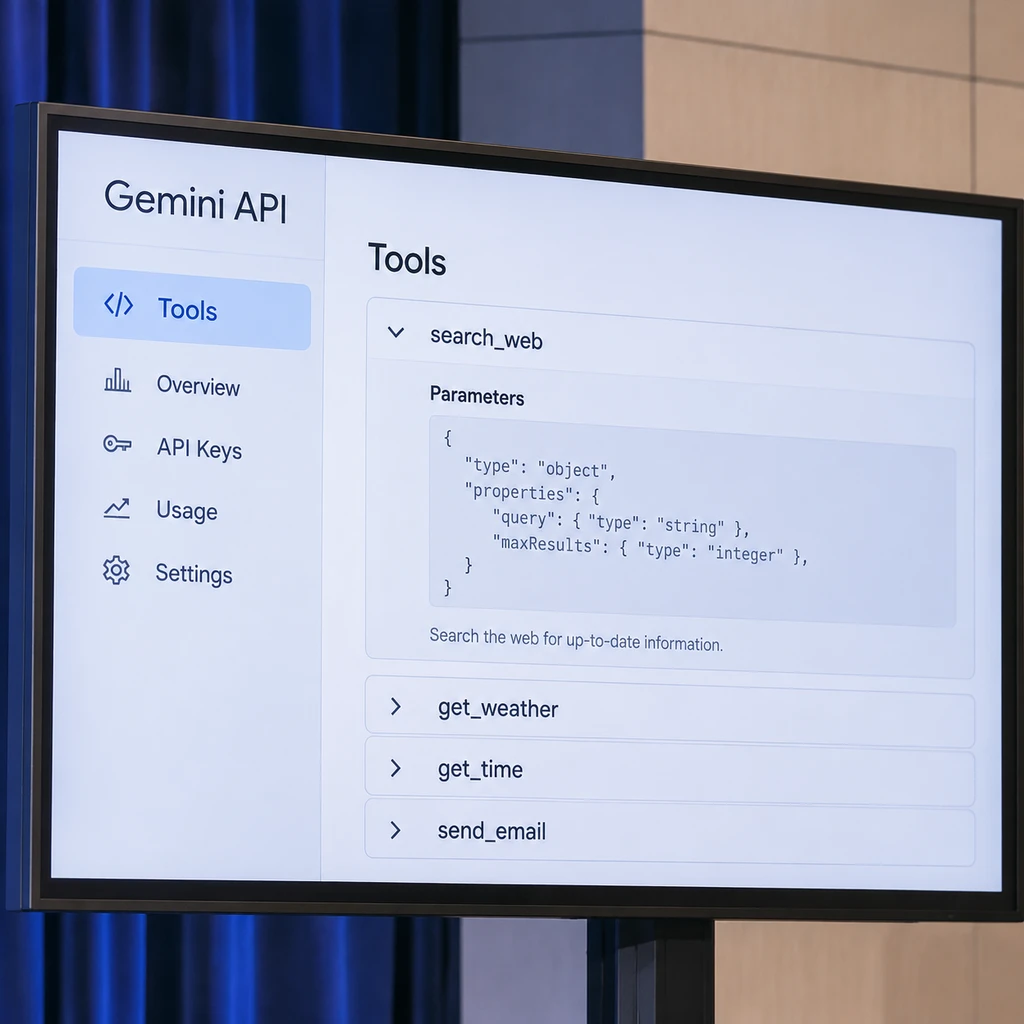
2026 年 11 月 19 日,Google 在 Gemini API 的 Interactions API 中预览 Tool Retrieval,支持 Gemini 3.6 及后续模型,包括所有 Gemini 4 模型。这个功能让模型用到某个工具时再加载它的参数定义,但工具名和描述照样可见。所以,工具库大不大,还真不如看它到底大在哪儿。
Google 的托管检索省掉了自建检索的集成工作;它也支持客户端检索,代价是多一次往返。OpenAI 同样区分托管和客户端检索,Anthropic 则提供正则、BM25 和自定义检索。Google 公告没给出量化基准,也没明确延迟加载工具数或检索结果数的上限。选项可以对照,省多少、谁更准,目前排不出名次。
瘦下来的是参数定义
拿客服查订单举例。全量加载时,模型收到的不只是查订单的参数定义,还有退款、改地址等这次用不上的工具定义。启用 defer_loading: true 后,模型依然能看到这些工具叫什么、能做什么,但只在需要时加载参数定义,也就是 schema。
<svg viewBox='0 0 600 224' width='100%' height='224' role='img' aria-label='全量加载与按需加载的区别,工具名和描述都可见,只有参数定义改为按需加载'>
<rect x='1' y='1' width='598' height='222' rx='8' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='28' y='36' font-size='20' font-weight='700' fill='#b25a3a'>目录照传,参数按需</text>
<line x1='28' y1='51' x2='572' y2='51' stroke='#e2dccf' stroke-width='1'/>
<rect x='28' y='72' width='262' height='124' rx='6' fill='#fbf9f4' stroke='#e2dccf'/>
<rect x='310' y='72' width='262' height='124' rx='6' fill='#fbf9f4' stroke='#e2dccf'/>
<text x='48' y='103' font-size='17' font-weight='700' fill='#2c2822'>全量加载</text>
<text x='330' y='103' font-size='17' font-weight='700' fill='#2c2822'>按需加载</text>
<text x='48' y='139' font-size='15' fill='#7a7266'>工具名和描述可见</text>
<text x='330' y='139' font-size='15' fill='#7a7266'>工具名和描述可见</text>
<text x='48' y='171' font-size='15' fill='#2c2822'>全部参数定义</text>
<text x='330' y='171' font-size='15' font-weight='700' fill='#b25a3a'>仅加载所需参数</text>
</svg>
Tool Retrieval 不单独收费,但检索有少量固定输入 token 开销,加载进来的 schema 也按输入 token 计费。真正省下的是没加载的 schema,还得扣掉检索和可能的重试。工具的参数复杂、每次只用其中少数几个,才有较大的节省空间。要是目录主要长在描述上,或者一件事经常要串联多个大 schema,光数工具个数没什么用。
少给几个选项,可能更准,也可能漏掉正解
全量加载不会在检索这一步漏掉正确工具,但一堆名字相似的工具摆在一起,模型照样会选错。Anthropic 在自家的 MCP 评估中,把 Opus 4 的工具选择准确率从 49% 提到了 74%。这说明在那套配置里,缩小候选范围有用;它不能当作 Gemini 的成绩,也不能换算成整件事的办成率。
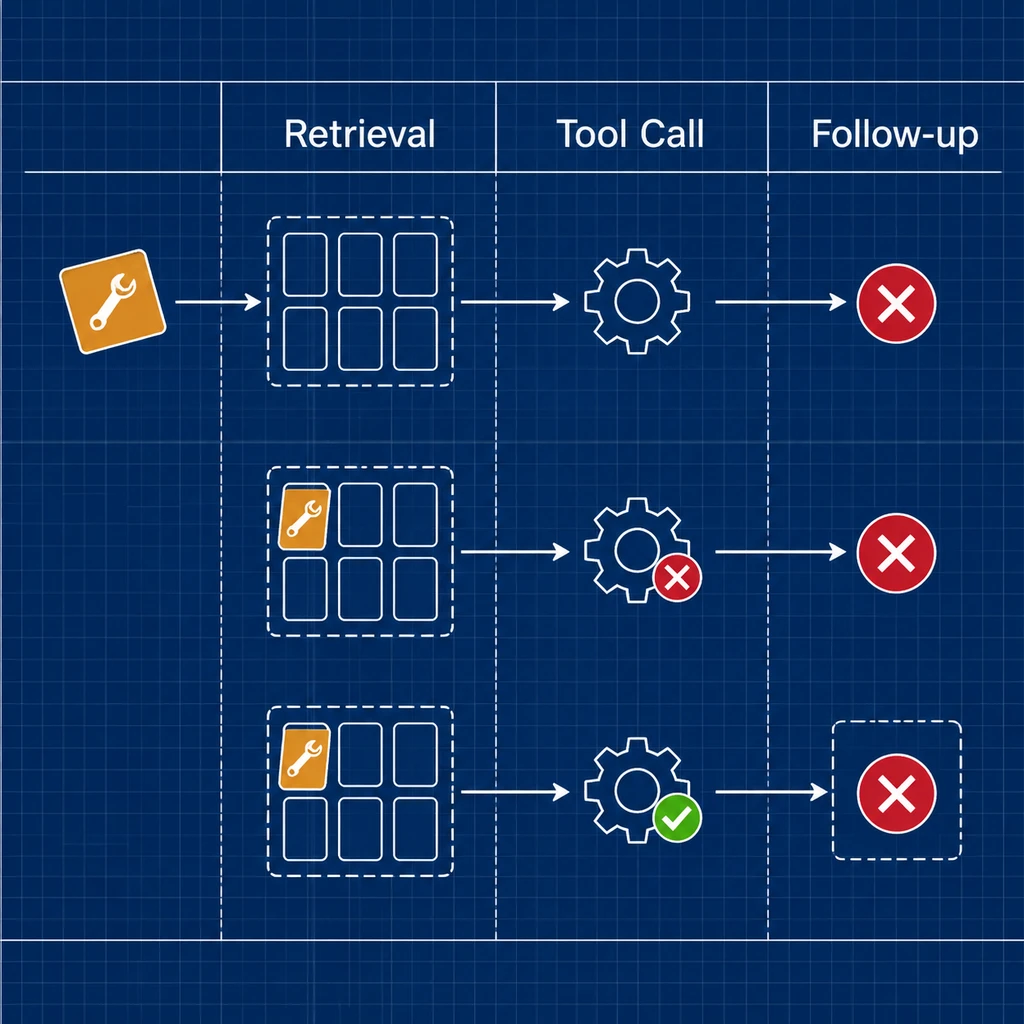
ToolRet 评估覆盖 7,600 项任务及 43,000 个工具,表现最好的受测模型 nDCG@10 为 33.83。论文还发现,较弱的检索会拖累下游任务成功率;但这项评估不是 Gemini、Anthropic 和 OpenAI 托管产品的横评(来源:arxiv.org)。
我更在意的是失败发生在哪一步。该用的工具没进候选,问题在检索;找到了却选错工具或填错参数,问题在调用;调用都对,任务还是没办成,就得查后续步骤。把这些都记成一次失败,团队很容易在漏检时换模型,或者在流程没走完时一味扩大候选范围。
迁不迁,拿同一批任务算账
用同一模型、同一工具库和同一批请求,对照全量加载、托管检索和客户端检索。把不用工具、容易混淆相似工具、需要串联多个工具的请求分开看。成本用总输入 token 除以成功任务数,失败和重试也算进分子;延迟除了看中位数,还看 p95 延迟。最慢的一批请求,往往才看得出检索和回退花了多少时间。
多租户系统还有一道门槛。如果候选范围必须随租户权限或应用状态变化,客户端检索更便于应用自行筛选,执行时仍要校验授权。即使托管版更省接入工时,也不能把候选名单当权限名单。
如果省下的 token 大多来自原本就不用调工具的请求,而最难的多工具任务更容易漏检、回退,平均账单再好看,我也不会全量切换。先保留全量加载基线,把按需加载用在那些参数定义够重、候选又好区分的任务上。